
[pytorch] 官网教程+注释
pytorch官网教程+注释
Classifier
import torch

import torchvision

import torchvision.transforms as transforms
transform = transforms.Compose(

    [transforms.ToTensor(),

     transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

trainset = torchvision.datasets.CIFAR10(root='./data', train=True,

                                        download=True, transform=transform)

trainloader = torch.utils.data.DataLoader(trainset, batch_size=3,

                                          shuffle=True, num_workers=2)

testset = torchvision.datasets.CIFAR10(root='./data', train=False,

                                       download=True, transform=transform)

testloader = torch.utils.data.DataLoader(testset, batch_size=3,

                                         shuffle=False, num_workers=2)

classes = ('plane', 'car', 'bird', 'cat',

           'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
Files already downloaded and verified

Files already downloaded and verified
import matplotlib.pyplot as plt

import numpy as np

def imshow(img):

    img = img/2 + 0.5 # 因为之前标准化的时候除以0.5就是乘以2,还减了0.5,所以回复原来的亮度值

    npimg = img.numpy()

    plt.imshow(np.transpose(npimg,(1,2,0))) #  c,h,w -> h,w,c

    plt.show()

dataiter = iter(trainloader)

images,labels = dataiter.next()

print(images.shape) #torch.Size([4, 3, 32, 32]) bchw

print(torchvision.utils.make_grid(images).shape) #torch.Size([3, 36, 138])

#imshow(torchvision.utils.make_grid(images)) # 以格子形式显示多张图片

#print(" ".join("%5s"% classes[labels[j]] for j in range(4)))
torch.Size([3, 3, 32, 32])

torch.Size([3, 36, 104])
import torch.nn as nn

import torch.nn.functional as F

class Net(nn.Module):

    def __init__(self):

        super(Net,self).__init__()

        self.conv1 = nn.Conv2d(3,6,5)

        self.pool = nn.MaxPool2d(2,2)

        self.conv2 = nn.Conv2d(6,16,5)

        self.fc1 = nn.Linear(16*5*5,120)

        self.fc2 = nn.Linear(120,84)

        self.fc3 = nn.Linear(84,10)

    def forward(self,x):

        x = self.pool(F.relu(self.conv1(x)))

        x = self.pool(F.relu(self.conv2(x)))

        x = x.view(-1,16*5*5)

        x = F.relu(self.fc1(x))

        x = F.relu(self.fc2(x))

        x = self.fc3(x)

        return x

net = Net()
import torch.optim as optim

criterion = nn.CrossEntropyLoss()

optimizer = optim.SGD(net.parameters(),lr = 0.001,momentum = 0.9)
for epoch in range(2):

    running_loss = 0.0

    for i,data in enumerate(trainloader):

        inputs,labels = data

        optimizer.zero_grad()

        outputs = net(inputs)

        loss = criterion(outputs,labels)

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        if i%2000 ==1999:

            print('[%d,%5d] loss:%.3f'%(epoch+1,i+1,running_loss/2000))

            running_loss = 0.0

print("finished training")
[1, 2000] loss:1.468

[1, 4000] loss:1.410

[1, 6000] loss:1.378

[1, 8000] loss:1.363

[1,10000] loss:1.330

[1,12000] loss:1.299

[2, 2000] loss:1.245

[2, 4000] loss:1.217

[2, 6000] loss:1.237

[2, 8000] loss:1.197

[2,10000] loss:1.193

[2,12000] loss:1.196

finished training
dataiter = iter(testloader)

images,labels = dataiter.next()

imshow(torchvision.utils.make_grid(images))

outputs = net(images)

_,predicted = torch.max(outputs,1)

print("predicted"," ".join([classes[predicted[j]] for j in range(4)]))
predicted cat ship ship ship
correct = 0

total = 0

with torch.no_grad():

    for data in testloader:

        images,labels = data

        outputs = net(images)

        _,predicted = torch.max(outputs.data,1)

        total += labels.size(0) # 等价于labels.size()[0]

        correct+= (predicted==labels).sum().item()

print("acc:{}%%".format(100*correct/total))
acc:56.96%%
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(device)
cpu
net.to(device)
Net(

  (conv1): Conv2d(3, 6, kernel_size=(5, 5), stride=(1, 1))

  (pool): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)

  (conv2): Conv2d(6, 16, kernel_size=(5, 5), stride=(1, 1))

  (fc1): Linear(in_features=400, out_features=120, bias=True)

  (fc2): Linear(in_features=120, out_features=84, bias=True)

  (fc3): Linear(in_features=84, out_features=10, bias=True)

)
DataLoading And Processing
from __future__ import print_function,division

import os

import torch

import pandas as pd

import numpy as np

import matplotlib.pyplot as plt

from torch.utils.data import Dataset,DataLoader

from torchvision import transforms,utils

import warnings

from skimage import io,transform

warnings.filterwarnings("ignore")

plt.ion()
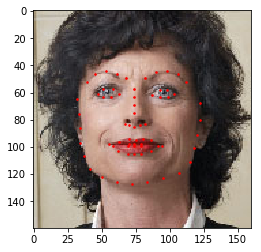
landmarks_frame = pd.read_csv("data/faces/face_landmarks.csv") # name x y x y ...

#print(landmarks_frame.columns.tolist())

n = 65 # 第65个样本

img_name = landmarks_frame.iloc[n,0]# 第65个样本的文件名

#print(img_name)

#print(landmarks_frame.iloc[n,1:])

landmarks = landmarks_frame.iloc[n,1:].as_matrix()# 第65个样本的样本值向量

#如果不加上as_matrix的结果就是feature name + feature val,加了之后只有feature val

#print(landmarks)

landmarks = landmarks.astype('float').reshape(-1,2) # 两个一组,组成两列的矩阵
def show_landmarks(image,landmarks):

    plt.imshow(image)

    plt.scatter(landmarks[:,0],landmarks[:,1],s=10,marker='.',c='r')

    #plt.pause(0.001) # python 窗口用得着
plt.figure()

show_landmarks(io.imread(os.path.join("data/faces/",img_name)),landmarks)
# torch.utils.data.Dataset 是一个抽象类,我们的dataset需要继承这个类,才能对其进行操作

class FaceLandmarksDataset(Dataset):

    def __init__(self,csv_file,root_dir,transform=None):

        self.landmarks_frame = pd.read_csv(csv_file)

        self.root_dir = root_dir

        self.transform = transform

    def __len__(self):

        return len(self.landmarks_frame)

    def __getitem__(self,idx):

        img_name = os.path.join(

            self.root_dir,

            self.landmarks_frame.iloc[idx,0]

        )

        image = io.imread(img_name)

        landmarks = self.landmarks_frame.iloc[idx,1:].as_matrix()

        landmarks = landmarks.astype('float').reshape([-1,2])

        sample = {"image":image,"landmarks":landmarks}

        if self.transform:

            sample = self.transform(sample)

        return sample
face_dataset = FaceLandmarksDataset(csv_file='data/faces/face_landmarks.csv',root_dir='data/faces/')

fig = plt.figure()

for i in range(len(face_dataset)):

    sample = face_dataset[i]

    print(i,sample['image'].shape,sample['landmarks'].shape)

    ax = plt.subplot(1,4,i+1)

    #plt.tight_layout()

    ax.set_title("sample #{}".format(i))

    ax.axis("off")

    show_landmarks(**sample) #**为python 拆包,将dict拆解为x=a,y=b的格式

    if i==3:

        plt.show()

        break
0 (324, 215, 3) (68, 2)

1 (500, 333, 3) (68, 2)

2 (250, 258, 3) (68, 2)

3 (434, 290, 3) (68, 2)

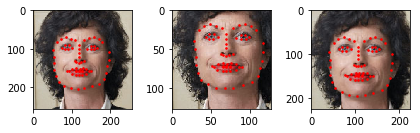
class Rescale():

    def __init__(self,output_size):

        assert isinstance(output_size,(int,tuple)) # 必须是int或tuple类型,否则报错,要习惯用assert isinstance

        self.output_size = output_size

    def __call__(self,sample): # 这个类的对象是一个函数,所以定义call

        image,landmarks = sample['image'],sample['landmarks']

        h,w = image.shape[:2]

        if isinstance(self.output_size,int): # 如果只输入了一个值,则以较短边为基准保持长宽比率不变变换

            if h>w:

                new_h,new_w = self.output_size*h/w,self.output_size

            else:

                new_h,new_w = self.output_size,self.output_size*w/h

        else: #给定一个size那就直接变成这个size

            new_h,new_w = output_size

        new_h,new_w = int(new_h),int(new_w)

        img = transform.resize(image,(new_h,new_w)) # 进行resize操作,调用的是skimage的resize,提供(h,w),跟opencv相反

        landmarks = landmarks * [new_w/w,new_h/h]# 相应的,landmark也要做转换

        return {"image":img,"landmarks":landmarks} # 返回dict

class RandomCrop():

    def __init__(self,output_size):

        assert isinstance(output_size,(int,tuple))

        if isinstance(output_size,int):

            self.output_size = (output_size,output_size)

        else:

            assert len(output_size) ==2

            self.output_size = output_size

    def __call__(self,sample):

        image,landmarks = sample['image'],sample['landmarks']

        h,w = image.shape[:2]# 原图宽高

        new_h,new_w = self.output_size # 裁剪的宽高

        top = np.random.randint(0,h-new_h) # 裁剪输出图像最上端

        left = np.random.randint(0,w-new_w) # 最左端,保证取的时候不越界

        image = image[top:top+new_h,left:left+new_w] # 随机裁剪

        landmarks = landmarks - [left,top] # 这里landmarks同样也需要做变换,之所以减去[left,top]是因为存储的是x,y对应的轴是w轴和h轴

        return {"image":image,"landmarks":landmarks}

class ToTensor():

    def __call__(self,sample):

        image,landmarks = sample['image'],sample['landmarks']

        image = image.transpose((2,0,1)) # transpose实质是reshape

        # skimage的shape [h,w,c]

        # torch的shape [c,h,w]

        return {"image":torch.from_numpy(image),"landmarks":torch.from_numpy(landmarks)}
scale = Rescale(256)

crop = RandomCrop(128)

composed = transforms.Compose([Rescale(256),RandomCrop(224)]) # 组合变换

fig = plt.figure()

sample = face_dataset[65]

for i,tsfrm in enumerate([scale,crop,composed]): # 三种变换

    transformed_sample = tsfrm(sample) # 应用其中之一

    ax = plt.subplot(1,3,i+1)

    plt.tight_layout()

    show_landmarks(**transformed_sample)

plt.show()
transformed_dataset = FaceLandmarksDataset(csv_file = 'data/faces/face_landmarks.csv',

                                           root_dir="data/faces/",

                                           transform=transforms.Compose(

                                               [

                                                   Rescale(256),

                                                   RandomCrop(224),

                                                   ToTensor()

                                               ])

                                          )

for i in range(len(transformed_dataset)):

    sample = transformed_dataset[i]

    print(i,sample['image'].size(),sample['landmarks'].size())

    if i==3:

        break
0 torch.Size([3, 224, 224]) torch.Size([68, 2])

1 torch.Size([3, 224, 224]) torch.Size([68, 2])

2 torch.Size([3, 224, 224]) torch.Size([68, 2])

3 torch.Size([3, 224, 224]) torch.Size([68, 2])
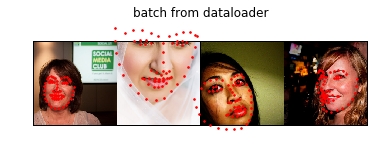
dataloader = DataLoader(transformed_dataset,batch_size=4,shuffle=True,num_workers=4) # 调用dataloader

def show_landmarks_batch(sample_batched):

    images_batch,landmarks_batch = sample_batched['image'],sample_batched['landmarks']

    batch_size = len(images_batch)

    im_size = images_batch.size(2) #这里的size是shape

    grid = utils.make_grid(images_batch) # 多张图变成一张图

    plt.imshow(grid.numpy().transpose(1,2,0)) # reshape到能用plt显示

    for i in range(batch_size):

        # 第i张图片的所有点的x,所有点的y,后面 + i*im_size是由于所有图像水平显示,所以需要水平有个偏移

        # 转numpy是因为torch类型的数据没办法scatter

        plt.scatter(landmarks_batch[i,:,0].numpy() + i*im_size,

                   landmarks_batch[i,:,1].numpy(),

                   s=10,marker='.',c='r')

        plt.title("batch from dataloader")

for i_batch,sample_batched in enumerate(dataloader):

    if i_batch ==3:

        plt.figure()

        show_landmarks_batch(sample_batched)

        plt.axis("off") # 关闭坐标系

        plt.ioff()

        plt.show()

        break
<built-in method size of Tensor object at 0x7f273f3bad38>
[pytorch] 官网教程+注释的更多相关文章
- 训练DCGAN(pytorch官网版本)
将pytorch官网的python代码当下来,然后下载好celeba数据集(百度网盘),在代码旁新建celeba文件夹,将解压后的img_align_celeba文件夹放进去,就可以运行代码了. 输出 ...
- Unity 官网教程 -- Multiplayer Networking
教程网址:https://unity3d.com/cn/learn/tutorials/topics/multiplayer-networking/introduction-simple-multip ...
- MongoDB 官网教程 下载 安装
官网:https://www.mongodb.com/ Doc:https://docs.mongodb.com/ Manual:https://docs.mongodb.com/manual/ 安装 ...
- ECharts概念学习系列之ECharts官网教程之在 webpack 中使用 ECharts(图文详解)
不多说,直接上干货! 官网 http://echarts.baidu.com/tutorial.html#%E5%9C%A8%20webpack%20%E4%B8%AD%E4%BD%BF%E7%94% ...
- ECharts概念学习系列之ECharts官网教程之自定义构建 ECharts(图文详解)
不多说,直接上干货! 官网 http://echarts.baidu.com/tutorial.html#%E8%87%AA%E5%AE%9A%E4%B9%89%E6%9E%84%E5%BB%BA%2 ...
- KnockoutJs官网教程学习(一)
这一教程中你将会体验到一些用knockout.js和Model-View-ViewModel(MVVM)模式去创建一个Web UI的基础方式. 将学会如何用views(视图)和declarative ...
- scrapy1_官网教程
https://scrapy-chs.readthedocs.io/zh_CN/0.24/intro/tutorial.html 本篇文章主要介绍如何使用编程的方式运行Scrapy爬虫. 在开始本文之 ...
- Unreal Engine 4官网教程
编辑器纵览 https://www.unrealengine.com/zh-CN/blog/editor-overview 虚幻编辑器UI布局概述 https://www.unrealengine.c ...
- Postman 官网教程,重点内容,翻译笔记,
json格式的提交数据需要添加:Content-Type :application/x-www-form-urlencoded,否则会导致请求失败 1. 创建 + 测试: 创建和发送任何的HTTP请求 ...
随机推荐
- oracle Clob类型转换成String类型
转载:https://www.cnblogs.com/itmyhome/p/4131339.html Clob类型转换成String类型 oracle中表结构如下: create table GRID ...
- HIVE分析函数
ROWS BETWEEN含义,也叫做WINDOW子句: PRECEDING:往前 FOLLOWING:往后 CURRENT ROW:当前行 UNBOUNDED:起点,UNBOUNDED PRECEDI ...
- vue常见依赖安装
1):$ npm install less less-loader --save 2)style里 <style lang='less'> 2): $ npm i vue-resource ...
- my.资料
领回梦丹 http://ka.gamedog.cn/card/2036517.html 1. 普陀的加点没有优点缺点之分,只有是否和你的装备般配.这里可以给一些小数据参考. 60级物理防御达到900, ...
- Access restriction: The type Base64 is not accessible due to restriction on
java build path>把libraries中的JRE System Library删除重新导入.
- shell 终端字符颜色
终端的字符颜色是用转义序列控制的,是文本模式下的系统显示功能,和具体的语言无关,shell,python,perl等均可以调用. 转义序列是以 ESC 开头,可以用 \033 完成相同的工作(ESC ...
- Django重新整理
1.母版的继承 #base<!DOCTYPE html> <html lang="zh-CN"> <head> <meta charset ...
- (转)ping命令
ping命令 原文:https://www.cnblogs.com/peida/archive/2013/03/06/2945407.html Linux系统的ping命令是常用的网络命令,它通常用来 ...
- windows 7下安装MySQL5.6
一. 软件下载 从MySql官网上下载响应的版本,我的是5.6.17. 二.安装过程 以管理员权限运行安装程序,收集信息. 选择安装MySql产品,如果之前有安装过,那么就选择更新了. 同意Licen ...
- 在项目引用里添加上对Microsoft Word 11.0 object library的引用
private void button1_Click(object sender, System.EventArgs e) { //调用打开文件对话框获取要打开的文件WORD文件,RTF文件,文本文件 ...