
海量推荐系统:mapreduce的方法
1. Motivation
2. MapReduce
MapReduce是一种数据密集型并行计算框架。
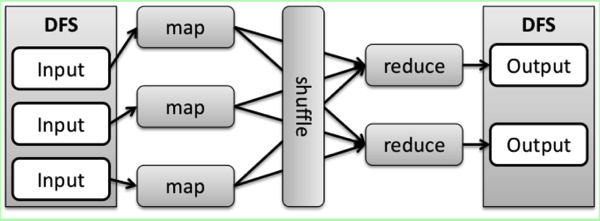
待处理数据以“块”为单位存储在集群机器文件系统中(HDFS),并以(key, value)的键值对形式保存。
当任务启动时,系统将计算任务分配给存储数据的相应机器。
MapReduce计算任务可以划分为两个阶段:
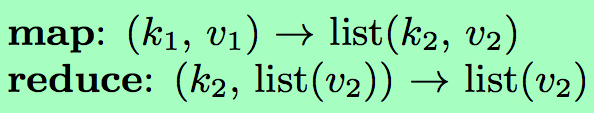
MapReduce数据流图
3. scalable similarity-based neighborhood
3.1 user-based 推荐
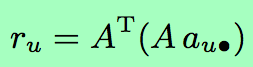
说明:
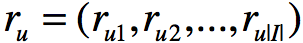 :user对商品的评分
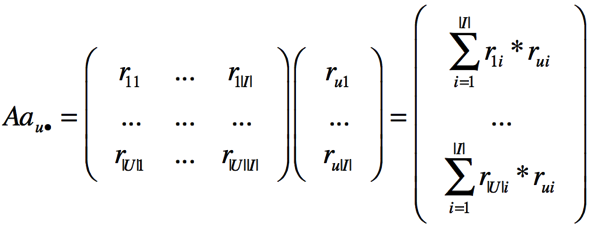 :得到了用户u与其他用户的相似度
最后,对于某一商品i,根据其他用户的评分以及用户相似度加权和来得到本用户的预测评分。
之所以称之为user-based方法,算法基于计算用户间的相似度。
3.2 item-based推荐
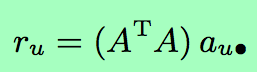
说明:
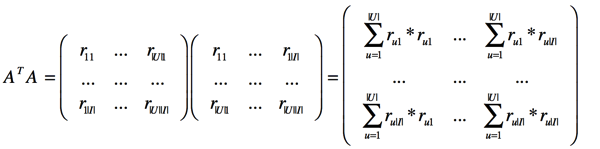
得到了物品的相似度矩阵。最后,用户u对物品i的打分就等于用户对物品的打分与物品i相似度的加权和。
因此,推荐系统的核心在于计算相似度矩阵
3.3 scalable计算方法
传统的相似度计算,基于标准的矩阵乘法。
不足之处:
1、在每一个map任务中,要初始化评分矩阵A,map时将输入的item与A的每一列做点乘。当矩阵A巨大时,内存消耗巨大。
2、传统计算方法复杂度与item数的平方成正比。并且,不能利用user评分稀疏性的性质。
改进的方法
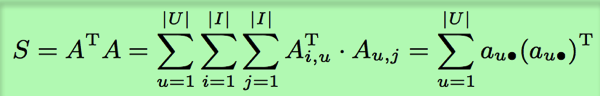
其中, 为列向量,为用户u的打分向量
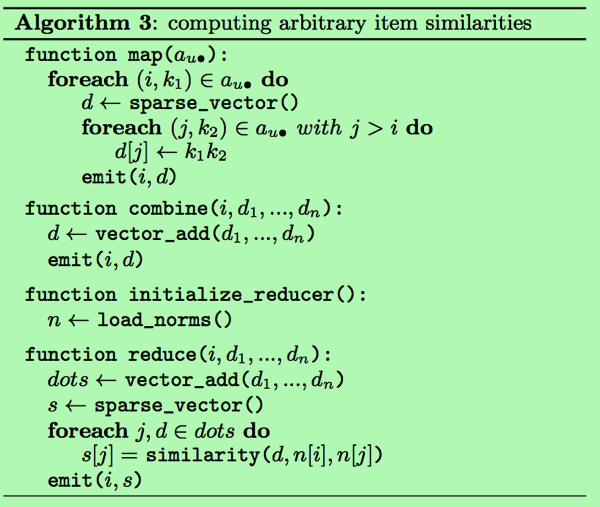
具体方法:
首先对每一个用户的评分向量做乘积。
然后将这些乘积相加,就得到了相似度矩阵。这样,就可以以A的行向量为单位进行数据的划分。
mapreduce计算框架
参考文献:
[1] Scalable Similarity-Based Neighborhood Methods with MapReduce
海量推荐系统:mapreduce的方法的更多相关文章
- SQL join中级篇--hive中 mapreduce join方法分析
1. 概述. 本文主要介绍了mapreduce框架上如何实现两表JOIN. 2. 常见的join方法介绍 假设要进行join的数据分别来自File1和File2. 2.1 reduce side jo ...
- LBS推荐系统的设计方法
https://www.csdn.net/article/2015-12-24/2826554 http://www.datayuan.cn/article/14797.htm https://my. ...
- 海量数据挖掘MMDS week4: 推荐系统之隐语义模型latent semantic analysis
http://blog.csdn.net/pipisorry/article/details/49256457 海量数据挖掘Mining Massive Datasets(MMDs) -Jure Le ...
- 海量数据挖掘MMDS week4: 推荐系统Recommendation System
http://blog.csdn.net/pipisorry/article/details/49205589 海量数据挖掘Mining Massive Datasets(MMDs) -Jure Le ...
- C#版的MapReduce
如果不知道MapReduce是怎么工作的,请看这里,如果不知道MapReduce是什么,请google之! 今天“闲”来无事,忽想起C#里没有MapReduce的方法,构思之,coding之: #re ...
- 《OD大数据实战》MapReduce实战
一.github使用手册 1. 我也用github(2)——关联本地工程到github 2. Git错误non-fast-forward后的冲突解决 3. Git中从远程的分支获取最新的版本到本地 4 ...
- 手机号流量统计---Mapreduce项目分析
文档显示: 每行依次是 ~手机号~上行流量~下行流量 需求分析: 需要统计各自的手机号,及上行.下行.总流量 具体做法: 1.定义map输入输出类型 通常情况下map的输入的key-value就是lo ...
- MapReduce实现词频统计
问题描述:现在有n个文本文件,使用MapReduce的方法实现词频统计. 附上统计词频的关键代码,首先是一个通用的MapReduce模块: class MapReduce: __doc__ = ''' ...
- mahout推荐系统
本章包含以下内容: 首先看一下实战中的推荐系统 推荐引擎的精度评价 评价一个引擎的准确率和召回率 在真实数据集:GroupLens 上评价推荐系统 我们每天都会对喜欢的.不喜欢的.甚至不关心的事情有很 ...
随机推荐
- hadoop-sqoop学习笔记
======导入==== sqoop import --connect jdbc:mysql://20.12.20.165:3306/luo0907 --username root --passwor ...
- nodejs 接口跨域
//设置跨域访问 //设置跨域访问 app.all('*', function(req, res, next) { res.header("Access-Control-Allow-Orig ...
- 巧用padding让图片宽高比固定并自适应布局
1.从上图知道原始图片大小是 800 * 250,即宽高比为 3.2: 2.html 及 css 代码如下, 可以知道就只是在一个div里面放了一张图片,那么如何让这张图片的宽高比固定呢,看了css之 ...
- ftp上传下载 java FTPClient (zhuan)
项目需要,网上搜了搜,很多,但问题也不少,估计转来转去,少了不少东西,而且也情况也不太一样.没办法,只能自己去写一个. 一, 安装sserv-u ftp服务器 版本10.1.0.1 我所设服务器 ...
- mysqldump全备份脚本mysqlallbackup.sh
库小,大概16G左右,每天增量很小,不到100M,所以用mysqldump每天全量备份,将备份结果信息发送到email通知DBA. mysqlallbackup.sh :MySQL DataBase ...
- 【HTML代码】访问页面时,拨打页面中的电话号码
这两天在写HTML页面今天要实现一个手机用户访问页面的时候,如果页面中有电话号码,点击可以打电话或者是发信息,之前没做过今天刚听说感觉很高大上会很难,实际上简单的让我内牛满面啊,, 小婊砸 (* ...
- 我不知道的promise
promise在resolve之后 再抛出错误并不会被捕获,等于没有抛出,个人理解是状态改变之后就不会再次改变. 错误具有冒泡的特性,会一直向后传递,直到被捕获为止,但是不会冒泡到全局.跟传统的try ...
- Celery-4.1 用户指南:Testing with Celery (用 Celery测试)
任务与单元测试 在单元测试中测试任务行为的推荐方法是用mocking. Eager mode: task_always_eager 设置启用的 eager 模式不适用于单元测试. 当使用eager模式 ...
- Canopy聚类算法(经典,看图就明白)
只有这个算法思想比较对,其他 的都没有一开始的remove: 原网址:http://www.shahuwang.com/?p=1021 Canopy Clustering 这个算法是2000年提出来的 ...
- nfs cron shell 作业
作业一: nginx反向代理三台web服务器,实现负载均衡 所有的web服务共享一台nfs的存储 2台服务器 nginx [lb] :101.200.206.6 nginx [web]:101.200 ...