
python爬虫(1)——urllib包
人生苦短,我用python!
一、关于爬虫
鉴于我的windos环境使用命令行感觉非常不便,也懒得折腾虚拟机,于是我选择了一个折中的办法——Cmder。它的下载地址是:cmder.net
Cmder是一个增强型命令行工具,不仅可以使用windows下的所有命令,更爽的是可以使用linux的命令,shell命令。下载下来后,解压即可使用。稍加设置(具体的设置可以百度),你就会发现它比windos的cmd要好用的多。
爬虫分为通用爬虫和聚焦爬虫,我们所研究的就是聚焦爬虫——抓取网页时筛选,尽量只抓与需求相关的网页信息。而网络爬虫的抓取过程我们可以理解为模拟浏览器操作的过程,这个过程基于Http(超文本传输协议)和Https(安全版的Http)的。当我们向浏览器中输入https://www.baidu.com/时,它就会根据这个地址来获取网页信息。我们所输入的网址就是URL——统一资源定位符,它是用于完整地描述Internet上网页和其它资源的地址的一种标识方式。
二、Python的urllib包
在Python3中,我们可以使用urlib这个组件抓取网页,urllib是一个URL处理包,这个包中集合了一些处理URL的模块。我们可以使用help命令查看一下。
import urllib

help(urllib)
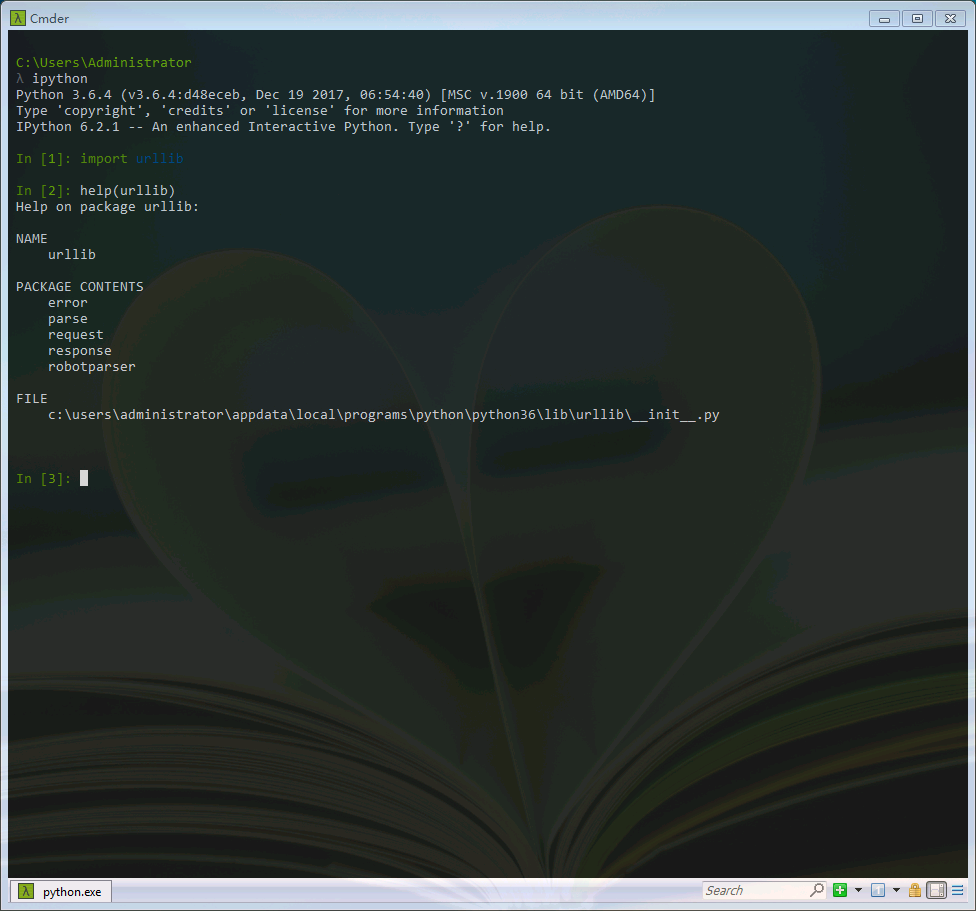
其中:
1.urllib.request模块是用来打开和读取URLs的;
2.urllib.error模块包含一些有urllib.request产生的错误,可以使用try进行捕捉处理(可以学习一下python的异常处理机制);
3.urllib.parse模块包含了一些解析URLs的方法;
4.urllib.robotparser模块用来解析robots.txt(爬虫协议)文本文件,它提供了一个单独的RobotFileParser类,通过该类提供的can_fetch()方法测试爬虫是否可以下载一个页面。
三、下载一个页面
了解了以上这些,我们可以用request来尝试下载一个页面。在ipython中测试一下:
 from urllib import request

 response=request.urlopen('http://www.17jita.com/')

 html=response.read()

 print(html)
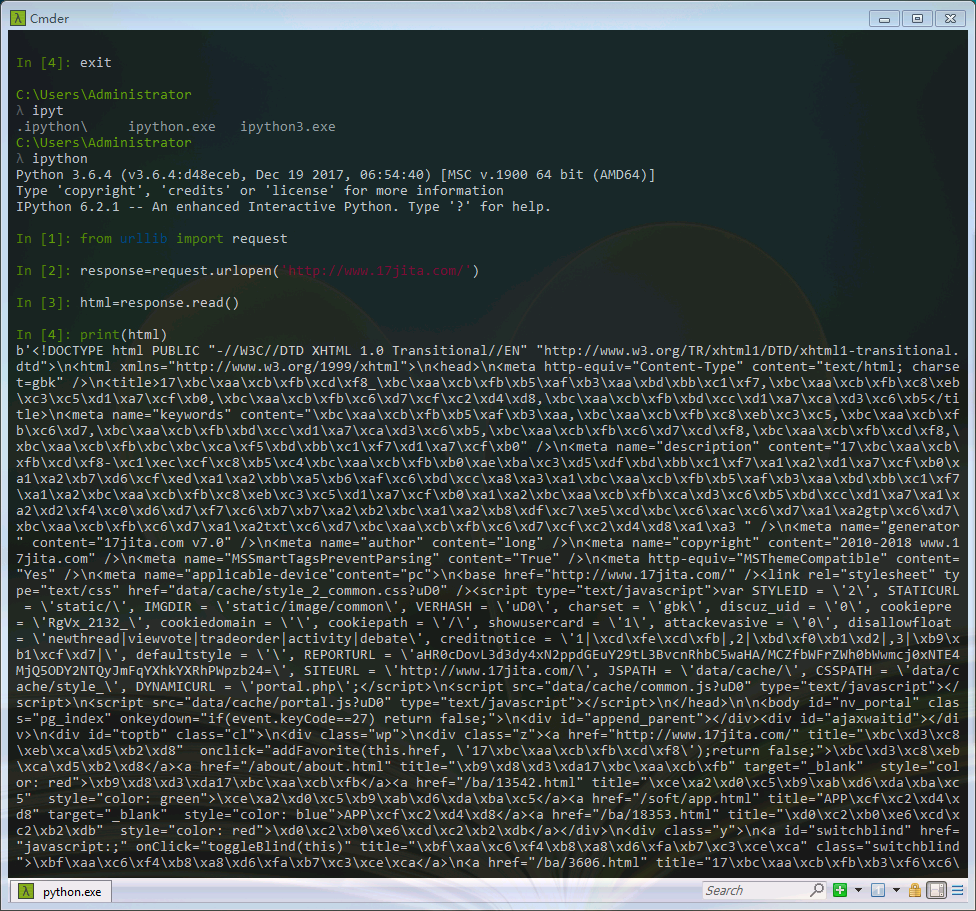
看起来有些乱码,别着急,我们可以通过简单的decode()命令将网页的信息进行解码,并显示出来.
 from urllib import request

 response=request.urlopen('http://www.17jita.com/')

 html=response.read().decode('gbk')

 print(html)

这样我们就可以利用python看到网页的源码了,这与在浏览器右键查看网页源代码所看到的是一致的。
值得注意的是,在使用decode解码时,我们要了解到一些一些常用的编码方式,如:gbk,gb2312,utf-8,Unicode等等。python2的编码就常常为人所诟病,但是在在python3中,这个问题得到了解决。具体资料可以自行百度。
python爬虫(1)——urllib包的更多相关文章
- Python爬虫之urllib模块2
Python爬虫之urllib模块2 本文来自网友投稿 作者:PG-55,一个待毕业待就业的二流大学生. 看了一下上一节的反馈,有些同学认为这个没什么意义,也有的同学觉得太简单,关于Beautiful ...
- python爬虫之urllib库(一)
python爬虫之urllib库(一) urllib库 urllib库是python提供的一种用于操作URL的模块,python2中是urllib和urllib2两个库文件,python3中整合在了u ...
- Python爬虫之urllib模块1
Python爬虫之urllib模块1 本文来自网友投稿.作者PG,一个待毕业待就业二流大学生.玄魂工作室未对该文章内容做任何改变. 因为本人一直对推理悬疑比较感兴趣,所以这次爬取的网站也是平时看一些悬 ...
- python爬虫之urllib库(三)
python爬虫之urllib库(三) urllib库 访问网页都是通过HTTP协议进行的,而HTTP协议是一种无状态的协议,即记不住来者何人.举个栗子,天猫上买东西,需要先登录天猫账号进入主页,再去 ...
- python爬虫之urllib库(二)
python爬虫之urllib库(二) urllib库 超时设置 网页长时间无法响应的,系统会判断网页超时,无法打开网页.对于爬虫而言,我们作为网页的访问者,不能一直等着服务器给我们返回错误信息,耗费 ...
- Python爬虫之urllib.parse详解
Python爬虫之urllib.parse 转载地址 Python 中的 urllib.parse 模块提供了很多解析和组建 URL 的函数. 解析url 解析url( urlparse() ) ur ...
- 爬虫之urllib包
urllib简介 简介 Python3中将python2.7的urllib和urllib2两个包合并成了一个urllib库 Python3中,urllib库包含有四个模块: urllib.reques ...
- python爬虫之urllib库介绍
一.urllib库 urllib是Python自带的一个用于爬虫的库,其主要作用就是可以通过代码模拟浏览器发送请求.其常被用到的子模块在Python3中的为urllib.request和urllib. ...
- 爬虫之urllib包以及request模块和parse模块
urllib简介 简介 Python3中将python2.7的urllib和urllib2两个包合并成了一个urllib库 Python3中,urllib库包含有四个模块: urllib.reques ...
- Python爬虫之Urllib库的基本使用
# get请求 import urllib.request response = urllib.request.urlopen("http://www.baidu.com") pr ...
随机推荐
- 你知道织梦后台安装插件时为什么会出现这个Character postion 686, 'item'&n
https://zhidao.baidu.com/question/589525064.html?qbl=relate_question_3&word=Tag Character postio ...
- 读书笔记——《C++ Concurrency IN ACTION》
=================================版权声明================================= 版权声明:原创文章 禁止转载 请通过右侧公告中的“联系邮 ...
- 优化表单数据的JS校验
在平常的web开发中,我经常需要在客户端对表单的数据进行验证.比如,我们验证表单输入的内容不为空: ? <form action="" method="post&q ...
- git分支小问题
参考网址:http://hbiao68.iteye.com/blog/2055493 1.查看分支 git branch 或者 git branch -v 2.创建一个新的分支 git branch ...
- es7重点笔记
1,函数绑定运算符,用来取代call,apply,bind调用,写法:并排的双冒号(::),左边是对象,右边是函数 foo :: bar; // 等同于bar.bind(foo); 双冒号返回的还是原 ...
- underscore.js 源码阅读 准备
本次阅读是初次阅读源码,参考了以下几篇文章: https://github.com/hanzichi?language=javascript&page=5&tab=stars http ...
- scrapy_随机ip代理池
什么是ip代理? 我们电脑访问网站,其实是访问远程的服务器,通过ip地址识别是那个机器访问了服务器,服务器就知道数据该返回给哪台机器,我们生活中所用的网络是局域网,ip是运营商随机分配的,是一种直接访 ...
- float是什么样式?
什么是float样式? 让标签浮动起来,总体方向往上 right,left(右浮,左浮) 联合height,width使用,分别占用y方向和x方向多少,单位px或百分比(%) 作用对象不是页面,而是作 ...
- Windows ftp脚本和RSCD agent自动安装脚本
Windows ftp脚本 和bladelogic RSCD Agent自动安装脚本 比较简单的命令是msiexec /I "C:\RSCD85-SP1-WIN64.msi" /Q ...
- Linux指令--性能监控和优化命令相关指令
原文出处:http://www.cnblogs.com/peida/archive/2012/12/05/2803591.html.感谢作者无私分享 性能监控和优化命令相关指令有:top,free,v ...