
hashlib加密模块、logging日志模块
hashlib模块
加密:将明文数据通过一系列算法变成密文数据
目的: 就是为了数据的安全
基本使用
 基本使用

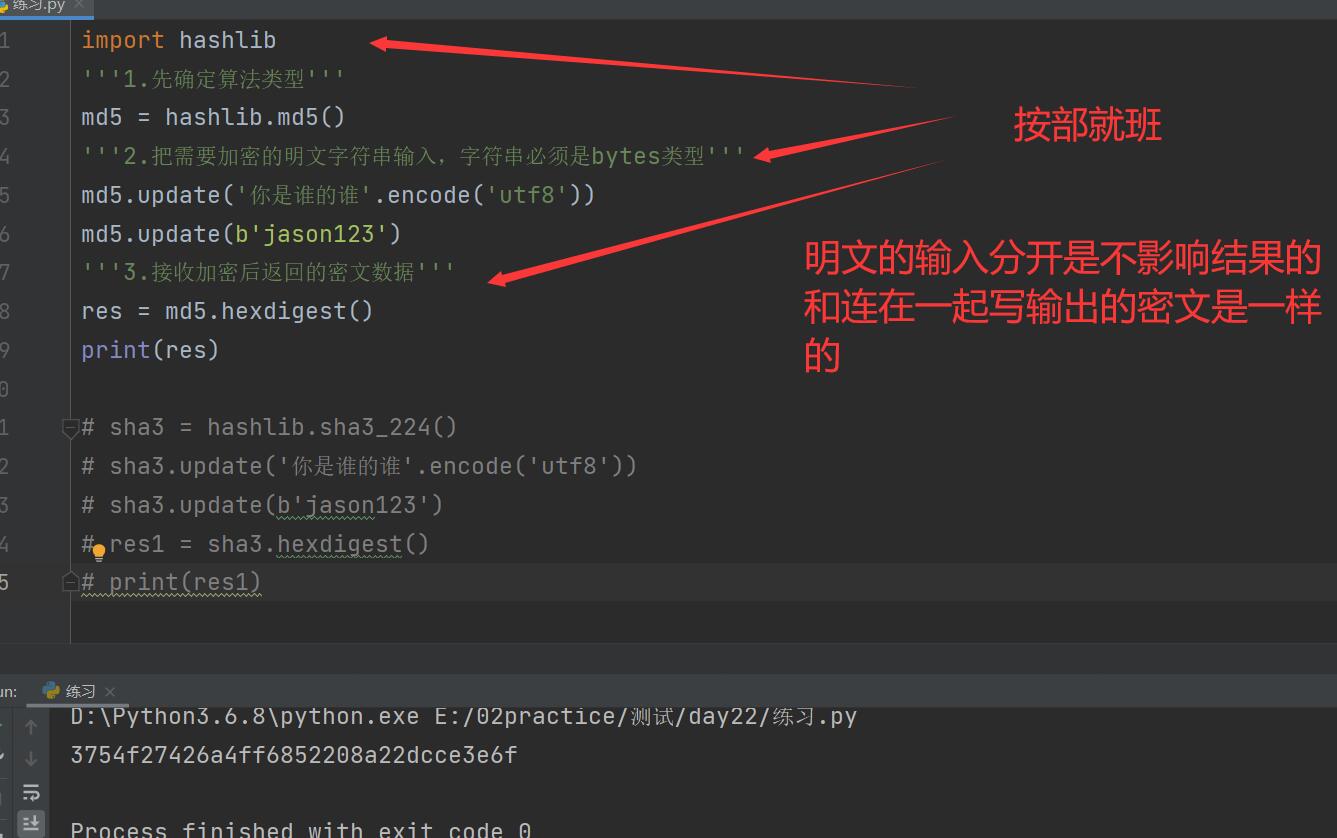
import hashlib

# 1.先确定算法类型(md5普遍使用)

md5 = hashlib.md5()

# 2.将明文数据传递给md5算法(update只能接受bytes类型数据)

md5.update('123'.encode('utf8'))

md5.update(b'123')

# 3.获取加密之后的密文数据(没有规则的一串随机字符串)

res = md5.hexdigest()

print(res)

"""

1.加密之后的密文数据是没有办法反解密成明文数据的

    市面上所谓的破解 其实就是提前算出一系列明文对应的密文

    之后比对密文再获取明文

"""
其他加密算法
当然不仅有md5加密算法,还有其他的加密算法
import hashlib

 # 1.先确定算法类型

 sha256 = hashlib.sha256()

 # 2.将明文数据传递给md5算法(update只能接受bytes类型数据)

 sha256.update(b'hello')

 sha256.update(b'jason')

 sha256.update(b'123')  # 6ec0f865ec4e9bcf9abc7f6c0e7268acfb2ba36f3e460fd592a214f7eacc92b0

 # 3.获取加密之后的密文数据(没有规则的一串随机字符串)

 res = sha256.hexdigest()

 print(res)  # 6ec0f865ec4e9bcf9abc7f6c0e7268acfb2ba36f3e460fd592a214f7eacc92b0

    """

密文越长表示算法越复杂 对应的破解算法的难度越高

但是越复杂的算法所需要消耗的资源也就越多 密文越长基于网络发送需要占据的数据也就越大

    具体使用什么算法取决于项目的要求 一般情况下md5足够了

"""
一般涉及到用户密码存储 其实都是密文 只要用户自己知道明文是什么
1.内部程序员无法得知明文数据
2.数据泄露也无法得知明文数据
加盐处理
"""

在对明文数据做加密处理过程前添加一些干扰项

"""

 import hashlib

 # 1.先确定算法类型(md5普遍使用)

 md5 = hashlib.md5()

 # 2.将明文数据传递给md5算法(update只能接受bytes类型数据)

 md5.update('123'.encode('utf8'))

 # 加盐(干扰项)

 md5.update('公司内部自己定义的盐'.encode('utf8'))

 # 真实数据

 md5.update(b'hellojason123')

 # 3.获取加密之后的密文数据(没有规则的一串随机字符串)

 res = md5.hexdigest()

 print(res)  # 4326fe1839d7c4186900eb2b356d4f8a
动态加盐
import hashlib

# 1.先确定算法类型(md5普遍使用)

md5 = hashlib.md5()

import time

res1 = str(time.time())

md5.update(res1.encode('utf8'))

# 真实数据

md5.update(b'hellojason123')

# 3.获取加密之后的密文数据(没有规则的一串随机字符串)

res = md5.hexdigest()

print(res)  # 4326fe1839d7c4186900eb2b356d4f8a

"""

在IT互联网领域 没有绝对的安全可言 只有更安全

    原因在于互联网的本质 就是通过网线(网卡)连接计算机

"""
校验文件一致性
一般在下载文件的时候用来校验该文件是否被修改添加病毒
# 6.校验文件一致性

"""

文件不是很大的情况下 可以将所有文件内部全部加密处理

但是如果文件特别大 全部加密处理相当的耗时好资源 如何解决???

    针对大文件可以使用切片读取的方式

"""

import hashlib

md5 = hashlib.md5()

with open(r'a.txt','rb') as f:

    for line in f:

        md5.update(line)

real_data = md5.hexdigest()

print(real_data)  # 29d8ea41c610ee5d1e76dd0a42c7e60a

with open(r'a.txt','rb') as f:

    for line in f:

        md5.update(line)

error_data = md5.hexdigest()

print(error_data)  # 738a56b49f24884ba758d1e4ab6ceb74

import os

# 读取文件总大小

res = os.path.getsize(r'a.txt')

# 指定分片读取策略(读几段 每段几个字节)  10   f.seek()

read_method = [0,res//4,res//2,res]

"""

比特流技术

断点续传技术

"""
logging日志模块
日志模块详细介绍
import logging

# 1.logger对象:负责产生日志

logger = logging.getLogger('转账记录')

# 2.filter对象:负责过滤日志(直接忽略)

# 3.handler对象:负责日志产生的位置

hd1 = logging.FileHandler('a1.log',encoding='utf8')  # 产生到文件的

hd2 = logging.FileHandler('a2.log',encoding='utf8')  # 产生到文件的

hd3 = logging.StreamHandler()  # 产生在终端的

# 4.formatter对象:负责日志的格式

fm1 = logging.Formatter(

    fmt='%(asctime)s - %(name)s - %(levelname)s -%(module)s:  %(message)s',

    datefmt='%Y-%m-%d %H:%M:%S %p',

)

fm2 = logging.Formatter(

    fmt='%(asctime)s - %(name)s %(message)s',

    datefmt='%Y-%m-%d',

)

# 5.绑定handler对象

logger.addHandler(hd1)

logger.addHandler(hd2)

logger.addHandler(hd3)

# 6.绑定formatter对象

hd1.setFormatter(fm1)

hd2.setFormatter(fm2)

hd3.setFormatter(fm1)

# 7.设置日志等级

logger.setLevel(30)

# 8.记录日志

logger.debug('写了半天 好累啊 好热啊')

配置字典
# 核心就在于CV

import logging

import logging.config

standard_format = '[%(asctime)s][%(threadName)s:%(thread)d][task_id:%(name)s][%(filename)s:%(lineno)d]' \

                  '[%(levelname)s][%(message)s]' #其中name为getlogger指定的名字

simple_format = '[%(levelname)s][%(asctime)s][%(filename)s:%(lineno)d]%(message)s'

logfile_path = 'a3.log'

# log配置字典

LOGGING_DIC = {

    'version': 1,

    'disable_existing_loggers': False,

    'formatters': {

        'standard': {

            'format': standard_format

        },

        'simple': {

            'format': simple_format

        },

    },

    'filters': {},  # 过滤日志

    'handlers': {

        #打印到终端的日志

        'console': {

            'level': 'DEBUG',

            'class': 'logging.StreamHandler',  # 打印到屏幕

            'formatter': 'simple'

        },

        #打印到文件的日志,收集info及以上的日志

        'default': {

            'level': 'DEBUG',

            'class': 'logging.handlers.RotatingFileHandler',  # 保存到文件

            'formatter': 'standard',

            'filename': logfile_path,  # 日志文件

            'maxBytes': 1024*1024*5,  # 日志大小 5M

            'backupCount': 5,

            'encoding': 'utf-8',  # 日志文件的编码,再也不用担心中文log乱码了

        },

    },

    'loggers': {

        #logging.getLogger(__name__)拿到的logger配置  空字符串作为键 能够兼容所有的日志

        '': {

            'handlers': ['default', 'console'],  # 这里把上面定义的两个handler都加上,即log数据既写入文件又打印到屏幕

            'level': 'DEBUG',

            'propagate': True,  # 向上(更高level的logger)传递

        },  # 当键不存在的情况下 (key设为空字符串)默认都会使用该k:v配置

    },

}

# 使用配置字典

logging.config.dictConfig(LOGGING_DIC)  # 自动加载字典中的配置

logger1 = logging.getLogger('xxx')

logger1.debug('好好的 不要浮躁 努力就有收获')
第三方模块
# 并不是python自带的 需要基于网络下载!!!

'''pip所在的路径添加环境变量'''

下载第三方模块的方式

    方式1:命令行借助于pip工具

        pip3 install 模块名  # 不知道版本默认是最新版

        pip3 install 模块名==版本号  # 指定版本下载

        pip3 install 模块名 -i 仓库地址  # 临时切换

        '''命令行形式永久修改需要修改python解释器源文件'''

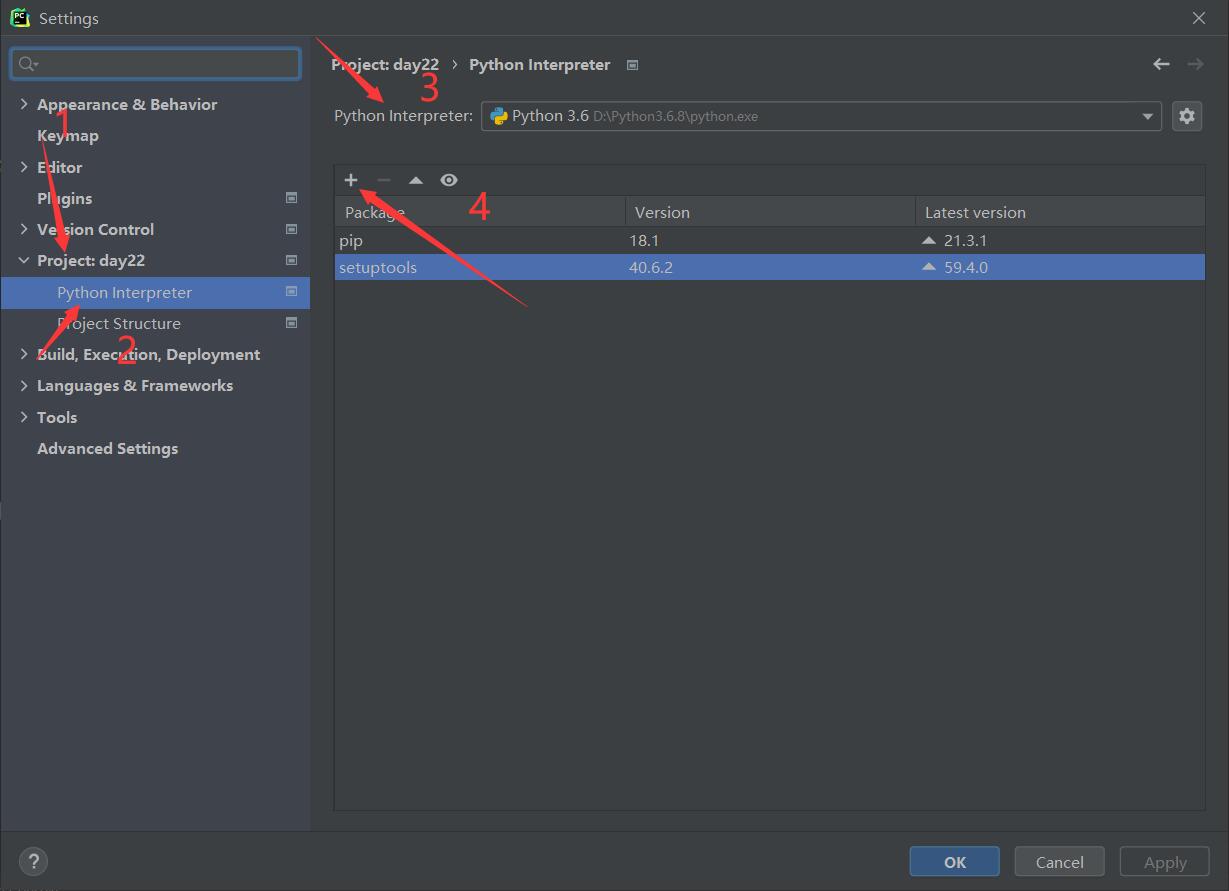
    方式2:pycharm快捷方式

        settings

            project

                project interprter

                    双击或者加号

        点击右下方manage管理添加源地址即可

# 下载完第三方模块之后 还是使用import或from import句式导入使用

"""

pip命令默认下载的渠道是国外的python官网(有时候会非常的慢)

我们可以切换下载的源(仓库)

    (1)阿里云 http://mirrors.aliyun.com/pypi/simple/

    (2)豆瓣 http://pypi.douban.com/simple/

    (3)清华大学 https://pypi.tuna.tsinghua.edu.cn/simple/

    (4)中国科学技术大学 http://pypi.mirrors.ustc.edu.cn/simple/

    (5)华中科技大学http://pypi.hustunique.com/

pip3 install openpyxl -i http://mirrors.aliyun.com/pypi/simple/

"""

"""

下载第三方模块可能报错的情况及解决措施

    1.报错的提示信息中含有关键字timeout

        原因:网络不稳定

        措施:再次尝试 或者切换更加稳定的网络

    2.找不到pip命令

        环境变量问题

    3.没有任何的关键字 不同的模块报不同的错

        原因:模块需要特定的计算机环境

        措施:拷贝报错信息 打开浏览器 百度搜索即可

            pip下载某个模块报错错误信息

"""
hashlib加密模块、logging日志模块的更多相关文章
- 约束、自定义异常、hashlib模块、logging日志模块
一.约束(重要***) 1.首先我们来说一下java和c#中的一些知识,学过java的人应该知道,java中除了有类和对象之外,还有接口类型,java规定,接口中不允许在方法内部写代码,只能约束继承它 ...
- 包,logging日志模块,copy深浅拷贝
一 包 package 包就是一个包含了 __init__.py文件的文件夹 包是模块的一种表现形式,包即模块 首次导入包: 先创建一个执行文件的名称空间 1.创建包下面的__init__.py文件的 ...
- logging 日志模块学习
logging 日志模块,用于记录系统在运行过程中的一些关键信息,以便于对系统的运行状况进行跟踪,所以还是灰常重要滴,下面我就来从入门到放弃的系统学习一下日志既可以在屏幕上显示,又可以在文件中体现. ...
- logging日志模块
为什么要做日志: 审计跟踪:但错误发生时,你需要清除知道该如何处理,通过对日志跟踪,你可以获取该错误发生的具体环境,你需要确切知道什么是什么引起该错误,什么对该错误不会造成影响. 跟踪应用的警告和错误 ...
- python 自动化之路 logging日志模块
logging 日志模块 http://python.usyiyi.cn/python_278/library/logging.html 中文官方http://blog.csdn.net/zyz511 ...
- day31 logging 日志模块
# logging 日志模块 ****** # 记录用户行为或者代码执行过程 # print 来回注释比较麻烦的 # logging # 我能够“一键”控制 # 排错的时候需要打印很多细节来帮助我排错 ...
- logging日志模块的使用
logging日志模块的使用 logging模块中有5个日志级别: debug 10 info 20 warning 30 error 40 critical 50 通常使用日志模块,是用字典进行配置 ...
- Python入门之logging日志模块以及多进程日志
本篇文章主要对 python logging 的介绍加深理解.更主要是 讨论在多进程环境下如何使用logging 来输出日志, 如何安全地切分日志文件. 1. logging日志模块介绍 python ...
- Python 中 logging 日志模块在多进程环境下的使用
因为我的个人网站 restran.net 已经启用,博客园的内容已经不再更新.请访问我的个人网站获取这篇文章的最新内容,Python 中 logging 日志模块在多进程环境下的使用 使用 Pytho ...
随机推荐
- 使用socat反向Shell多台机器
原创:打码日记(微信公众号ID:codelogs),欢迎分享,转载请保留出处. 场景 很多时候,我们需要批量操作多台机器,业界一般使用Ansible来实现,但使用Ansible来操作多台机器的前提是需 ...
- 使用ntp 实现时间同步
1.首先安装NTP [root@localhost /]# yum install ntp -y2.查看是否安装成功 rpm -qa|grep ntp [root@hadoop102 桌面]# vi ...
- 使用.Net6中的System.Text.Json遇到几个常见问题及解决方案
前言 以前.NetCore是不内置JSON库的,所以大家都用Newtonsoft的JSON库,而且也确实挺好用的,不过既然官方出了标准库,那更方便更值得我们多用用,至少不用每次都nuget安装Newt ...
- 基于Kali的一次DDos攻击实践
镜像下载.域名解析.时间同步请点击 阿里云开源镜像站 一.什么是DDos攻击 DDOS(Distributed Denial of Service),即分布式拒绝服务,是一种针对于网络服务的攻击行为. ...
- Python之VSCode
在学习Python的过程中,一直没有找到比较趁手的第三方编辑器,用的最多的还是Python自带的编辑器.由于本人用惯了宇宙第一IDE(Visual Studio),所以当Visual Studio C ...
- .user.ini文件构成的PHP后门
.user.ini.它比.htaccess用的更广,不管是nginx/apache/IIS,只要是以fastcgi运行的php都可以用这个方法.我的nginx服务器全部是fpm/fastcgi,我的I ...
- Ajax是什么?包含什么技术?有什么作用?
Ajax 是 Asynchronous JavaScript and XML(以及 DHTML 等)的缩写. Ajax 尝试建立桌面应用程序的功能和交互性,与不断更新的 Web 应用程序之间的桥梁.不 ...
- Zookeeper 文件系统 ?
Zookeeper 提供一个多层级的节点命名空间(节点称为 znode).与文件系统不 同的是,这些节点都可以设置关联的数据,而文件系统中只有文件节点可以存放 数据而目录节点不行. Zookeeper ...
- Java 线程具有五中基本状态 ?
1.新建状态(New):当线程对象对创建后,即进入了新建状态,如:Thread t = new MyThread(): 2.就绪状态(Runnable):当调用线程对象的 start()方法(t.st ...
- 区分 BeanFactory 和 ApplicationContext?
BeanFactory ApplicationContext 它使用懒加载 它使用即时加载 它使用语法显式提供资源对象 它自己创建和管理资源对象 不支持国际化 支持国际化 不支持基于依赖的注解 支持基 ...