
11月29日内容总结——SQL注入问题、视图、触发器、事务、存储过程、函数、流程控制、索引、慢查询、数据库三大范式
一、SQL注入问题
SQL注入问题引入
我们在pycharm中使用pymysql模块执行mysql代码的时候会发现用占位符传输信息的时候若是按下方的代码输入内容,会出现下面的两个怪象。
sql = " insert into userinfo(name,pwd) values(%s,%s)" % (sign_name,sign_pwd)

sign_name = 'jason' -- kasdjksajd'

sign_pwd = ''

sign_name = 'xyz' or 1=1 -- aksdjasldj'

sign_pwd = ''
怪象1:输对用户名就可以登录成功
怪象2:不需要对的用户名和密码也可以登录成功
这时候pycharm会在报错信息中返回一个sql语句,内容如下:
select * from userinfo where name='jason' -- kasdjksajd' and pwd=''

select * from userinfo where name='xyz' or 1=1 -- aksdjasldj' and pwd=''
讲解:
通过上面的语句,我们可以发现语句的中间出现了两个'--',而这个--符号的意思是注释的作用,因此就相当于执行了--符号前面的语句,后面的内容成了注释内容,这种情况就叫做SQL注入。
SQL注入概念和解决方案
- 概念
SQL注入:利用特殊符号的组合产生特殊的含义,从而避开正常的业务逻辑
- 解决方案
针对上述的SQL注入问题,核心在于手动拼接了关键数据,交给execute处理即可
sql = " select * from userinfo where name=%s and pwd=%s "
cursor.execute(sql, (username, password))
补充说明
我们也可以使用executemany来一次性处理多个数据,把多个数据填入下方的小括号的即可。
executemany(sql,[(),(),(),()...])
二、视图
视图就是通过查询得到一张虚拟表,然后保存下来,下次直接使用,通常用于连表操作得到的结果。语句如下:
create view teacher2course as

select * from teacher inner join course on teacher.tid = course.teacher_id;
注意事项
1.视图的表只能用来查询不能做其他增删改操作
2.视图尽量少用,会跟真正的表产生混淆,从而干扰操作者(使用show tables查看表名称或是进行其他操作的时候跟普通的表没有区别)。
三、触发器
定义
触发器是由事件来触发某个操作。当数据库执行这些事件时,就会激活触发器来执行相应的操作。这些事件称为触发条件,在MySQL中,有UPDATE,INSERT,和DELETE(即对表进行增、删、改)。
主要有六种情况:增前、增后、删前、删后、改前、改后(BEFORE INSERT、BEFORE DELETE、BEFORE UPDATE、AFTER INSERT、AFTER DELETE、AFTER UPDATE)。
代码
create trigger 触发器的名字 before/after insert/update/delete on 表名 for each row

begin

	sql语句

end
1.触发器命名有一定的规律
tri_before_insert_t1

tri_after_delete_t2

tri_after_update_t2
讲解:
这里我们发现第一部分名称就是tirgger关键字的前三个字母,第二部分名称是出发的状态,这部分名称由两部分组成,最后的一部分名称我们可以自定义。
2.临时修改SQL语句的结束符
- 因为有些操作中需要使用分号,这时候就会出现冲突。
- 这里我们用delimiter关键字修改结束符号,通过这种方式达到目的。
触发器实际应用
CREATE TABLE cmd (

    id INT PRIMARY KEY auto_increment,

    USER CHAR (32),

    priv CHAR (10),

    cmd CHAR (64),

    sub_time datetime, #提交时间

    success enum ('yes', 'no') #no代表执行失败

);

CREATE TABLE errlog (

    id INT PRIMARY KEY auto_increment,

    err_cmd CHAR (64),

    err_time datetime

);

delimiter $$  # 将mysql默认的结束符由;换成$$

create trigger tri_after_insert_cmd after insert on cmd for each row

begin

    if NEW.success = 'no' then  # 新记录都会被MySQL封装成NEW对象,如果新纪录中success的值为no就会把数据也记录到errlog表中

        insert into errlog(err_cmd,err_time) values(NEW.cmd,NEW.sub_time);

    end if;

end $$

delimiter ;  # 结束之后记得再改回来,不然后面结束符就都是$$了

#往表cmd中插入记录,触发触发器,根据IF的条件决定是否插入错误日志

INSERT INTO cmd (

    USER,

    priv,

    cmd,

    sub_time,

    success

)

VALUES

    ('kevin','0755','ls -l /etc',NOW(),'yes'),

    ('kevin','0755','cat /etc/passwd',NOW(),'no'),

    ('kevin','0755','useradd xxx',NOW(),'no'),

    ('kevin','0755','ps aux',NOW(),'yes');

# 查询errlog表记录

select * from errlog;

# 查看所有的触发器

show triggers;

# 删除触发器

drop trigger tri_after_insert_cmd;
四、事务
MySQL提供两种事务型存储引擎InnoDB和NDB cluster及第三方XtraDB、PBXT
事务的四大特性(ACID)
- A:原子性
指事务是一个不可再分割的工作单位,事务中的操作要么都发生,要么都不发生。
特点:
1、事务是一个完整的操作,事务的各元素是不可分的。
2、事务中的所有元素必须作为一个整体提交或回滚。
3、如果事务中的任何元素失败,则整个事务将失败。
举例:
比如转账的时候,如果对方接收失败了,钱应该退回自己的账户中。让双方的数据都回到转账前的状态。
- C:一致性
指在事务开始之前和事务结束以后,数据库的完整性约束没有被破坏。一致性与原子性是密切相关的。
特点:
1、当事务完成时,数据必须处于一致状态。
2、在事务开始前,数据库中存储的数据处于一致状态。
3、在正在进行的事务中,数据可能处于不一致的状态。
4、当事务成功完成时,数据必须再次回到已知的一致状态。
举例:
对银行转帐事务,不管事务成功还是失败,应该保证事务结束后表中A和B的存款总额跟事务执行前一致。
- I:隔离性
指在并发环境中,当不同的事务同时操纵相同的数据时,每个事务都有各自的完整数据空间(多个事务之间彼此不干扰)。
特点:
1、对数据进行修改的所有并发事务是彼此隔离的,表明事务必须是独立的,它不应以任何方式依赖于或影响其他事务。
2、修改数据的事务可在另一个使用相同数据的事务开始之前访问
3、这些数据,或者在另一个使用相同数据的事务结束之后访问这些数据
- D:持久性
持久性也称永久性,指一个事务一旦提交,它对数据库中数据的改变就应该是永久性的,并不会被回滚。
特点:
1、指不管系统是否发生故障,事务处理的结果都是永久的。
2、一旦事务被提交,事务的效果会被永久地保留在数据库中。
代码
transaction是事务功能的关键字
create table user(

id int primary key auto_increment,

name char(32),

balance int

);

insert into user(name,balance)

values

('jason',1000),

('kevin',1000),

('tank',1000);

# 修改数据之前先开启事务操作

start transaction;

# 修改操作

update user set balance=900 where name='jason'; #买支付100元

update user set balance=1010 where name='kevin'; #中介拿走10元

update user set balance=1090 where name='tank'; #卖家拿到90元

# 回滚到上一个状态

rollback;

# 开启事务之后,只要没有执行commit操作,数据其实都没有真正刷新到硬盘

commit;
事务相关关键字
  事务(transaction)

  回退(rollback)

  提交(commit)

  保留点(savepoint)

	为了支持回退部分事务处理,必须能在事务处理块中合适的位置放置占位符,这样如果需要回退可以回退到某个占位符(保留点)

    创建占位符可以使用savepoint

    	savepoint sp01;

    回退到占位符地址

    	rollback to sp01;

保留点在执行rollback或者commit之后自动释放
事务之间的相互影响
1、脏读:一个事务读取了另一个事务未提交的数据,而这个数据是有可能回滚的。
2、不可重复读:一个事务内两个相同的查询却返回了不同数据。这是由于查询时系统中其他事务修改的提交而引起的。
3、幻读:一个事务对一个表中的数据进行了修改,这种修改涉及到表中的全部数据行。同时,另一个事务也修改这个表中的数据,这种修改是向表中插入一行新数据。那么,操作前一个事务的用户会发现表中还有没有修改的数据行,就好象发生了幻觉一样。
4、丢失更新:两个事务同时读取同一条记录,A先修改记录,B也修改记录(B不知道A修改过),B提交数据后B的修改结果覆盖了A的修改结果。
在SQL标准中定义了四种隔离级别,每一种级别都规定了一个事务中所做的修改
InnoDB支持所有隔离级别
设置隔离级别语句:
set transaction isolation level 级别
查询全局事务隔离级别
show global variables like '%isolation%';

SELECT @@global.tx_isolation;
1.read uncommitted(未提交读)
事务中的修改即使没有提交,对其他事务也都是可见的,事务可以读取未提交的数据,这一现象也称之为"脏读"
2.read committed(提交读)
大多数数据库系统默认的隔离级别
一个事务从开始直到提交之前所作的任何修改对其他事务都是不可见的,这种级别也叫做"不可重复读"
3.repeatable read(可重复读) # MySQL默认隔离级别
能够解决"脏读"问题,但是无法解决"幻读"
所谓幻读指的是当某个事务在读取某个范围内的记录时另外一个事务又在该范围内插入了新的记录,当之前的事务再次读取该范围的记录会产生幻行,InnoDB和XtraDB通过多版本并发控制(MVCC)及间隙锁策略解决该问题
4.serializable(可串行读)
强制事务串行执行,很少使用该级别
MVCC只能在read committed(提交读)、repeatable read(可重复读)两种隔离级别下工作,其他两个不兼容(read uncommitted:总是读取最新 serializable:所有的行都加锁)
InnoDB的MVCC通过在每行记录后面保存两个隐藏的列来实现MVCC
一个列保存了行的创建时间
一个列保存了行的过期时间(或删除时间) # 本质是系统版本号
每开始一个新的事务版本号都会自动递增,事务开始时刻的系统版本号会作为事务的版本号用来和查询到的每行记录版本号进行比较
例如
刚插入第一条数据的时候,我们默认事务id为1,实际是这样存储的
username
create_version
delete_version
jason 1
可以看到,我们在content列插入了kobe这条数据,在create_version这列存储了1,1是这次插入操作的事务id。
然后我们将jason修改为jason01,实际存储是这样的
username
create_version
delete_version
jason 1
2
jason01 2
可以看到,update的时候,会先将之前的数据delete_version标记为当前新的事务id,也就是2,然后将新数据写入,将新数据的create_version标记为新的事务id
当我们删除数据的时候,实际存储是这样的
username
create_version
delete_version
jason01 2
3
由此当我们查询一条记录的时候,只有满足以下两个条件的记录才会被显示出来:
1.当前事务id要大于或者等于当前行的create_version值,这表示在事务开始前这行数据已经存在了。
2.当前事务id要小于delete_version值,这表示在事务开始之后这行记录才被删除。
五、存储过程
存储过程是事先经过编译并存储在数据库中的一段SQL语句的集合,调用存储过程可以简化应用开发人员的很多工作,减少数据在数据库和应用服务器之间的传输,对于提高数据处理的效率是有好处的。
可以看成是python中的自定义函数。
# 无参函数

delimiter $$

create procedure p1()

begin

	select * from cmd;

end $$

delimiter ;

# 调用

call p1()

# 有参函数

delimiter $$

create procedure p2(

    in m int,  # in表示这个参数必须只能是传入不能被返回出去

    in n int,

    out res int  # out表示这个参数可以被返回出去,还有一个inout表示即可以传入也可以被返回出去

)

begin

    select * from cmd where id > m and id < n;

    set res=0;  # 用来标志存储过程是否执行

end $$

delimiter ;

# 针对res需要先提前定义

set @res=10;  定义

select @res;  查看

call p1(1,5,@res)  调用

select @res  查看

"""

查看存储过程具体信息

	show create procedure pro1;

查看所有存储过程

	show procedure status;

删除存储过程

	drop procedure pro1;

"""

# 大前提:存储过程在哪个库下面创建的只能在对应的库下面才能使用!!!

# 1、直接在mysql中调用

set @res=10  # res的值是用来判断存储过程是否被执行成功的依据,所以需要先定义一个变量@res存储10

call p1(2,4,10);  # 报错

call p1(2,4,@res);

# 查看结果

select @res;  # 执行成功,@res变量值发生了变化

# 2、在python程序中调用

pymysql链接mysql

产生的游表cursor.callproc('p1',(2,4,10))  # 内部原理:@_p1_0=2,@_p1_1=4,@_p1_2=10;

cursor.excute('select @_p1_2;')
六、函数
可以看成是python中的内置函数
ps:可以通过help 函数名 查看帮助信息!
1.移除指定字符
Trim、LTrim、RTrim
2.大小写转换
Lower、Upper
3.获取左右起始指定个数字符
Left、Right
4.返回读音相似值(对英文效果)
Soundex
eg:客户表中有一个顾客登记的用户名为J.Lee
但如果这是输入错误真名其实叫J.Lie,可以使用soundex匹配发音类似的
where Soundex(name)=Soundex('J.Lie')
5.日期格式:date_format
'''在MySQL中表示时间格式尽量采用2022-11-11形式'''

CREATE TABLE blog (

    id INT PRIMARY KEY auto_increment,

    NAME CHAR (32),

    sub_time datetime

);

INSERT INTO blog (NAME, sub_time)

VALUES

    ('第1篇','2015-03-01 11:31:21'),

    ('第2篇','2015-03-11 16:31:21'),

    ('第3篇','2016-07-01 10:21:31'),

    ('第4篇','2016-07-22 09:23:21'),

    ('第5篇','2016-07-23 10:11:11'),

    ('第6篇','2016-07-25 11:21:31'),

    ('第7篇','2017-03-01 15:33:21'),

    ('第8篇','2017-03-01 17:32:21'),

    ('第9篇','2017-03-01 18:31:21');

select date_format(sub_time,'%Y-%m'),count(id) from blog group by date_format(sub_time,'%Y-%m');

1.where Date(sub_time) = '2015-03-01'

2.where Year(sub_time)=2016 AND Month(sub_time)=07;

# 更多日期处理相关函数

	adddate	增加一个日期

	addtime	增加一个时间

	datediff计算两个日期差值
七、流程控制
# 分支结构

declare i int default 0;

IF i = 1 THEN

	SELECT 1;

ELSEIF i = 2 THEN

	SELECT 2;

ELSE

	SELECT 7;

END IF;

# 循环结构

DECLARE num INT ;

SET num = 0 ;

WHILE num < 10 DO

	SELECT num ;

	SET num = num + 1 ;

END WHILE ;
八、索引相关概念
1)索引就好比一本书的目录,它能让你更快的找到自己想要的内容
2)让获取的数据更有目的性,从而提高数据库检索数据的性能
MySQL索引主要有两种结构:B+Tree索引和Hash索引。
索引在MySQL中也叫做“键”,是存储引擎用于快速找到记录的一种数据结构
	* primary key

	* unique key

	* index key
1.上述的三个key都可以加快数据查询
2.primary key和unique key除了可以加快查询本身还自带限制条件而index key很单一就是用来加快数据查询
3.外键不属于索引键的范围 是用来建立关系的 与加快查询无关
索引加快查询的本质
	id int primary key auto_increment,

 	name varchar(32) unique,

  	province varchar(32)

 	age int

 	phone bigint

	select name from userinfo where phone=18818888888;  # 一页页的翻

	select name from userinfo where id=99999;  # 按照目录确定页数找
索引可以加快数据查询 但是会降低增删的速度
通常情况下我们频繁使用某些字段查询数据
为了提升查询的速度可以将该字段建立索引
聚集索引(primary key)
主键、主键索引
辅助索引(unique,index)
除主键意外的都是辅助索引,辅助索引其实本质上也是用的聚集索引的数据来查询的(用的主键的数据)
覆盖索引
select name from user where name='jason';
所谓覆盖索引就是条件中的字段名和查看的字段名称相同
非覆盖索引
select age from user where name='jason';
九、索引数据结构
索引的底层其实是树结构>>>:树是计算机底层的数据结构
树有很多中类型
二叉树、b树、b+树、B*树......
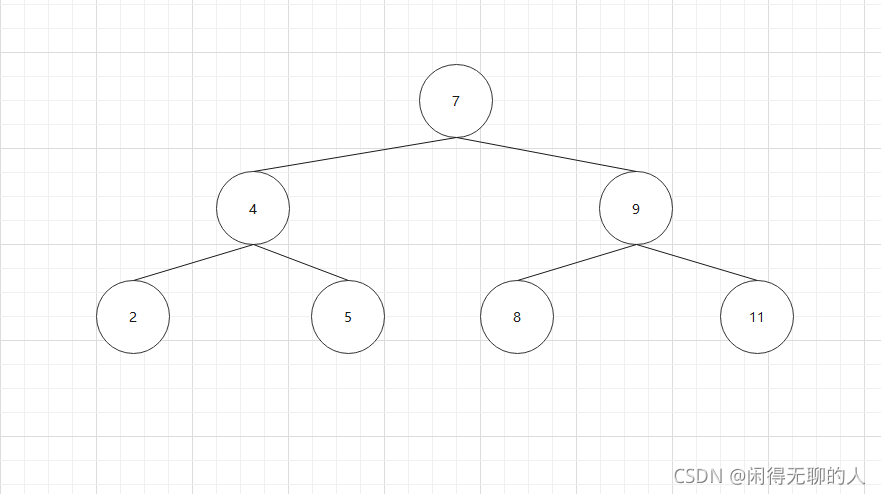
二叉树
二叉树里面还可以细分成很多领域,我们简单的了解即可。
二叉树的特点:每个节点最多有2个分叉,左子树和右子树数据顺序左小右大。
B树(B-Tree)
MySQL的数据是存储在磁盘文件中的,查询数据时需要先把磁盘中的数据加载到内存中,磁盘IO操作非常耗时,所以我们优化的重点就是尽量减少磁盘IO操作,所以,我们应当尽量减少从磁盘中读取数据的次数。另外,从磁盘中读取数据时,都是按照磁盘块来读取的,并不是一条一条的读。如果我们能把尽量多的数据放进磁盘块中,那一次磁盘读取操作就会读取更多数据,那我们查找数据的时间也会大幅度降低。
如果我们用树这种数据结构作为索引的数据结构,那我们每查找一次数据就需要从磁盘中读取一个节点,也就是我们说的一个磁盘块。我们都知道平衡二叉树可是每个节点只存储一个键值和数据的。那说明什么?说明每个磁盘块仅仅存储一个键值和数据!那如果我们要存储海量的数据呢?
可以想象到二叉树的节点将会非常多,高度也会极其高,我们查找数据时也会进行很多次磁盘IO,我们查找数据的效率将会极低!
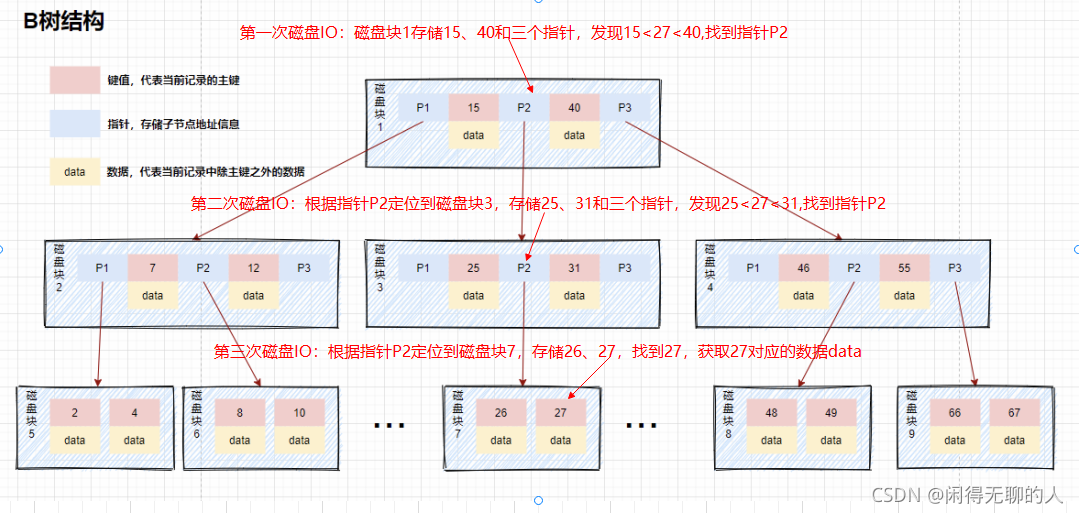
为了解决平衡二叉树的这个弊端,B树应运而生, B树是一种多叉平衡查找树,主要的特点是:
1、叶子节点都在同一层,叶子节点没有指针连接
2、B树的节点中存储着多个元素,每个内节点有多个分叉
3、节点中的元素包含键值和数据,节点中的键值从大到小排列
4、所有的节点都可以存放完整的数据
下面模拟下查找key为27的data的过程:
存在的一些问题:
- B树中每个节点中包含key值以及data值,而每一个节点的存储空间是有限的(MySQL默认16K),如果data中存放的数据较大时,将会导致每个节点能存储的key的数量很小,所以当数据量很多,且每行数据量很大的时候,同样会导致树的高度变得很高,增大查询时的磁盘IO次数,进而影响查询效率。
- 不支持范围查询的快速查找,而在实际的应用中,数据库范围查询的频率非常高,以下的一种情况是我查找10和35之间的数据,查找到15之后,需要回到根节点重新遍历查找,需要从根节点进行多次遍历,查询效率有待提高。
B+\B*树
只有叶子节点才会存放真正的数据 其他节点只存放索引数据
B+树
B+叶子节点增加了指向其他叶子节点的指针
对比B树和B+树,我们发现二者主要存在以下几点不同的地方:
- 数据都存放在叶子节点中
- 非叶子节点只存储键值信息,不再存储数据
- 所有叶子节点之间都有一个指针,指向下一个叶子节点,而且叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表
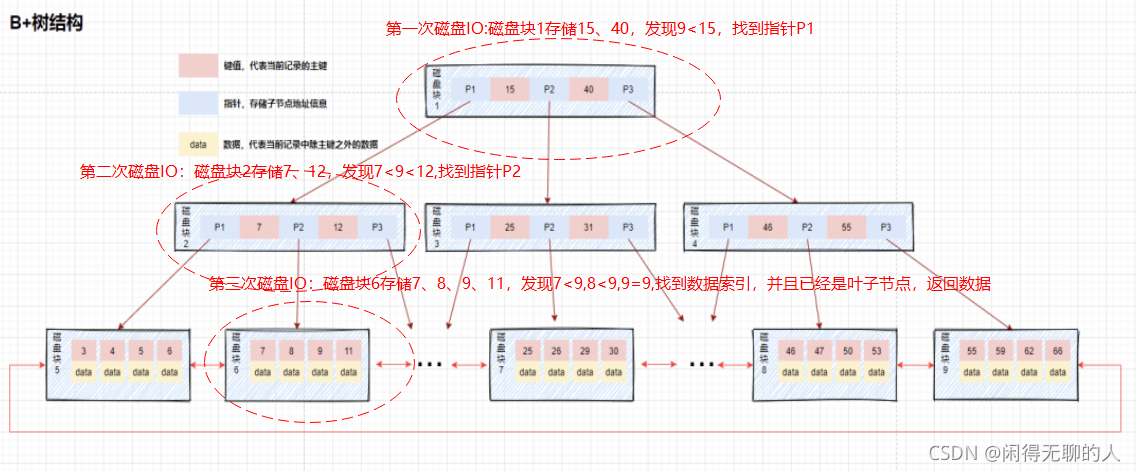
等值查询
下面模拟下查找key为9的data的过程:
范围查询
下面模拟下查找key的范围为9到26这个范围的data的过程:
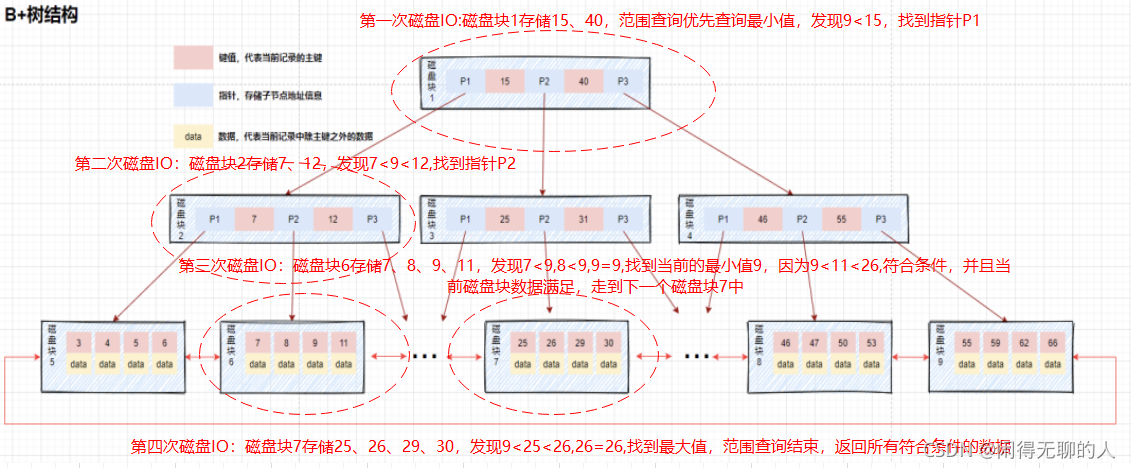
从上面的结果,我们可以知道B+树作为索引结构带来的好处:
- 磁盘IO次数更少
- 数据遍历更为方便
- 查询性能更稳定
由于B+树优秀的结构特性,在MySQL中,存储引擎MyISAM和InnoDB的索引就采用了B+树的数据结构。
B*树
B*叶子节点和枝节点都有指向其他节点的指针
ps:
- 辅助索引在查询数据的时候最会还是需要借助于聚集索引
- 辅助索引叶子节点存放的是数据的主键值
- 有时候就算采用索引字段查询数据 也可能不会走索引!!!
索引失效的几种情况
1.前导模糊查询不能利用索引(like '%XX'或者like '%XX%')
'A%'就可以正常使用索引
2.如果mysql估计使用全表扫描要比使用索引快,则不使用索引
3.OR前后存在非索引的列,索引失效
如果条件中有or,即使其中有条件带索引也不会使用(这也是为什么尽量少用or的原因)
要想使用or,又想让索引生效,只能将or条件中的每个列都加上索引
4.普通索引的不等于不会走索引;如果是主键,则还是会走索引;如果是主键或索引是整数类型,则还是会走索引
5.组合索引最左前缀
    如果组合索引为:(name,email)

    name and email -- 使用索引

    name -- 使用索引

    email -- 不使用索引
6.is null可以使用索引,is not null无法使用索引
最好在设计表时设置NOT NULL约束,比如将INT类型的默认值设为0,将字符串默认值设为''。
7.计算、函数导致索引失效另外一种情况
#使用到了索引

explain select * from student_info where name like 'li%';

#未使用索引,花费时间更久

explain select * from student_info where LEFT(name,2)='li';
扩展:
如果列类型是字符串,那一定要在条件中将数据使用引号引用起来,否则不使用索引
#不会使用name的索引

explain select * from student_info where name=123;

#使用到索引

explain select * from student_info where name='123';
如上,name字段是VARCAHR类型的,但是比较的值是INT类型的,name的值会被隐式的转换为INT类型再比较,中间相当于有一个将字符串转为INT类型的函数。这也相当于是函数导致的索引失效。
8.字符集不统一
统一使用utf8mb4( 5.5.3 版本以上支持 ) 兼容性更好,统一字符集可以避免由于字符集转换产生的乱码。不同的 字符集 进行比较前需要进行 转换 会造成索引失效。。
ps:最好能记三个左右的特殊情况
十、慢查询优化
我们使用explain方法来查看语句的索引扫描类型。
1、Explain是什么?
- 主键自动建立唯一索引。
- 频繁作为查询条件的字段应该创建索引。
- 查询中与其他表关联的字段,外键关系建立索引。
- 单键/组合索引的选择问题,组合索引性价比更高。
- 查询中排序的字段,排序字段若通过索引去访问将大大提高排序速度。
- 查询中统计或者分组字段。
2、Explain能干什么?
- 表的读取顺序
- 数据读取操作的操作类型
- 哪些索引可以使用
- 哪些索引可以被实际使用
- 表之间的引用
- 每张表有多少行被优化器查询
3、怎么用
- explain + SQL
- 执行计划包含的信息
+----+-------------+-------+-------+---------------+-----+---------+------+------+-------+

| id | select_type | table | type  | possible_keys | key | key_len | ref  | rows | Extra |

+----+-------------+-------+-------+---------------+-----+---------+------+------+-------+
4、常见的索引扫描类型:
1)index
2)range
3)ref
4)eq_ref
5)const
6)system
7)null
索引扫描类型详解
生产中,mysql在使用全表扫描时的性能是极其差的,所以MySQL尽量避免出现全表扫描
从上到下,性能从最差到最好,我们认为至少要达到range级别
index:Full Index Scan,index与ALL区别为index类型只遍历索引树。
range:索引范围扫描,对索引的扫描开始于某一点,返回匹配值域的行。显而易见的索引范围扫描是带有between或者where子句里带有<,>查询。
| mysql> alter table city add index idx_city(population); | |
|---|---|
| mysql> explain select * from city where population>30000000; |
ref:使用非唯一索引扫描或者唯一索引的前缀扫描,返回匹配某个单独值的记录行。
| mysql> alter table city drop key idx_code; | |
|---|---|
| mysql> explain select * from city where countrycode='chn'; | |
| mysql> explain select * from city where countrycode in ('CHN','USA'); | |
| mysql> explain select * from city where countrycode='CHN' union all select * from city where countrycode='USA'; |
eq_ref:类似ref,区别就在使用的索引是唯一索引,对于每个索引键值,表中只有一条记录匹配,简单来说,就是多表连接中使用primary key或者 unique key作为关联条件A
| join B | |
|---|---|
| on A.sid=B.sid |
const、system:当MySQL对查询某部分进行优化,并转换为一个常量时,使用这些类型访问。
如将主键置于where列表中,MySQL就能将该查询转换为一个常量
mysql> explain select * from city where id=1000;
NULL:MySQL在优化过程中分解语句,执行时甚至不用访问表或索引,例如从一个索引列里选取最小值可以通过单独索引查找完成。
mysql> explain select * from city where id=1000000000000000000000000000;
Extra(扩展)
Using temporary
Using filesort 使用了默认的文件排序(如果使用了索引,会避免这类排序)
Using join buffer
如果出现Using filesort请检查order by ,group by ,distinct,join 条件列上没有索引
mysql> explain select * from city where countrycode='CHN' order by population;
当order by语句中出现Using filesort,那就尽量让排序值在where条件中出现
| mysql> explain select * from city where population>30000000 order by population; | |
|---|---|
| mysql> select * from city where population=2870300 order by population; |
key_len: 越小越好
- 前缀索引去控制
rows: 越小越好
十一、测试索引
准备
#1. 准备表

create table s1(

id int,

name varchar(20),

gender char(6),

email varchar(50)

);

#2. 创建存储过程,实现批量插入记录

delimiter $$ #声明存储过程的结束符号为$$

create procedure auto_insert1()

BEGIN

    declare i int default 1;

    while(i<3000000)do

        insert into s1 values(i,'jason','male',concat('jason',i,'@oldboy'));

        set i=i+1;

    end while;

END$$ #$$结束

delimiter ; #重新声明分号为结束符号

# 由于这里要加三百万调记录要很久

#3. 查看存储过程

show create procedure auto_insert1\G

#4. 调用存储过程

call auto_insert1();
# 表没有任何索引的情况下

select * from s1 where id=30000;

# 避免打印带来的时间损耗

select count(id) from s1 where id = 30000;

select count(id) from s1 where id = 1;

# 给id做一个主键

alter table s1 add primary key(id);  # 速度很慢

select count(id) from s1 where id = 1;  # 速度相较于未建索引之前两者差着数量级

select count(id) from s1 where name = 'jason'  # 速度仍然很慢

"""

范围问题

"""

# 并不是加了索引,以后查询的时候按照这个字段速度就一定快

select count(id) from s1 where id > 1;  # 速度相较于id = 1慢了很多

select count(id) from s1 where id >1 and id < 3;

select count(id) from s1 where id > 1 and id < 10000;

select count(id) from s1 where id != 3;

alter table s1 drop primary key;  # 删除主键 单独再来研究name字段

select count(id) from s1 where name = 'jason';  # 又慢了

create index idx_name on s1(name);  # 给s1表的name字段创建索引

select count(id) from s1 where name = 'jason'  # 仍然很慢!!!

"""

再来看b+树的原理,数据需要区分度比较高,而我们这张表全是jason,根本无法区分

那这个树其实就建成了“一根棍子”

"""

select count(id) from s1 where name = 'xxx';

# 这个会很快,我就是一根棍,第一个不匹配直接不需要再往下走了

select count(id) from s1 where name like 'xxx';

select count(id) from s1 where name like 'xxx%';

select count(id) from s1 where name like '%xxx';  # 慢 最左匹配特性

# 区分度低的字段不能建索引

drop index idx_name on s1;

# 给id字段建普通的索引

create index idx_id on s1(id);

select count(id) from s1 where id = 3;  # 快了

select count(id) from s1 where id*12 = 3;  # 慢了  索引的字段一定不要参与计算

drop index idx_id on s1;

select count(id) from s1 where name='jason' and gender = 'male' and id = 3 and email = 'xxx';

# 针对上面这种连续多个and的操作,mysql会从左到右先找区分度比较高的索引字段,先将整体范围降下来再去比较其他条件

create index idx_name on s1(name);

select count(id) from s1 where name='jason' and gender = 'male' and id = 3 and email = 'xxx';  # 并没有加速

drop index idx_name on s1;

# 给name,gender这种区分度不高的字段加上索引并不难加快查询速度

create index idx_id on s1(id);

select count(id) from s1 where name='jason' and gender = 'male' and id = 3 and email = 'xxx';  # 快了  先通过id已经讲数据快速锁定成了一条了

select count(id) from s1 where name='jason' and gender = 'male' and id > 3 and email = 'xxx';  # 慢了  基于id查出来的数据仍然很多,然后还要去比较其他字段

drop index idx_id on s1

create index idx_email on s1(email);

select count(id) from s1 where name='jason' and gender = 'male' and id > 3 and email = 'xxx';  # 快 通过email字段一剑封喉
1、联合索引
select count(id) from s1 where name='jason' and gender = 'male' and id > 3 and email = 'xxx';

# 如果上述四个字段区分度都很高,那给谁建都能加速查询

# 给email加然而不用email字段

select count(id) from s1 where name='jason' and gender = 'male' and id > 3;

# 给name加然而不用name字段

select count(id) from s1 where gender = 'male' and id > 3;

# 给gender加然而不用gender字段

select count(id) from s1 where id > 3;

# 带来的问题是所有的字段都建了索引然而都没有用到,还需要花费四次建立的时间

create index idx_all on s1(email,name,gender,id);  # 最左匹配原则,区分度高的往左放

select count(id) from s1 where name='jason' and gender = 'male' and id > 3 and email = 'xxx';  # 速度变快
总结:上面这些操作,你感兴趣可以敲一敲,不感兴趣你就可以不用敲了,权当看个乐呵。理论掌握了就行了
慢查询日志
设定一个时间检测所有超出该时间的sql语句,然后针对性的进行优化!
2、全文检索
使用Mysql全文检索fulltext的先决条件
表的类型必须是MyISAM
建立全文检索的字段类型必须是char,varchar,text
MySQL的全文检索功能MYISAM存储引擎支持而InnoDB存储引擎不支持

一般在创建表的时候启用全文检索功能

create table t1(

	id int primary key auto_increment,

  content text

	fulltext(content)

)engine=MyISAM;

# match括号内的值必须是fulltext括号中定义的(单个或者多个)

select content from t1 where match(content) against('jason')

'''上述语句可以用like实现但是查询出来的结果顺序不同 全文检索会以文本匹配的良好程度排序数据再返回效果更佳'''

# 查询扩展

select note_text from productnotes where Math(note_text) Against('jason' with query expansion);

"""

返回除jason外以及其他jason所在行相关文本内容行数据

eg:

	jason is handsome and cool,every one want to be cool,tony want to be more handsome;

	二三句虽然没有jason关键字 但是含有jason所在行的cool和handsome

"""

# 布尔文本搜索

即使没有定义fulltext也可以使用,但是这种方式非常缓慢性能低下

select note_text from productnotes where Match(note_text) Against('jason' in boolean mode);

# 注意事项

1.三个及三个以下字符的词视为短词,全文检索直接忽略且从索引中排除

2.MySQL自身自带一个非用词列表,表内词默认均被忽略(可以修改该列表)

3.出现频率高于50%的词自动作为非用词忽略,该规则不适用于布尔搜索

4.针对待搜索的文本内容不能少于三行,否则检索不返回任何结果

5.单引号默认忽略
3、插入数据
数据库经常被多个用户访问,insert操作可能会很耗时(特别是有很多索引需要更新的时候)而且还可能降低等待处理的select语句性能

如果数据检索是最重要的(一般都是),则可以通过在insert与into之间添加关键字low_priority指示MySQL降低insert语句优先级

	insert low_priority  into

insert还可以将一条select语句的结果插入表中即数据导入:insert select

eg:想从custnew表中合并数据到customers表中

  insert into customers(contact,email) select contact,email from custnew;
4、更新数据
如果使用update语句更新多列值,并且在更新这些列中的一列或者多列出现一个错误会导致整个update操作被取消,如果想发生错误也能继续执行没有错误的更新操作可以采用

	update ignore custmoers ...

  """

  update ignore  set name='jason1',id='a' where id=1;

  	name字段正常修改

  update set name='jason2',id='h' where id=1;

  	全部更新失败

  """
5、删除数据
- delete语句从表中删除数据,甚至可以是所有数据但是不会删除表本身
- 并且如果想从表中删除所有的行不要使用delete可以使用truncate速度更快并且会重置主键值(实际是删除原来的表并重新创建一个表而不是逐行删除表中的数据)
6、主键
查看当前表主键自增到的值(表当前主键值减一)

	select last_insert_id();
7、外键
MySQL存储引擎可以混用,但是外键不能跨引擎即使用一个引擎的表不能引用具有使用不同引擎表的外键
8、重命名表
rename关键字可以修改一个或者多个表名

	rename table customer1 to customer2;

	rename table back_cust to b_cust,

	back_cust1 to b_cust1,

	back_cust2 to b_cust2;
9、安全管理
1.创建用户

	create user 用户名 identified by '密码';

 	"""修改密码"""

  	set password for 用户名 = Password('新密码');

    set password = Password('新密码');  # 针对当前登录用户

2.重命名

	rename user 新用户名 to 旧用户名;

3.删除用户

	drop user 用户名;

4.查看用户访问权限

	show grants for 用户名;

5.授予访问权限

	grant select on db1.* to 用户名;

  # 授予用户对db1数据库下所有表使用select权限

6.撤销权限

	revoke select on db1.* from 用户名;

"""

整个服务器

	grant all/revoke all

整个数据库

	on db.*

特定的表

	on db.t1

"""
10、隔离级别
在SQL标准中定义了四种隔离级别,每一种级别都规定了一个事务中所做的修改

InnoDB支持所有隔离级别

	set transaction isolation level 级别

1.read uncommitted(未提交读)

	事务中的修改即使没有提交,对其他事务也都是可见的,事务可以读取未提交的数据,这一现象也称之为"脏读"

2.read committed(提交读)

	大多数数据库系统默认的隔离级别

  一个事务从开始直到提交之前所作的任何修改对其他事务都是不可见的,这种级别也叫做"不可重复读"

3.repeatable read(可重复读)		# MySQL默认隔离级别

	能够解决"脏读"问题,但是无法解决"幻读"

  所谓幻读指的是当某个事务在读取某个范围内的记录时另外一个事务又在该范围内插入了新的记录,当之前的事务再次读取该范围的记录会产生幻行,InnoDB和XtraDB通过多版本并发控制(MVCC)及间隙锁策略解决该问题

4.serializable(可串行读)

	强制事务串行执行,很少使用该级别
11、锁
读锁(共享锁)

	多个用户同一时刻可以同时读取同一个资源互不干扰

写锁(排他锁)

	一个写锁会阻塞其他的写锁和读锁

死锁

	1.多个事务试图以不同的顺序锁定资源时就可能会产生死锁

  2.多个事务同时锁定同一个资源时也会产生死锁

	# Innodb通过将持有最少行级排他锁的事务回滚
12、事务日志
事务日志可以帮助提高事务的效率

	存储引擎在修改表的数据时只需要修改其内存拷贝再把该修改记录到持久在硬盘上的事务日志中,而不用每次都将修改的数据本身持久到磁盘

  事务日志采用的是追加方式因此写日志操作是磁盘上一小块区域内的顺序IO而不像随机IO需要次哦按的多个地方移动磁头所以采用事务日志的方式相对来说要快的多

  事务日志持久之后内存中被修改的数据再后台可以慢慢刷回磁盘,目前大多数存储引擎都是这样实现的,通常称之为"预写式日志"修改数据需要写两次磁盘
13、MVCC多版本控制
MVCC只能在read committed(提交读)、repeatable read(可重复读)两种隔离级别下工作,其他两个不兼容(read uncommitted:总是读取最新  serializable:所有的行都加锁)

InnoDB的MVCC通过在每行记录后面保存两个隐藏的列来实现MVCC

	一个列保存了行的创建时间

  一个列保存了行的过期时间(或删除时间)  # 本质是系统版本号

每开始一个新的事务版本号都会自动递增,事务开始时刻的系统版本号会作为事务的版本号用来和查询到的每行记录版本号进行比较

例如

刚插入第一条数据的时候,我们默认事务id为1,实际是这样存储的

    username		create_version		delete_version

    jason						1

可以看到,我们在content列插入了kobe这条数据,在create_version这列存储了1,1是这次插入操作的事务id。

然后我们将jason修改为jason01,实际存储是这样的

    username		create_version		delete_version

    jason						1									2

    jason01					2

可以看到,update的时候,会先将之前的数据delete_version标记为当前新的事务id,也就是2,然后将新数据写入,将新数据的create_version标记为新的事务id

当我们删除数据的时候,实际存储是这样的

		username		create_version		delete_version

    jason01					2									 3

"""

由此当我们查询一条记录的时候,只有满足以下两个条件的记录才会被显示出来:

   1.当前事务id要大于或者等于当前行的create_version值,这表示在事务开始前这行数据已经存在了。

   2.当前事务id要小于delete_version值,这表示在事务开始之后这行记录才被删除。

"""
14、转换表的引擎
主要有三种方式,并各有优缺点!

# 1.alter table

	alter table t1 engine=InnoDB;

  """

  	适用于任何存储引擎 但是需要执行很长时间 MySQL会按行将数据从原表赋值到一张新的表中,在复制期间可能会消耗系统所有的IO能力,同时原表会加读锁

  """

# 2.导入导出

	"""

	使用mysqldump工具将数据导出到文件,然后修改文件中相应的SQL语句

		1.引擎选项

		2.表名

	"""

# 3.insert ... select

	"""

	综合了第一种方案的高效和第二种方案的安全

		1.先创建一张新的表

		2.利用insert ... select语法导数据

	数据量不大这样做非常合适 数据量大可以考虑分批处理 针对每一段数据执行事务提交操作避免产生过多的undo

	"""

  ps:上述操作可以使用pt-online-schema-change(基于facebook的在线schema变更技术)工具,简单方便的执行上述过程
十二、作业
课下自行百度什么是数据库三大范式
数据库三大范式
1、第一范式(1NF)是指数据库表的每一列都是不可分割的基本数据线;也就是说:每列的值具有原子性,不可再分割。
2、第二范式(2NF)是在第一范式(1NF)的基础上建立起来得,满足第二范式(2NF)必须先满足第一范式(1NF)。如果表是单主键,那么主键以外的列必须完全依赖于主键;如果表是复合主键,那么主键以外的列必须完全依赖于主键,不能仅依赖主键的一部分。
3、第三范式(3NF)是在第二范式的基础上建立起来的,即满足第三范式必须要先满足第二范式。第三范式(3NF)要求:表中的非主键列必须和主键直接相关而不能间接相关;也就是说:非主键列之间不能相关依赖。
11月29日内容总结——SQL注入问题、视图、触发器、事务、存储过程、函数、流程控制、索引、慢查询、数据库三大范式的更多相关文章
- 2016年11月29日 星期二 --出埃及记 Exodus 20:20
2016年11月29日 星期二 --出埃及记 Exodus 20:20 Moses said to the people, "Do not be afraid. God has come t ...
- 20162311 解读同伴的收获&解决同伴的问题(11月29日,周三)
20162311 解读同伴的收获&解决同伴的问题(11月29日,周三) 解读同伴的收获 我的同组同学是20162325学号金立清同学 同组同学的收获是:递归算法的非递归实现.分治法.动态规划法 ...
- 北京Uber优步司机奖励政策(11月23日~11月29日)
用户组:人民优步"关羽组"(适用于11月23日-11月29日)奖励政策: 滴快车单单2.5倍,注册地址:http://www.udache.com/ 如何注册Uber司机(全国版最 ...
- 打开随身U盘_办公专用盘 2019年11月29日
;;; ; 打开随身U盘_办公专用盘 2019年11月29日 ; https://www.autoahk.com/?p=16553; https://www.cnblogs.com/delphixx/ ...
- sql注入问题-视图-事物-以及存储过程(可视化工具)
可视化工具(了解) 可视化工具 workbench 视图 视图 是一张虚拟的表 语法: create view 视图表名 as select * from t1; 作用: .他是执行as 后面的sql ...
- 11月29日 The Rails philosophy 完成rails on guide 的第一章getting started with rails
the rails philosophy includes two major guiding principles: Don't repeat yourself: DRY is a principl ...
- Appium最新的服务器初始化参数(Capability)【截止11月29日,后续最新的可以看github】
键 描述 值 automationName 自动化测试的引擎 Appium (默认)或者 Selendroid platformName 使用的手机操作系统 iOS, Android, 或者 Fire ...
- 对OpenGL的GLFrame框架进行的扩展截至2014年11月29日
框架源自<OpenGL游戏编程>,增加了此框架的部分功能.其中有些小错误,尤其是MD2模型的那章,给出的框架只支持载入一个BOSS,当再载入一个BOSS时,就会发现两个模型的帧速会乱套. ...
- 西安OpenParty11月29日活动高清图文回顾——新增西安APEC蓝美图!
本次活动由西安OpenParty负责线下活动组织运营,线上由InfoQ-QClub.OSChina协办. OSChina活动召集帖:运维为王——应用系统.DevOps与Docker(11月29日) I ...
- 11月16日《奥威Power-BI基于SQL的存储过程及自定义SQL脚本制作报表》腾讯课堂开课啦
上周的课程<奥威Power-BI vs微软Power BI>带同学们全面认识了两个Power-BI的使用情况,同学们已经迫不及待想知道这周的学习内容了吧!这周的课程关键词—— ...
随机推荐
- 新建Maui工程运行到IiOS物理设备提示 Could not find any available provisioning profiles for iOS 处理办法
在构建 MAUI App 或 MAUI Blazor 时,您可能会收到以下 Could not find any available provisioning profiles for iOS. Pl ...
- mysql 基础明细
1.mysql 没有 TOP,用limit实现 2.mysql having 聚合之后,对组操作,和GROUP By搭配 mysql where 聚合之前,对表和视图操作 3.where 子句的作用 ...
- warning: ‘setAxisX‘ is deprecated
解决 将 chart->setAxisX(valueAxisX,lineSeries); 改为: chart->addSeries(lineSeries); chart->creat ...
- chrome设置socket5代理
利用自带的参数命令打破一个死循环. chrome可执行文件 --show-app-list --proxy-server="SOCKS5://127.0.0.1:1080"
- python3小技巧总结(实时更新)
1.列表解析 如果一个想将一个列表中的大于0的数字过滤,一般可能会用到lambd结合filter,或者就是直接遍历,不过最好的解决办法是这样: b = [1,0,-1,-2] a = [i for i ...
- K8S 核心组件 kubelet 与 kube-proxy 分析
kubelet kubelet 进程用于处理master 下发的任务, 管理pod 中的容器, 注册 自身所在的节点. 节点管理 启动参数说明 --register-node #如果设置为true 则 ...
- .net core 中 WebApiClientCore的使用
WebApiClient 接口注册与选项 1 配置文件中配置HttpApiOptions选项 配置示例 "IUserApi": { "HttpHost": &q ...
- MySQL事务(四大特征)-存储过程
目录 一:事务 1.四大特性(ACID) 2.事物存在的必要性(真实比喻) 3.如何使用事务 4.开启事务-回滚-确认 二:事务案例实战 1.模拟消费 2.创建 3.插入数据 4.开启事务 5.修改操 ...
- 玩转 Go 生态|Hertz WebSocket 扩展简析
WebSocket 是一种可以在单个 TCP 连接上进行全双工通信,位于 OSI 模型的应用层.WebSocket 使得客户端和服务器之间的数据交换变得更加简单,允许服务端主动向客户端推送数据.在 W ...
- gtest学习教程(从0到1)
gtest使用教程 1 简介 之前对gtest一无所知,最近,找了些相关的资料,学习了下.这里主要记录了学习过程和相关知识点. 什么是gtest: gtest测试框架是在不同平台上(Linux,Mac ...