
1.3 Apache Hadoop的重要组成-hadoop-最全最完整的保姆级的java大数据学习资料
1.3 Apache Hadoop的重要组成
Hadoop=HDFS(分布式文件系统)+MapReduce(分布式计算框架)+Yarn(资源协调框架)+Common模块
- Hadoop HDFS:(Hadoop Distribute File System )一个高可靠、高吞吐量的分布式文件系统
比如:100T数据存储, “分而治之” 。分:拆分-->数据切割,100T数据拆分为10G一个数据块由一个电脑节点存储这个数据块。
数据切割、制作副本、分散储存
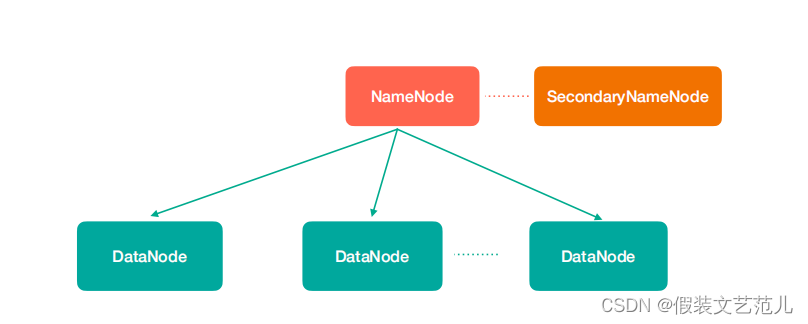
图中涉及到几个角色
NameNode(nn):存储文件的元数据,比如文件名、文件目录结构、文件属性(生成时间、副 本数、文件权限),以及每个文件的块列表和块所在的DataNode等。
SecondaryNameNode(2nn):辅助NameNode更好的工作,用来监控HDFS状态的辅助后台程序,每隔一段时间获取HDFS元数据快照。
DataNode(dn):在本地文件系统存储文件块数据,以及块数据的校验
注意:NN,2NN,DN这些既是角色名称,进程名称,代指电脑节点名称!!
Hadoop MapReduce:一个分布式的离线并行计算框架
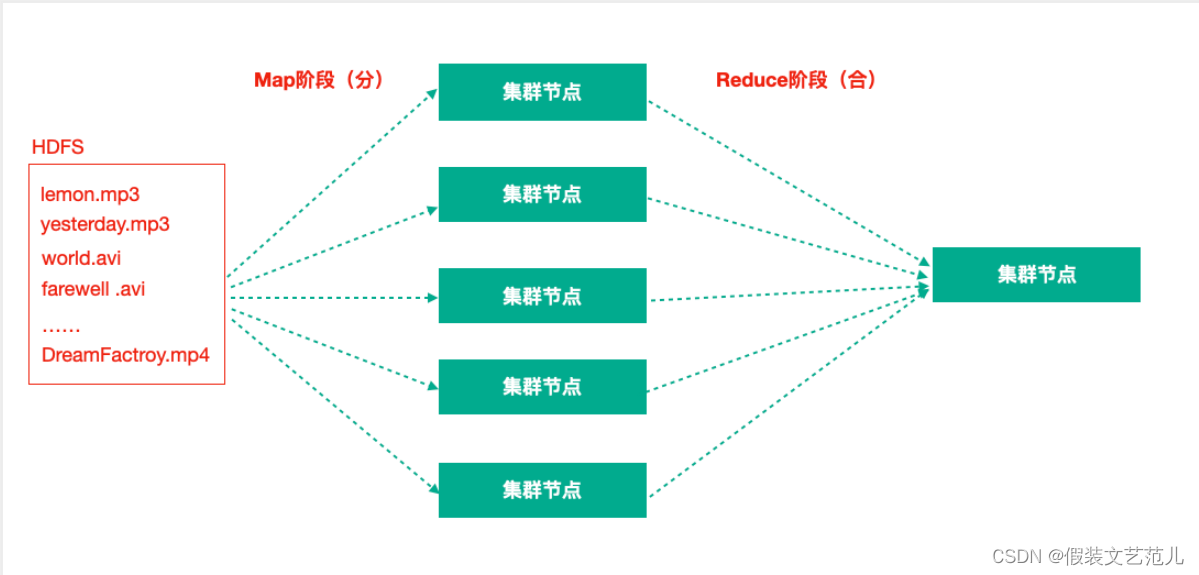
拆解任务、分散处理、汇整结果
MapReduce计算 = Map阶段 + Reduce阶段Map阶段就是“分”的阶段,并行处理输入数据
Reduce阶段就是“合”的阶段,对Map阶段结果进行汇总
Hadoop YARN:作业调度与集群资源管理的框架
计算资源协调
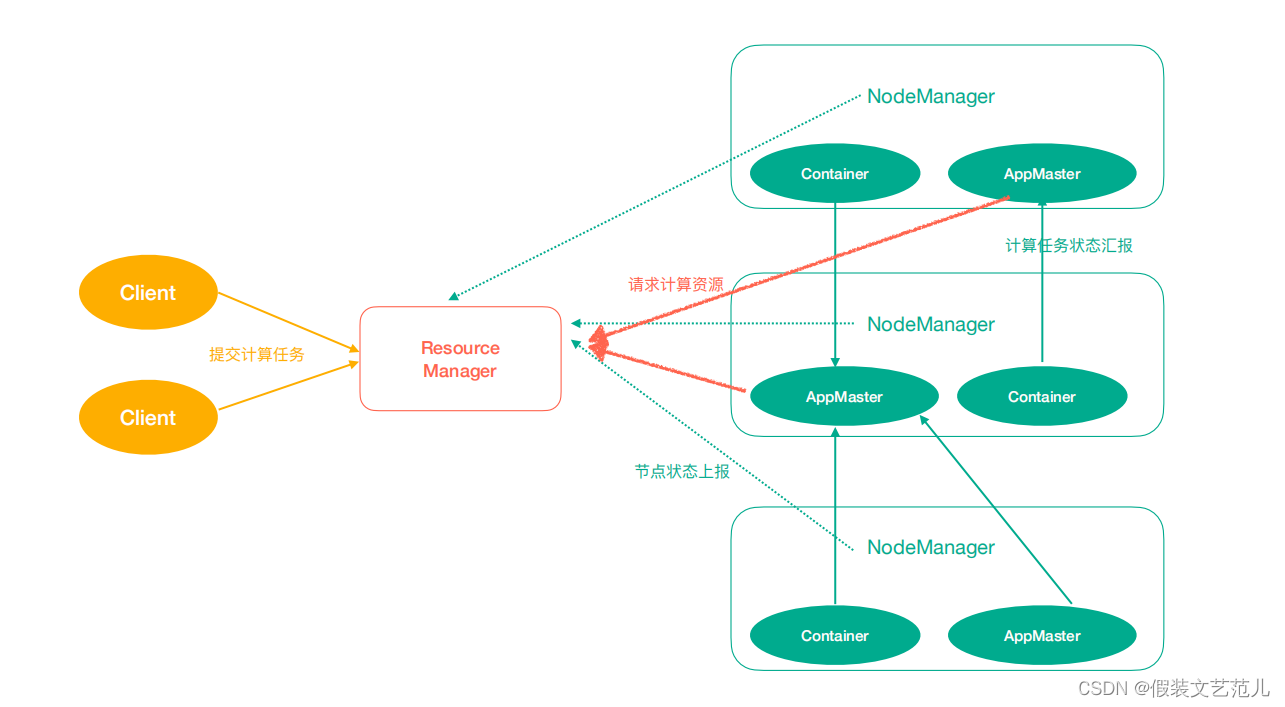
Yarn中有如下几个主要角色,同样,既是角色名、也是进程名,也指代所在计算机节点名称。
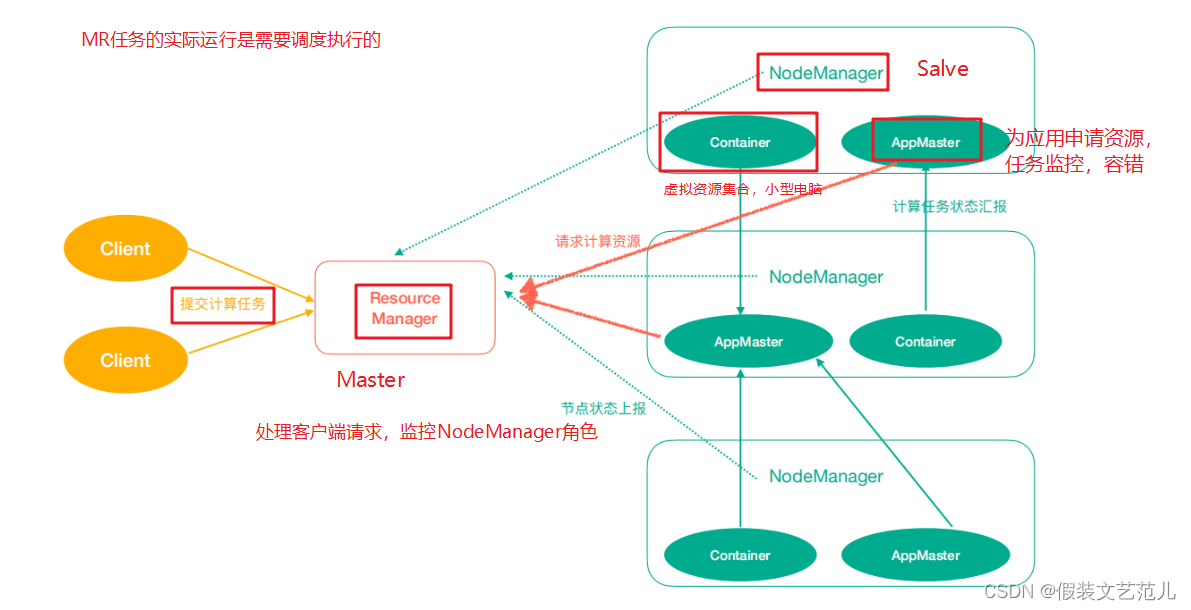
ResourceManager(rm):处理客户端请求、启动/监控ApplicationMaster、监控NodeManager、资源分配与调度;
NodeManager(nm):单个节点上的资源管理、处理来自ResourceManager的命令、处理来自ApplicationMaster的命令;
ApplicationMaster(am):数据切分、为应用程序申请资源,并分配给内部任务、任务监控与容错。
Container:对任务运行环境的抽象,封装了CPU、内存等多维资源以及环境变量、启动命令等任务运行相关的信息。
ResourceManager是老大,NodeManager是小弟,ApplicationMaster是计算任务专员。
- Hadoop Common:支持其他模块的工具模块(Configuration、RPC、序列化机制、日志操作)
1.3 Apache Hadoop的重要组成-hadoop-最全最完整的保姆级的java大数据学习资料的更多相关文章
- 大数据学习之Hadoop快速入门
1.Hadoop生态概况 Hadoop是一个由Apache基金会所开发的分布式系统集成架构,用户可以在不了解分布式底层细节情况下,开发分布式程序,充分利用集群的威力来进行高速运算与存储,具有可靠.高效 ...
- 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机)
引言 在大数据学习系列之一 ----- Hadoop环境搭建(单机) 成功的搭建了Hadoop的环境,在大数据学习系列之二 ----- HBase环境搭建(单机)成功搭建了HBase的环境以及相关使用 ...
- 大数据学习系列之六 ----- Hadoop+Spark环境搭建
引言 在上一篇中 大数据学习系列之五 ----- Hive整合HBase图文详解 : http://www.panchengming.com/2017/12/18/pancm62/ 中使用Hive整合 ...
- 大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 图文详解
引言 在之前的大数据学习系列中,搭建了Hadoop+Spark+HBase+Hive 环境以及一些测试.其实要说的话,我开始学习大数据的时候,搭建的就是集群,并不是单机模式和伪分布式.至于为什么先写单 ...
- 大数据学习笔记——Hadoop编程实战之HDFS
HDFS基本API的应用(包含IDEA的基本设置) 在上一篇博客中,本人详细地整理了如何从0搭建一个HA模式下的分布式Hadoop平台,那么,在上一篇的基础上,我们终于可以进行编程实操了,同样,在编程 ...
- java大数据最全课程学习笔记(1)--Hadoop简介和安装及伪分布式
Hadoop简介和安装及伪分布式 大数据概念 大数据概论 大数据(Big Data): 指无法在一定时间范围内用常规软件工具进行捕捉,管理和处理的数据集合,是需要新处理模式才能具有更强的决策力,洞察发 ...
- 大数据学习(一) | 初识 Hadoop
作者: seriouszyx 首发地址:https://seriouszyx.top/ 代码均可在 Github 上找到(求Star) 最近想要了解一些前沿技术,不能一门心思眼中只有 web,因为我目 ...
- 大数据学习系列之一 ----- Hadoop环境搭建(单机)
一.环境选择 1,服务器选择 阿里云服务器:入门型(按量付费) 操作系统:linux CentOS 6.8 Cpu:1核 内存:1G 硬盘:40G ip:39.108.77.250 2,配置选择 JD ...
- 大数据学习(1)Hadoop安装
集群架构 Hadoop的安装其实就是HDFS和YARN集群的配置,从下面的架构图可以看出,HDFS的每一个DataNode都需要配置NameNode的位置.同理YARN中的每一个NodeManager ...
- 大数据学习系列之八----- Hadoop、Spark、HBase、Hive搭建环境遇到的错误以及解决方法
前言 在搭建大数据Hadoop相关的环境时候,遇到很多了很多错误.我是个喜欢做笔记的人,这些错误基本都记载,并且将解决办法也写上了.因此写成博客,希望能够帮助那些搭建大数据环境的人解决问题. 说明: ...
随机推荐
- 第六章:Django 综合篇 - 15:Django与缓存
我们都知道Django建立的是动态网站,正常情况下,每次请求过来都经历了这样一个过程: 接收请求 -> url路由 -> 视图处理 -> 数据库读写 -> 视图处理 -> ...
- Elasticsearch: Join数据类型
在Elasticsearch中,Join可以让我们创建parent/child关系.Elasticsearch不是一个RDMS.通常join数据类型尽量不要使用,除非不得已.那么Elasticsear ...
- SC命令---安装、开启、配置、关闭windows服务 bat批处理
一.直接使用cmd来进行服务的一些操作 1.安装服务 sc create test3 binPath= "C:\Users\Administrator\Desktop\win32srvDem ...
- 【Java8新特性】- Optional应用
Java8新特性 - Optional应用 生命不息,写作不止 继续踏上学习之路,学之分享笔记 总有一天我也能像各位大佬一样 一个有梦有戏的人 @怒放吧德德 分享学习心得,欢迎指正,大家一起学习成长! ...
- 微信小程序js-时间转换函数使用
最近在做云开发博客小程序 采集微信发布的信息放入数据库会有createTime因此发现了不一样的地方 云函数可以直接使用 但是放到引导全局的app.js文件却是找不到该方法-->dateform ...
- for循环及range内置方法
目录 while循环补充说明 流程控制之for循环 range方法 rang实战案例 作业 """ 1.先写注释(思维逻辑和想法) 2.先考虑主体功能 在考虑附加功能 & ...
- dubbo的一系列配置与搭建
dubbo新的版本采用前后端分离技术,在github上下载的时候,不仅仅只是一个dubbo-admin 而是将admin包分离为dubbo-admin-ui前端包和dubbo-admin-server ...
- 小米MIUI禁止系统更新
删除downloaded_rom的文件夹,随便找一个文件(文件,不是文件夹),重名为downloaded_rom(是把一个文件重命名),这样系统后台偷偷下载时,就不知道该存放更新包的文件,就无法偷偷更 ...
- 十四、资源控制器之RS
RC (ReplicationController )主要的作用就是用来确保容器应用的副本数始终保持在用户定义的副本数 .即如果有容器异常退出,会自动创建新的 Pod 来替代:而如果异常多出来的容器也 ...
- JS逆向实战6-- x轴 y轴 过点触验证码
点触验证码是一种常见的反爬手段 解决方案有两种:一种是直接解决,这需要深度学习机器学习等图像处理技术,以大量的数据训练识别模型,最终达到模型足矣识别图片中的文字提示和应该点击的区域之间的对应关系. 这 ...