
Debiased Contrastive Learning of Unsupervised Sentence Representations 论文精读
1. 介绍(Introduction)
问题: 由PLM编码得到的句子表示在方向上分布不均匀, 在向量空间中占据一个狭窄的锥形区域, 这在很大程度上限制了它们的表达能力.
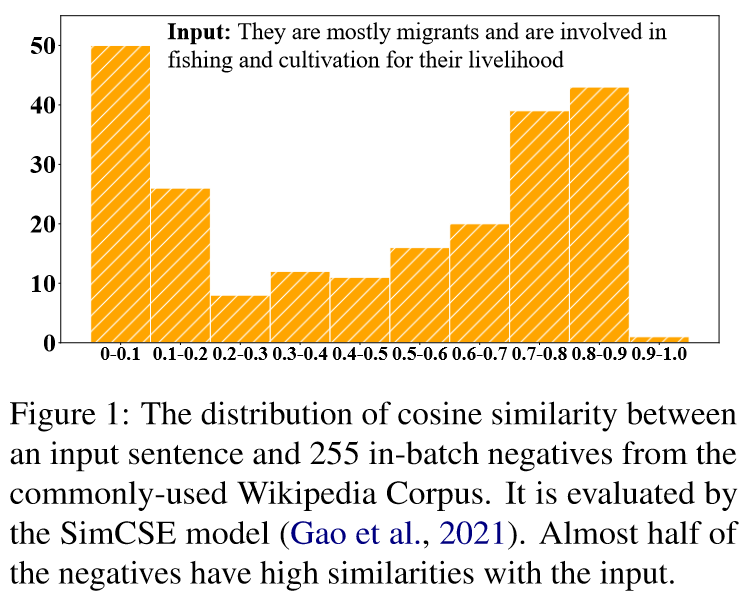
已有的解决办法: 对比学习. 对于一个原句, 构造他的正例(语义相似的句子)和负例(语义不相似的句子), 拉近语义相近的句子来提高对齐性,同时让语义不同的句子远离来使向量空间中的句子更均匀. 正例通常用数据增强的策略来获得. 由于没有真实标注的数据, 负例一般在一个batch中随机抽样得到. 但这可能会导致抽样偏差, 影响句子表示的学习. 表现在以下两个方面:
- 抽样的负例很可能是假负例, 他们在语义上其实是接近原句的. 如果简单地拉远些抽样得到的非负例, 很可能会损害句子表示的语义.
- 由于各向异性问题, 由PLMs得到的句子向量本身就在向量空间中仅占据一个狭窄的锥形区域, 从他们中随机抽取出的负例也不能完全反映表示空间的整体语义.
2. 方法(Approach)
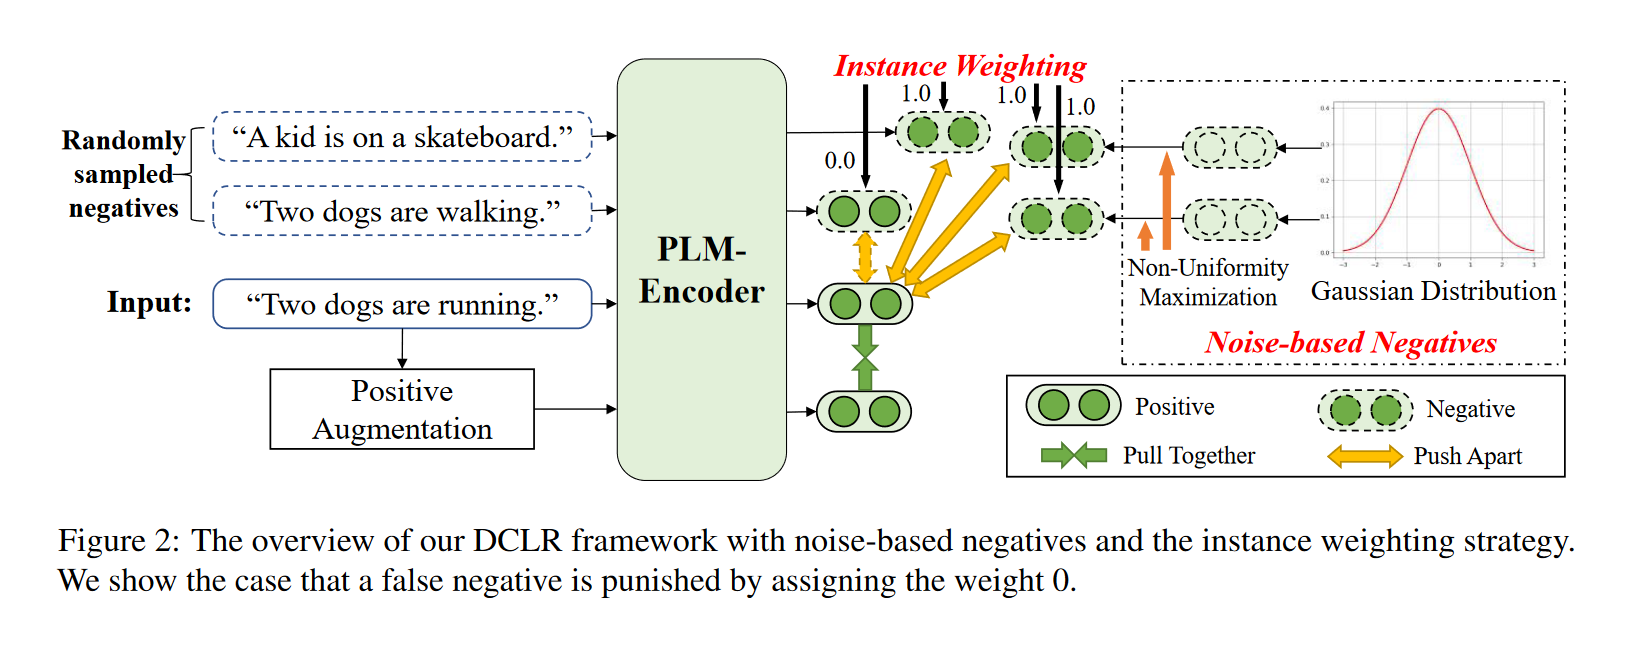
DCLR(a general framework towards Debiased Contrastive Learning of unsupervised sentence Representations), 一种无监督句子表示的去偏向对比学习的一般框架。
核心思想是改进随机负抽样策略, 以缓解抽样偏差问题:
- 设计了一种加权方法来惩罚训练过程中采样的假负例。用一个辅助模型(complementary model)来评估每个负例与原句之间的相似性,为相似性得分较高的负例分配较低的权重。
- 用基于随机高斯噪声随机初始化新负例来模拟整个语义空间内的采样,并设计了一种基于梯度的算法,将这些负例优化到最不均匀的点。
步骤:
从高斯分布初始化基于噪声负例,并利用基于梯度的算法, 通过考虑表示空间的均匀性来更新这些负例。
用辅助模型对这些基于噪声的负例和在batch中随机抽样的负例进行加权, 惩罚其中的假负例.
通过SimCSE中dropout的方式来获得正例, 并将其与上述加权负例相结合进行对比学习.
基于高斯噪声的负例的构建与优化:
- 构建: 对于每个输入句子\(x_i\),我们首先初始化\(k\)个来自高斯分布的噪声向量作为负例:
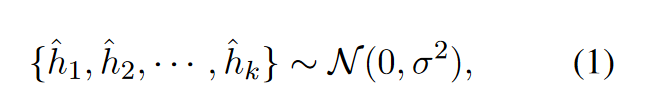
- 非均匀性损失(non-uniformity loss)来优化这些负例向量:
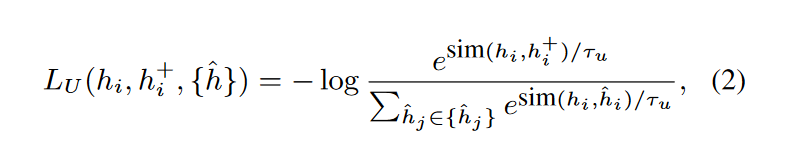
梯度下降:
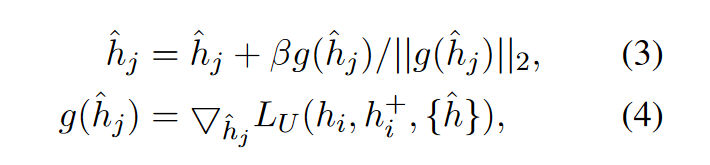
这样,基于噪声的负例将朝着句子表示空间的非均匀点进行优化. 通过学习对比这些负例, 可以进一步提高表征空间的均匀性, 这对于得到更有效的句子表示至关重要.
辅助模型(complementary model):
使用SOTA模型SimCSE作为辅助模型, 用于判断句子间的语义相似度. 具体的:
对于一个句子\(s_i\), 定义它的向量表示为\(h_i\), 从batch中随机抽取的负例为\(\set{\tilde{h}}\), 基于噪声构造的的负例为\(\set{\hat{h}}\), 对于来自\(\set{\tilde{h}}\)和\(\set{\hat{h}}\)的负例\(h^-\), 其权重为:
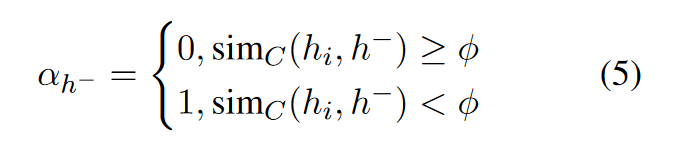
其中\(\phi\)是超参数, \(\text{sim}_C(h_i, h^-)\)表示SimCSE的相似度打分. 相当于直接舍弃了阈值小于\(\phi\)的负例.
对比学习的损失
最后, 对比学习的损失函数如下:
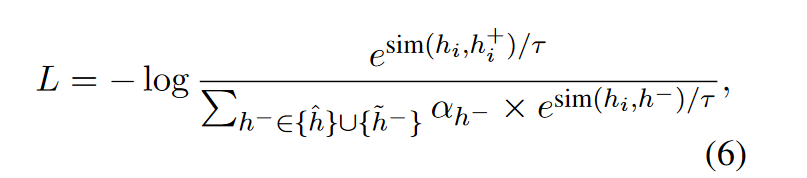
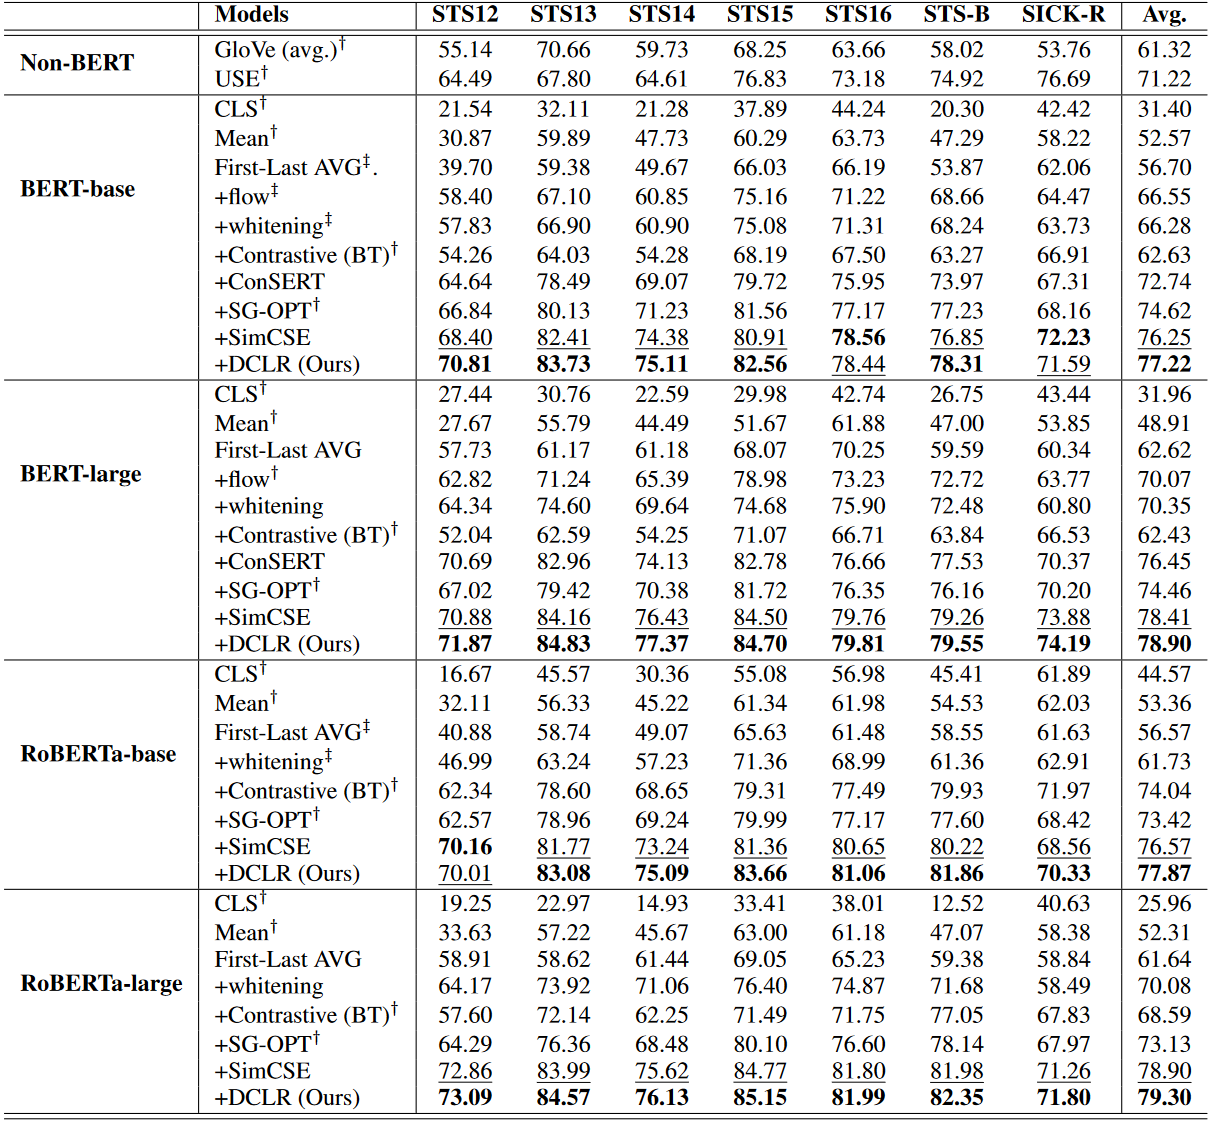
3. 性能(Performance)
4. 分析(Analysis)
4.1 超参数分析(Hyper-parameters Analysis)
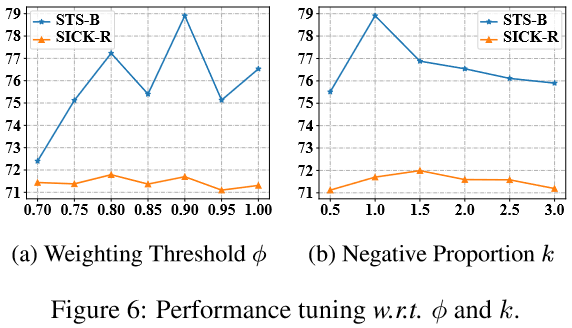
\(k\)表示基于噪声的负例数量与批量大小的比值.
4.2 均匀性分析(Uniformity Analysis)
用一下损失来评估句子表示的均匀性:
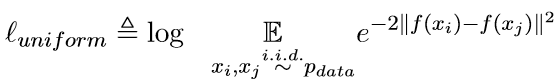
该损失值越小说明分布越均匀.
含义: 希望来自数据分布的句子之间欧氏距离的期望尽可能大.
与SimCSE的对比:
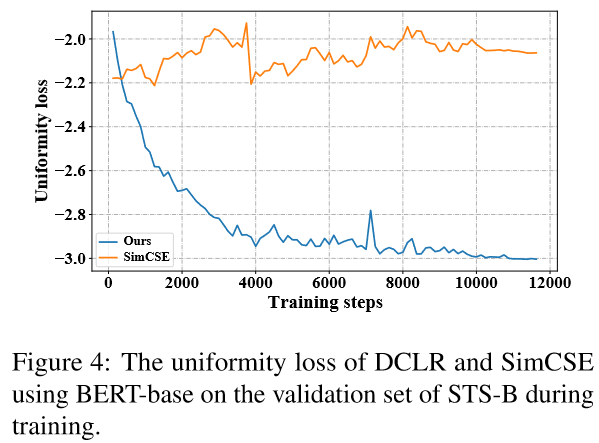
因为DCLR在表示空间之外对基于噪声的负例进行了采样, 这样可以更好地提高句子表示的均匀性.
有个问题, 文章没有对对齐性(Alignment)进行分析.
4.3 消融实验(Ablation Study)
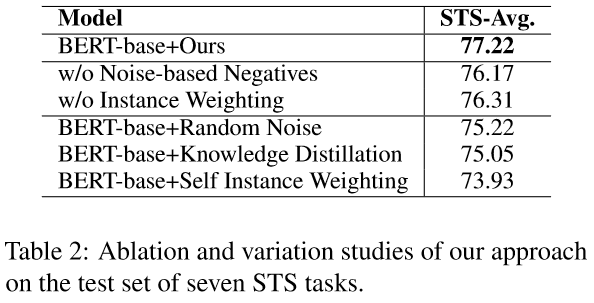
随机噪声(Random Noise): 直接生成基于噪声的负例, 不进行基于梯度的优化.
知识蒸馏(Knowledge Distillation): 利用SimCSE作为教师模型,在训练时将知识蒸馏到学生模型中.
自加权(Self Instance Weighting): 采用模型本身作为辅助模型来生成权重.
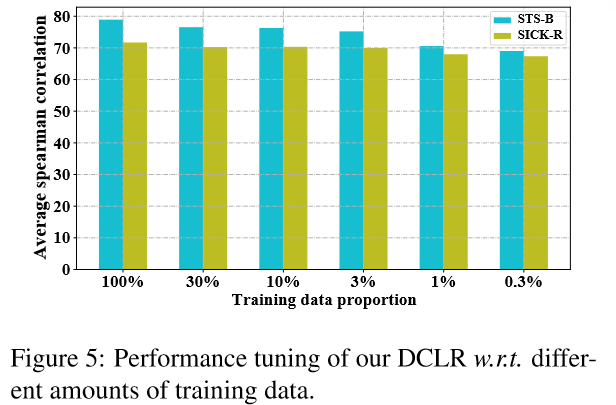
4.4 少样本下的性能(Performance under Few-shot Settings)
4.5 采用其他正例生成策略(Debiased Contrastive Learning on Other Methods)
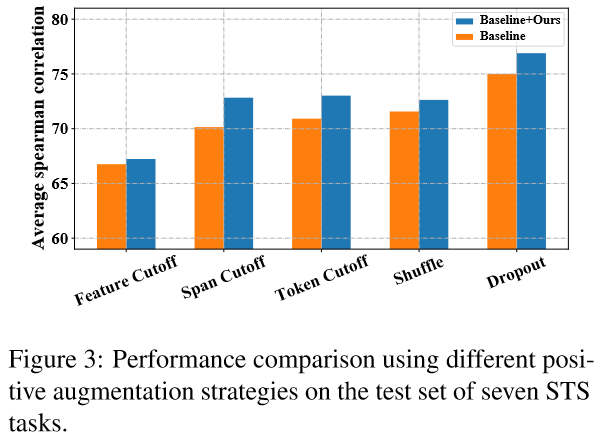
DCLR主要关注的是对比学习中的负例采样策略, 因此在构建正例时, 有多种数据增强策略可选. 文中测试了3种:
- 乱序(Token Shuffing): 随机打乱输入序列中token的顺序
- 删词(Feature/Token/Span Cutoff): 随机去掉输入中的features/tokens/token spans.
- Dropout: 即SimCSE中正例的生成方式.
Debiased Contrastive Learning of Unsupervised Sentence Representations 论文精读的更多相关文章
- 论文解读(CDCL)《Cross-domain Contrastive Learning for Unsupervised Domain Adaptation》
论文信息 论文标题:Cross-domain Contrastive Learning for Unsupervised Domain Adaptation论文作者:Rui Wang, Zuxuan ...
- 论文解读(PCL)《Prototypical Contrastive Learning of Unsupervised Representations》
论文标题:Prototypical Contrastive Learning of Unsupervised Representations 论文方向:图像领域,提出原型对比学习,效果远超MoCo和S ...
- 论文解读(Debiased)《Debiased Contrastive Learning》
论文信息 论文标题:Debiased Contrastive Learning论文作者:Ching-Yao Chuang, Joshua Robinson, Lin Yen-Chen, Antonio ...
- 论文解读(SimCLR)《A Simple Framework for Contrastive Learning of Visual Representations》
1 题目 <A Simple Framework for Contrastive Learning of Visual Representations> 作者: Ting Chen, Si ...
- 论文解读(gCooL)《Graph Communal Contrastive Learning》
论文信息 论文标题:Graph Communal Contrastive Learning论文作者:Bolian Li, Baoyu Jing, Hanghang Tong论文来源:2022, WWW ...
- 论文解读(MLGCL)《Multi-Level Graph Contrastive Learning》
论文信息 论文标题:Structural and Semantic Contrastive Learning for Self-supervised Node Representation Learn ...
- A Simple Framework for Contrastive Learning of Visual Representations
目录 概 主要内容 流程 projection head g constractive loss augmentation other 代码 Chen T., Kornblith S., Norouz ...
- ICLR2021对比学习(Contrastive Learning)NLP领域论文进展梳理
本文首发于微信公众号「对白的算法屋」,来一起学AI叭 大家好,卷王们and懂王们好,我是对白. 本次我挑选了ICLR2021中NLP领域下的六篇文章进行解读,包含了文本生成.自然语言理解.预训练语言模 ...
- 论文解读(S^3-CL)《Structural and Semantic Contrastive Learning for Self-supervised Node Representation Learning》
论文信息 论文标题:Structural and Semantic Contrastive Learning for Self-supervised Node Representation Learn ...
- 论文解读(GCA)《Graph Contrastive Learning with Adaptive Augmentation》
论文信息 论文标题:Graph Contrastive Learning with Adaptive Augmentation论文作者:Yanqiao Zhu.Yichen Xu3.Feng Yu4. ...
随机推荐
- Linux 三剑客常用命令
shell三剑客===================================================grep===================================== ...
- Erueka注册源码分析
在com.netfix.discovery包下有一个DiscoveryClient类中包含注册方法,DiscoveryClient实现了EurekaClient接口,并且是一个单例模式,而Eureka ...
- SQL servr——基础篇之DML增删改查
DML:数据操作语言 用于添加.更新.删除和查询数据库中的语言 添加--insert语句 向数据表中插入新的行(记录)可多行可一行 语法:insert [into] 表名 [(column1,. ...
- Linux查看进程调用接口跟踪命令strace
sudo strace -f -p 9022 -e connect
- github秒变vscode
方法一:github.sth -> github1s.sth 方法二:github保持登录状态,然后是英文输入法,点击'.'就行
- Jmeter六、采样器解析
一.HTTP request sampler 默认端口:80 协议protocol:http,https,file 参数中有特殊字符,勾选编码encode send files with reques ...
- int 和vachar后面的数字代表的含义
在创建数据表的时候,我们经常会给每一个字段设置一个长度,例如:int(5).varchar(10) 等等,但是他们代表的意思是什么呢?是该列允许存储值的最大宽度吗? 场景1:为什么我设置成 int(1 ...
- 【UE4】GameplayTag的妙用(ActorTag)
我不会抛下这个残破的世界 在现代游戏引擎中,有一个"Tag"的概念,无论是在Unreal还是Unity中,他们都有大同小异的tag实现. 此篇随笔以Actor Tag举例,简单讲解 ...
- 安装 TensorFlow 参考过的资料
anaconda 的新环境创建 https://blog.csdn.net/yandajiangjun/article/details/102615912
- Linux CentOS Docker Asp.net Core MVC 模板项目的部署
本文只是记录 .net core 3.1 项目的基本部署方法,灵活应对不同情况与需求 工具:VS 2019 Linux CentOS 7 x64 Xshell Xftp Docker 安 ...