
LDA模型应用实践-希拉里邮件主题分类
#coding=utf8
import numpy as np
import pandas as pd
import re
from gensim import corpora, models, similarities
import gensim
from nltk.corpus import stopwords

df = pd.read_csv("./input/HillaryEmails.csv")
# 原邮件数据中有很多Nan的值,直接扔了。
df = df[['Id', 'ExtractedBodyText']].dropna()

def clean_email_text(text):
    text = text.replace('\n'," ") #新行,我们是不需要的
    text = re.sub(r"-", " ", text) #把 "-" 的两个单词,分开。(比如:july-edu ==> july edu)
    text = re.sub(r"\d+/\d+/\d+", "", text) #日期,对主体模型没什么意义
    text = re.sub(r"[0-2]?[0-9]:[0-6][0-9]", "", text) #时间,没意义
    text = re.sub(r"[\w]+@[\.\w]+", "", text) #邮件地址,没意义
    text = re.sub(r"/[a-zA-Z]*[:\//\]*[A-Za-z0-9\-_]+\.+[A-Za-z0-9\.\/%&=\?\-_]+/i", "", text) #网址,没意义
    pure_text = ''
    # 以防还有其他特殊字符(数字)等等,我们直接把他们loop一遍,过滤掉
    for letter in text:
        # 只留下字母和空格
        if letter.isalpha() or letter==' ':
            pure_text += letter
    # 再把那些去除特殊字符后落单的单词,直接排除。
    # 我们就只剩下有意义的单词了。
    text = ' '.join(word for word in pure_text.split() if len(word)>1)
    return text

docs = df['ExtractedBodyText']
docs = docs.apply(lambda s: clean_email_text(s))
doclist = docs.values
stopwords = set(stopwords.words('english'))

texts = [[word for word in doc.lower().split() if word not in stopwords] for doc in doclist]

dictionary = corpora.Dictionary(texts)
corpus = [dictionary.doc2bow(text) for text in texts]

lda = gensim.models.ldamodel.LdaModel(corpus=corpus, id2word=dictionary, num_topics=20)

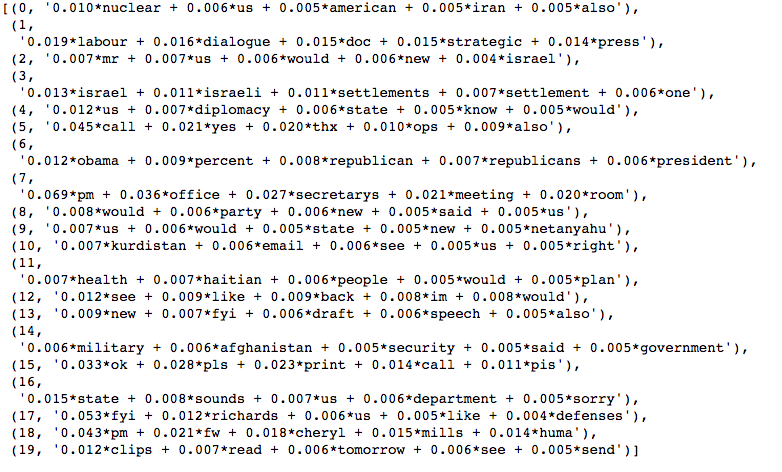
print lda.print_topics(num_topics=20, num_words=5)
LDA模型应用实践-希拉里邮件主题分类的更多相关文章
- 文本主题抽取:用gensim训练LDA模型
得知李航老师的<统计学习方法>出了第二版,我第一时间就买了.看了这本书的目录,非常高兴,好家伙,居然把主题模型都写了,还有pagerank.一路看到了马尔科夫蒙特卡罗方法和LDA主题模型这 ...
- 【自然语言处理】利用LDA对希拉里邮件进行主题分析
首先是读取数据集,并将csv中ExtractedBodyText为空的给去除掉 import pandas as pd import re import os dir_path=os.path.dir ...
- LDA( Latent Dirichlet Allocation)主题模型 学习报告
1 问题描述 LDA由Blei, David M..Ng, Andrew Y..Jordan于2003年提出,是一种主题模型,它可以将文档集中每篇文档的主题以概率分布的形式给出,从而通过分析一 ...
- python应用:主题分类(gensim lda)
安装第三方包:gensim 首先,执行去停词操作(去除与主题无关的词) #-*-coding:utf8-*- import jieba def stopwordslist(filepath): sto ...
- 机器学习Matlab打击垃圾邮件的分类————朴素贝叶斯模型
该系列来自于我<人工智能>课程回顾总结,以及实验的一部分进行了总结学习机 垃圾分类是有监督的学习分类最经典的案例,本文首先回顾了概率论的基本知识.则以及朴素贝叶斯模型的思想.最后给出了垃圾 ...
- LDA模型了解及相关知识
什么是LDA? LDA是基于贝叶斯模型的,涉及到贝叶斯模型离不开“先验分布”,“数据(似然)”和"后验分布"三块.贝叶斯相关知识:先验分布 + 数据(似然)= 后验分布. 贝叶斯模 ...
- 大佬整理出来的干货:LDA模型实现—Python文本挖掘
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取htt ...
- LDA模型笔记
“LDA(Latent Dirichlet Allocation)模型,模型主要解决文档处理领域的问题,比如文章主题分类.文章检测.相似度分析.文本分段和文档检索等问题.LDA主题模型是一个三层贝叶斯 ...
- lda模型的python实现
LDA(Latent Dirichlet Allocation)是一种文档主题生成模型,最近看了点资料,准备使用python实现一下.至于数学模型相关知识,某度一大堆,这里也给出之前参考过的一个挺详细 ...
随机推荐
- MongoDB(课时24 全文索引)
3.6.3 全文索引 在一些信息管理平台上经常需要进行信息模糊查询,最早的时候是利用了某个字段上实现的模糊查询,但这个时候返回的信息并不会很准确,因为只能够查A字段或B字段,而在MongoDB里面实现 ...
- 通过 sqldf 包使用 SQL 查询数据框
在前面的章节中,我们学习了如何编写 SQL 语句,在关系型数据库(如 SQLite 和MySQL )中查询数据.我们可能会想,有没有一种方法,能够直接使用 SQL 进行数据框查询,就像数据框是关系型数 ...
- VSAN Cluster Failed
failed message:AdVanced vSAN configuration in syncChecks if all of the hosts in a vSAN cluster have ...
- SpringBoot入门篇--整合mybatis+generator自动生成代码+druid连接池+PageHelper分页插件
原文链接 我们这一篇博客讲的是如何整合Springboot和Mybatis框架,然后使用generator自动生成mapper,pojo等文件.然后再使用阿里巴巴提供的开源连接池druid,这个连接池 ...
- SpringBoot+Mybatis-Generator自动生成
原文链接 1.版本 Spring Boot 1.5.10 mybatis-generator-core 1.3.5 mybatis-generator-maven-plugin 1.3.5 2.项目目 ...
- Oracle 起诉 Google 事件
最近,Google 和 Oracle 纠缠多年的“Java 侵权案”又有了新的判决结果.Google 在此次对决中败诉,并可能需要支付高达88亿美元的赔偿金.这个案件还引发关于 API(应用程序编程接 ...
- spring boot: 中文显示乱码,在applicationContext里面配置
spring boot: 中文显示乱码,在applicationContext里面配置 applicationContext.properties ########################## ...
- 12月6日 看Active Record validation ; 做jdstore ,注意gem bootstrap 版本只支持bootstrap3。
Active Record validation: new_record?()//用于验证刚新建,但没存入database中的数据 ,返回true或false persisted?() //和new_ ...
- Greedy Subsequences CodeForces - 1132G
我们从右往左滑动区间, 假设dp[i]表示i为左端点时的最大长度, 通过观察可以发现, 每添加一个点, 该点$dp$值=它右侧第一个比它大位置处$dp$值+1, 但是每删除一个点会将所有以它为根的$d ...
- UVA-1252 Twenty Questions (状压DP)
题目大意:有n件物品,每件物品有m个特征,可以对特征进行询问,询问的结果是得知某个物体是否含有该特征,要把所有的物品区分出来(n个物品的特征都互不相同)最小需要多少次询问? 题目分析:定义dp(s,a ...