
Apache Kafka(二)- Kakfa 安装与启动
安装并启动Kafka
1.下载最新版Kafka(当前为kafka_2.12-2.3.0)并解压:
> wget http://mirror.bit.edu.cn/apache/kafka/2.3.0/kafka_2.12-2.3.0.tgz
> tar zxvf kafka_2.12-2.3.0.tgz
2. 检查Java 环境是否正确:
> cd kafka_2.12-2.3.0
> bin/kafka-topics.sh
若是无法成功执行,则检查 Java 环境是否正确配置(此例中使用Java 8)
3. 将kafka执行脚本目录加入环境变量:
> vi ~/.bash_profile
> export PATH="$PATH:/home/hadoop/kafka_2.12-2.3.0/bin"
4. 启动Zookeeper
> zookeeper-server-start.sh config/zookeeper.properties

查看 config/zookeeper.properties 文件,可以看到基本配置:
# the directory where the snapshot is stored.
dataDir=/tmp/zookeeper
# the port at which the clients will connect
clientPort=2181
# disable the per-ip limit on the number of connections since this is a non-production config
maxClientCnxns=0
其中需要将dataDir修改为非/tmp 目录,以将数据持久化,例如:
dataDir=/home/hadoop/kafka_2.12-2.3.0/data/zookeeper
然后重启zookeeper:
> zookeeper-server-start.sh config/zookeeper.properties
之后可以在dataDir目录下查看到zookeeper数据目录:
> pwd
/home/hadoop/kafka_2.12-2.3.0/data/zookeeper/version-2
5. 启动Kafka
首先修改 conf/server.properties 文件,可以看到日志文件地址为:
# A comma separated list of directories under which to store log files
log.dirs=/tmp/kafka-logs
修改此路径为非/tmp目录,以落盘log数据,例如:
log.dirs=/home/hadoop/kafka_2.12-2.3.0/data/kafka-logs
然后启动Kafka:
> kafka-server-start.sh config/server.properties
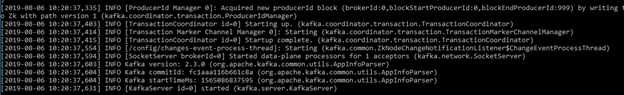
查看 data/kafka-logs,可以看到以下文件:
> ls
cleaner-offset-checkpoint meta.properties replication-offset-checkpoint
log-start-offset-checkpoint recovery-point-offset-checkpoint
Apache Kafka(二)- Kakfa 安装与启动的更多相关文章
- Apache Kafka简介与安装(二)
Kafka在Windows环境上安装与运行 简介 Apache kafka 是一个分布式的基于push-subscribe的消息系统,它具备快速.可扩展.可持久化的特点.它现在是Apache旗下的一个 ...
- Apache Kafka简介与安装(一)
介绍 Kafka是一个分布式的.可分区的.可复制的消息系统.它提供了普通消息系统的功能,但具有自己独特的设计. 首先让我们看几个基本的消息系统术语: Kafka将消息以topic为单位进行归纳. 将向 ...
- Docker学习总结(二)--Docker安装与启动
注:笔者使用的环境为 CentOS 7.6,如果版本不一致可能会出现一些错误. 安装 Docker 1)将 yum 包更新到最新版本 sudo yum update 2) 安装需要的软件包 sudo ...
- 【Apache Kafka】二、Kafka安装及简单示例
(一)Apache Kafka安装 1.安装环境与前提条件 安装环境:Ubuntu16.04 前提条件: ubuntu系统下安装好jdk 1.8以上版本,正确配置环境变量 ubuntu系统下安 ...
- zookeeper+kafka集群安装之二
zookeeper+kafka集群安装之二 此为上一篇文章的续篇, kafka安装需要依赖zookeeper, 本文与上一篇文章都是真正分布式安装配置, 可以直接用于生产环境. zookeeper安装 ...
- Kafka学习笔记1——Kafka的安装和启动
一.准备工作 1. 安装JDK 可以用命令 java -version 查看版本
- Windows OS上安装运行Apache Kafka教程
Windows OS上安装运行Apache Kafka教程 下面是分步指南,教你如何在Windows OS上安装运行Apache Zookeeper和Apache Kafka. 简介 本文讲述了如何在 ...
- 2.kafka单节点broker的安装与启动
下载kafka,http://kafka.apache.org/downloads kafka下面的文件结构如下: 进入bin目录,启动kafka之前要先启动zookeeper ./zookeeper ...
- Kafka 的安装及启动
Linux 服务器 CentOS 为例. Kafka 安装 获取下载地址,下载后解压. $ wget https://mirror.bit.edu.cn/apache/kafka/2.5.0/kafk ...
随机推荐
- windows密码抓取工具-mimikatz
前言 介绍一下windows的密码hash值的组成: Windows系统下的hash密码格式为:用户名称:RID:LM-HASH值:NT-HASH值,例如: Administrator::C8825D ...
- 题解【AcWing1089】烽火传递
题面 单调队列优化 DP 模板题. 我们考虑设 \(dp_{i}\) 表示从 \(1\) 到 \(i\) 能够准确传递情报,且第 \(i\) 个烽火台发出信号的最小费用. 转移方程不难得出:\(dp_ ...
- 3级搭建类301-Oracle 11g RAC 双节点搭建(11.2.0.4)非公
项目文档引子系列是根据项目原型,制作的测试实验文档,目的是为了提升项目过程中的实际动手能力,打造精品文档AskScuti. 项目文档引子系列目前不对外发布,仅作为博客记录.如学员在实际工作过程中需提前 ...
- GYCTF easyphp 【反序列化配合字符逃逸】
基础知识可以参考我之前写的那个 0CTF 2016 piapiapia 那个题只是简单记录了一下,学习了一下php反序列化的思路 https://www.cnblogs.com/tiaopideju ...
- HBase Hive
Hbase数据管理 Hbase就是Hadoop database Hbase是列式数据库 因此Hbase特别适合寻找按照时间排序寻找Top n的场景 Hive数据管理 基于 Hadoop 文件系统的数 ...
- mysql 表中数据不存在则插入,否则更新数据
在很多时候我们会操作数据库表,但是在向表中插入数据时,会遇到表中已经存在该id的数据或者没有该id的数据的情况,没有该id的数据的情况时直接插入就OK,遇到已经存在该id的数据的情况则更新该id的数据 ...
- Codeforce 588A - Duff and Meat (贪心)
Duff is addicted to meat! Malek wants to keep her happy for n days. In order to be happy in i-th day ...
- Wannafly Camp 2020 Day 3E 棋技哥 - 贪心,前缀和
#include <bits/stdc++.h> using namespace std; char c[505][505]; int n,m,t,a[505][505],s[505][5 ...
- Eclipse的Errors in required projec(s)问题
在Eclipse中运行代码时出现Errors exist in required project(s)弹窗提示,但是当前类并无错误,点击Proceed当前类仍然可以运行 错误展示: Errors ex ...
- SpringBoot多数据源:动态数据源
目录 1. 引言 2. 动态数据源流程说明 3. 实现动态数据源 3.1 说明及数据源配置 3.1.1 包结构说明 3.1.2 数据库连接信息配置 3.1.3 数据源配置 3.2 动态数据源设置 3. ...