
避坑之Hadoop安装伪分布式(Hadoop3.2.0/Ubuntu14.04 64位)
一.安装JDK环境(这个可以网上随意搜一篇教程了照着弄,这里不赘述)
安装成功之后
输入
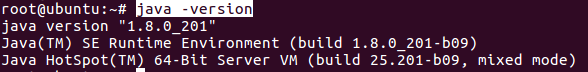
输入:java -version
显示如下说明jdk安装成功(我这里是安装JDK8)
二.安装Hadoop3.2.0
1、官网下载http://mirror.bit.edu.cn/apache/hadoop/common/
2、安装
A.解压
sudo tar xzf hadoop-3.2.0.tar.gz
B.假如我们要把hadoop安装到/usr/local下
C.拷贝到/usr/local/下,文件夹为hadoop
sudo mv hadoop-3.2.0 /usr/local/hadoop
D.赋予用户对该文件夹的读写权限
sudo chmod 774 /usr/local/hadoop
三.配置Hadoop(JDK和Hadoop的路径)
1.配置~/.bashrc
输入:sudo gedit ~/.bashrc
添加如下代码:

之后保存退出
2.执行下面命名,使添加的环境变量生效:(如果报错,请看下面避坑一)
source ~/.bashrc
3.判断Hadoop是否安装成功
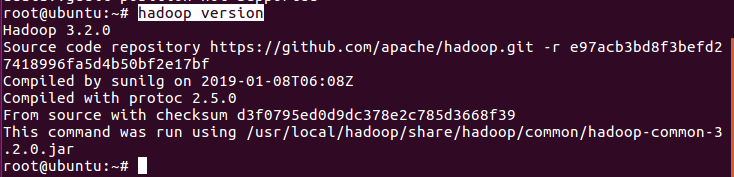
出现版本信息,说明成功
四,,接下来进行配置伪分布式(上面的Hadoop只是单机模式)
4.1修改hadoop配置文件
4.1.1修改配置文件core-site.xml(使用gedit etc/hadoop/core-site.xml).将configuration节点添加子节点,修改为下面内容:
<configuration>

    <!--指定fs的缺省名称-->

    <property>

      <name>fs.default.name</name>

      <value>hdfs://localhost:9000</value>

    </property>

    <!--指定HDFS的(NameNode)的缺省路径地址,localhost:是计算机名,也可以是ip地址-->

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://localhost:9000</value>

    </property>

    <!-- 指定hadoop运行时产生文件的存储目录(以个人为准) -->

    <property>

      <name>hadoop.tmp.dir</name>

      <value>/usr/local/hadoop/tmp</value>

    </property>

</configuration>
ps:如果没有该目录:/usr/local/hadoop/tmp,需要自己新建
4.1.2修改配置文件hdfs-site.xml(使用gedit etc/hadoop/hdfs-site.xml).将configuration节点添加子节点,修改为下面内容:
<configuration>

<!-- 指定HDFS副本的数量 -->

    <property>

        <name>dfs.replication</name>

        <value>1</value>

    </property>

    <property>

      <name>dfs.name.dir</name>

      <value>/usr/local/hadoop/hdfs/name</value>

    </property>

    <property>

      <name>dfs.data.dir</name>

      <value>/usr/local/hadoop/hdfs/data</value>

    </property>

</configuration>
ps:如果没有该目录:/usr/local/hadoop/hdfs/name,需要自己新建
ps:如果没有该目录:/usr/local/hadoop/hdfs/data,需要自己新建
4.1.3 etc/hadoop目录下查看是否有配置文件mapred-site.xml。目录下默认情况下没有该文件,可通过执行如下命令:cp mapred-site.xml.template mapred-site.xml修改一个文件的命名,然后执行编辑文件命令:gedit mapred-site.xml并修改该文件内容:
<configuration>

    <!-- 指定mr运行在yarn上 -->

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

</configuration>
4.1.4在etc/hadoop目录下执行gedit yarn-site.xml修改为:
<configuration>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

</configuration>
4.2同样使用source ~/.bashrc命令使配置文件生效。(如果报错,请看下面避坑一)
五:Hadoop的运行
5.1格式化namenode
第一次运行格式化namennode。执行hdfs namenode -format命令。
5.2启动hadoop hdfs (如果报错,请看避坑二)
执行start-dfs.sh命令。
5.3启动yarn ( 如果报错,请看避坑二)
执行start-yarn.sh命令。
5.4查看运行进程
使用jps命令,查看运行中java进程

六.web管理界面
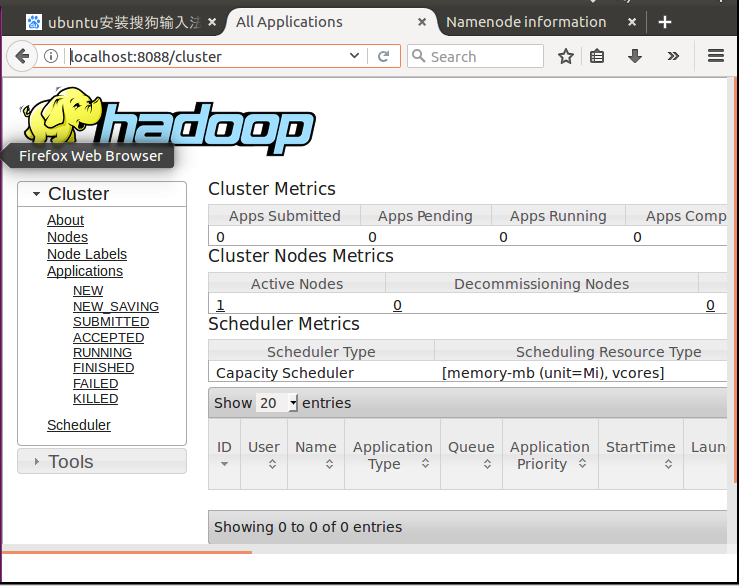
6.1MapReduce管理界面:http://localhost:8088/
6.2HDFS管理界面:http://localhost:50070/
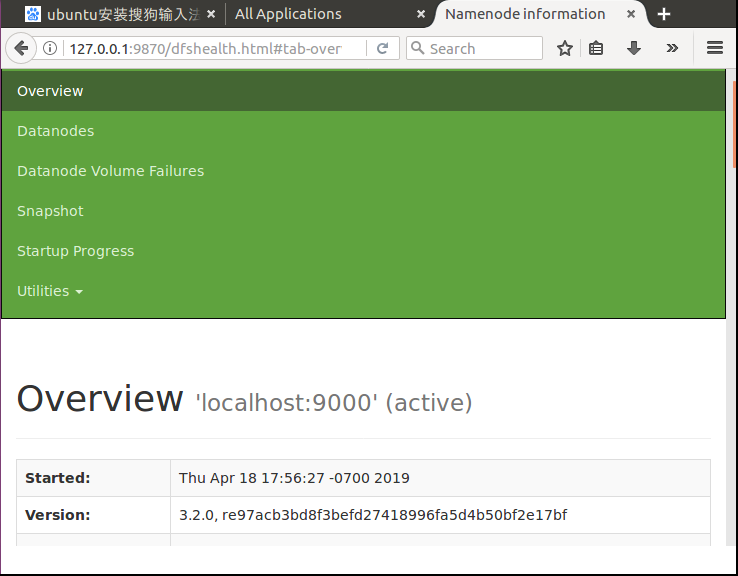
如果显示如下页面,请看避坑三

七.退出
可执行stop-all.sh 命令,一次性关闭所有hadoop进程,也可以通过stop-dfs.sh stop-yarn.sh分别关闭进程
避坑一:bashrc命令报错
两种方法解决此问题:
1.在当前用户下添加环境变量:将环境变量添加到文件:~/.bashrc下,
然后source ~/.bashrc即可。
2.首先进入root用户:sudo su -或者sudo -s,
然后将环境变量添加到/etc/profile或者/root/.bashrc或者/etc/bash.bashrc文件,然后source该文件即可。
避坑二:start-dfs.sh或者start-yarn.sh报错
报错如下

在/hadoop/sbin路径下:
将start-dfs.sh,stop-dfs.sh两个文件顶部添加以下参数
 #!/usr/bin/env bash

 HDFS_DATANODE_USER=root

 HADOOP_SECURE_DN_USER=hdfs

 HDFS_NAMENODE_USER=root

 HDFS_SECONDARYNAMENODE_USER=root
还有,start-yarn.sh,stop-yarn.sh顶部也需添加以下
#!/usr/bin/env bash

YARN_RESOURCEMANAGER_USER=root

HADOOP_SECURE_DN_USER=yarn

YARN_NODEMANAGER_USER=root
修改后重启 ./start-dfs.sh,成功!

修改后重启 ./start-yarn.sh

避坑三:localhost:50070报错
hadoop3.X的webUI已经改到端口 localhost:9870
避坑之Hadoop安装伪分布式(Hadoop3.2.0/Ubuntu14.04 64位)的更多相关文章
- Ubuntu14.04 64位机上安装cuda8.0 cudnn5.0操作步骤 - 网络资源是无限的
查看Ubuntu14.04 64位上显卡信息,执行: lspci | grep -i vga lspci -v -s 01:00.0 nvidia-smi 第一条此命令可以显示一些显卡的相关信息:如果 ...
- Ubuntu14.04(64位)安装ATI_Radeon_R7_M265显卡驱动
电脑型号:Dell inspiron 14-5447 笔记本 显卡配置:集成显卡Intel核心显卡,Cpu是i5-4210U;独立显卡ATI_Radeon_R7_M265 网上关于ATI/Intel双 ...
- ubuntu14.04 64位 安装Tomcat
ubuntu14.04 64位 安装Tomcat 1 下载Tomcat 在htt://www.tomcat.apache.org官网上下载apache-tomcat-7.0.57.tar.gz 2 解 ...
- ubuntu14.04 64位 安装eclipse
ubuntu14.04 64位 安装eclipse 1 在官网上下载eclipse http://www.eclipse.org/downloads/下载eclipse-jee-luna-SR1-li ...
- ubuntu14.04 64位 安装JDK1.7
ubuntu14.04 64位 安装JDK1.7 1 新建文件夹 youhaidong@youhaidong:~$ sudo mkdir /usr/lib/jvm 2 解压文件 youhaidong@ ...
- Ubuntu14.04 64位机上安装OpenCV2.4.13(CUDA8.0)版操作步骤
Ubuntu14.04 64位机上安装CUDA8.0的操作步骤可以参考http://blog.csdn.net/fengbingchun/article/details/53840684,这里是在已经 ...
- Ubuntu14.04 64位机上安装cuda8.0+cudnn5.0操作步骤
查看Ubuntu14.04 64位上显卡信息,执行: lspci | grep -i vga lspci -v -s 01:00.0 nvidia-smi 第一条此命令可以显示一些显卡的相关信息:如果 ...
- ubuntu14.04 64位安装H3C iNode客户端
环境: OS:ubuntu14.04LTS 64位 iNode: iNode2.40-R0162 for linux(iNode只有32位的,而且是很久以前的版本) 安装方法: 第一种: 检查本机是6 ...
- ubuntu14.04 64位 安装H3C iNode客户端
环境: OS: ubuntu14.04LTS 64位 iNode: iNode2.40-R0162 for linux(iNode只有32位的,而且是很久以前的版本) 安装方法: 第一种: 主要参考 ...
随机推荐
- 835. 字符串统计(Trie树模板题)
维护一个字符串集合,支持两种操作: “I x”向集合中插入一个字符串x: “Q x”询问一个字符串在集合中出现了多少次. 共有N个操作,输入的字符串总长度不超过 105105,字符串仅包含小写英文字母 ...
- mysql 对数据的自增ID重新进行排序
创建表格时添加: create table table1(id int auto_increment primary key,...) 创建表格后添加: 删除原有主键: ALTER TABLE `ta ...
- 【网页浏览】关键字搜索PIXIV插图
可以在线搜索Pixiv(P站)的插图 传送链接
- Computer Abstractions
计算机系统结构的概述 (MOOC:计算机系统设计) 组成: 硬件:CPU +MM(主存)+I/O(输入/输出) 软件:系统软件+应用软件 层次结构: 发展简史: 第一代:真空管 ·ENIAC ·冯诺 ...
- Python之路Day05
字典 字典 -- dict Python的数据结构之一 字典是可变数据类型,无序的 定义 dic = {'key':'Value'} 键值对 字典的作用 存储数据,大大量的,将数据和数据起到关联作用 ...
- HDU1069 Monkey and Banana(dp)
链接:http://acm.hdu.edu.cn/showproblem.php?pid=1069 题意:给定n种类型的长方体,每个类型长方体无数个,要求长方体叠放在一起,且上面的长方体接触面积要小于 ...
- 使用LxRunOffline工具备份/还原Linux子系统(WSL)
安装WSL 开启WSL组件 首先需要打开WSL组件,可以使用以下命令: Enable-WindowsOptionalFeature -Online -FeatureName Microsoft-Win ...
- 第四十三篇 入门机器学习——Numpy的基本操作——Fancy Indexing
No.1. 通过索引快速访问向量中的多个元素 No.2. 用索引对应的元素快速生成一个矩阵 No.3. 通过索引从矩阵中快速获取多个元素 No.4. 获取矩阵中感兴趣的行或感兴趣的列,重新组成矩阵 N ...
- django admin 后台总结(转载)
https://www.cnblogs.com/wumingxiaoyao/p/6928297.html
- NOIP2016普及组解题报告
概述 \(NOIP2016\)普及组的前三题都比较简单,第四题也有很多的暴力分,相信参加了的各位\(OIer\)在\(2016\)年都取得了很好的成绩. 那么,我将会分析\(NOIP2016\)普及组 ...