
学了这么久的高并发编程,连Java中的并发原子类都不知道?
摘要:保证线程安全是 Java 并发编程必须要解决的重要问题,本文和大家聊聊Java中的并发原子类,看它如何确保多线程的数据一致性。
本文分享自华为云社区《学了这么久的高并发编程,连Java中的并发原子类都不知道?这也太Low了吧》,作者:冰 河。
今天我们一起来聊聊Java中的并发原子类。在 java.util.concurrent.atomic包下有很多支持并发的原子类,某种程度上,我们可以将其分成:基本数据类型的原子类、对象引用类型的原子类、数组类型的原子类、对象属性类型的原子类和累加器类型的原子类 五大类。
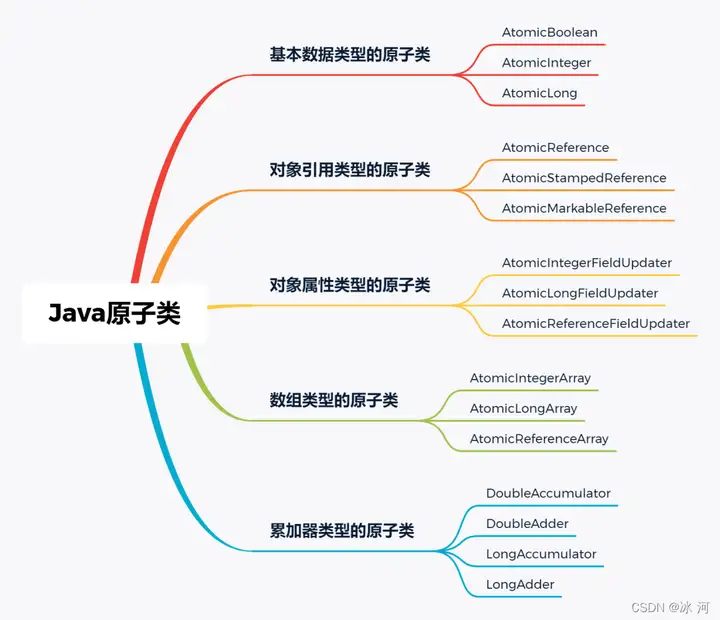
接下来,我们就一起来看看这些并发原子类吧。
基本数据类型的原子类
基本数据类型的原子类包含:AtomicBoolean、AtomicInteger和AtomicLong。
打开这些原子类的源码,我们可以发现,这些原子类在使用上还是非常简单的,主要提供了如下这些比较常用的方法。
- 原子化加1或减1操作
//原子化的i++

getAndIncrement()

//原子化的i--

getAndDecrement()

//原子化的++i

incrementAndGet()

//原子化的--i

decrementAndGet()
- 原子化增加指定的值
//当前值+=delta,返回+=前的值

getAndAdd(delta)

//当前值+=delta,返回+=后的值

addAndGet(delta)
- CAS操作
//CAS操作,返回原子化操作的结果是否成功

compareAndSet(expect, update)
- 接收函数计算结果
//结果数据可通过传入func函数来计算

getAndUpdate(func)

updateAndGet(func)

getAndAccumulate(x,func)

accumulateAndGet(x,func)
对象引用类型的原子类
对象引用类型的原子类包含:AtomicReference、AtomicStampedReference和AtomicMarkableReference。
利用这些对象引用类型的原子类,可以实现对象引用更新的原子化。AtomicReference提供的原子化更新操作与基本数据类型的原子类提供的更新操作差不多,只不过AtomicReference提供的原子化操作常用于更新对象信息。这里不再赘述。
需要特别注意的是:使用对象引用类型的原子类,要重点关注ABA问题。
关于ABA问题,文章的最后部分会说明。
好在AtomicStampedReference和AtomicMarkableReference这两个原子类解决了ABA问题。
AtomicStampedReference类中的compareAndSet的方法签名如下所示。
boolean compareAndSet(V expectedReference, V newReference, int expectedStamp, int newStamp)
可以看到,AtomicStampedReference类解决ABA问题的方案与乐观锁的机制比较相似,实现的CAS方法增加了版本号。只有expectedReference的值与内存中的引用值相等,并且expectedStamp版本号与内存中的版本号相同时,才会将内存中的引用值更新为newReference,同时将内存中的版本号更新为newStamp。
AtomicMarkableReference类中的compareAndSet的方法签名如下所示。
boolean compareAndSet(V expectedReference, V newReference, boolean expectedMark, boolean newMark)
可以看到,AtomicMarkableReference解决ABA问题的方案就更简单了,在compareAndSet方法中,新增了boolean类型的校验值。这些理解起来也比较简单,这里,我也不再赘述了。
对象属性类型的原子类
对象属性类型的原子类包含:AtomicIntegerFieldUpdater、AtomicLongFieldUpdater和AtomicReferenceFieldUpdater。
利用对象属性类型的原子类可以原子化的更新对象的属性。值得一提的是,这三个类的对象都是通过反射的方式生成的,如下是三个类的newUpdater()方法。
//AtomicIntegerFieldUpdater的newUpdater方法

public static <U> AtomicIntegerFieldUpdater<U> newUpdater(Class<U> tclass, String fieldName)

//AtomicLongFieldUpdater的newUpdater方法

public static <U> AtomicLongFieldUpdater<U> newUpdater(Class<U> tclass, String fieldName)

//AtomicReferenceFieldUpdater的newUpdater方法

public static <U,W> AtomicReferenceFieldUpdater<U,W> newUpdater(Class<U> tclass,

                                                                Class<W> vclass,

                                                                String fieldName)
这里,我们不难看出,在AtomicIntegerFieldUpdater、AtomicLongFieldUpdater和AtomicReferenceFieldUpdater三个类的newUpdater()方法中,只有传递的Class信息,并没有传递对象的引用信息。如果要更新对象的属性,则一定要使用对象的引用,那对象的引用是在哪里传递的呢?
其实,对象的引用是在真正调用原子操作的方法时传入的。这里,我们就以compareAndSet()方法为例,如下所示。
//AtomicIntegerFieldUpdater的compareAndSet()方法

compareAndSet(T obj, int expect, int update)

//AtomicLongFieldUpdater的compareAndSet()方法

compareAndSet(T obj, long expect, long update)

//AtomicReferenceFieldUpdater的compareAndSet()方法

compareAndSet(T obj, V expect, V update)
可以看到,原子化的操作方法仅仅是多了一个对象的引用,使用起来也非常简单,这里,我就不再赘述了。
另外,需要注意的是:使用AtomicIntegerFieldUpdater、AtomicLongFieldUpdater和AtomicReferenceFieldUpdater更新对象的属性时,对象属性必须是volatile类型的,只有这样才能保证可见性;如果对象属性不是volatile类型的,newUpdater()方法会抛出IllegalArgumentException这个运行时异常。
数组类型的原子类
数组类型的原子类包含:AtomicIntegerArray、AtomicLongArray和AtomicReferenceArray。
利用数组类型的原子类可以原子化的更新数组里面的每一个元素,使用起来也非常简单,数组类型的原子类提供的原子化方法仅仅是在基本数据类型的原子类和对象引用类型的原子类提供的原子化方法的基础上增加了一个数组的索引参数。
例如,我们以compareAndSet()方法为例,如下所示。
//AtomicIntegerArray的compareAndSet()方法

compareAndSet(int i, int expect, int update)

//AtomicLongArray的compareAndSet()方法

compareAndSet(int i, long expect, long update)

//AtomicReferenceArray的compareAndSet()方法

compareAndSet(int i, E expect, E update)
可以看到,原子化的操作方法仅仅是对多了一个数组的下标,使用起来也非常简单,这里,我就不再赘述了。
累加器类型的原子类
累加器类型的原子类包含:DoubleAccumulator、DoubleAdder、LongAccumulator和LongAdder。
累加器类型的原子类就比较简单了:仅仅支持值的累加操作,不支持compareAndSet()方法。对于值的累加操作,比基本数据类型的原子类速度更快,性能更好。
使用原子类实现count+1
在并发编程领域,一个经典的问题就是count+1问题。也就是在高并发环境下,如何保证count+1的正确性。一种方案就是在临界区加锁来保护共享变量count,但是这种方式太消耗性能了。
如果使用Java提供的原子类来解决高并发环境下count+的问题,则性能会大幅度提升。
简单的示例代码如下所示。
public class IncrementCountTest{

    private  AtomicLong count = new AtomicLong(0);

    public void incrementCountByNumber(int number){

        for(int i = 0; i < number; i++){

            count.getAndIncrement();

        }

    }

}
可以看到,原子类实现count+1问题,既没有使用synchronized锁,也没有使用Lock锁。
从本质上讲,它使用的是无锁或者是乐观锁方案解决的count+问题,说的具体一点就是CAS操作。
CAS原理
CAS操作包括三个操作数:需要读写的内存位置(V)、预期原值(A)、新值(B)。如果内存位置与预期原值的A相匹配,那么将内存位置的值更新为新值B。
如果内存位置与预期原值的值不匹配,那么处理器不会做任何操作。
无论哪种情况,它都会在 CAS 指令之前返回该位置的值。(在 CAS 的一些特殊情况下将仅返回 CAS 是否成功,而不提取当前值。)
简单点理解就是:位置 V 应该包含值 A;如果包含该值,则将 B 放到这个位置;否则,不要更改该位置,只返回位置V现在的值。这其实和乐观锁的冲突检测+数据更新的原理是一样的。
ABA问题
因为CAS需要在操作值的时候检查下值有没有发生变化,如果没有发生变化则更新,但是如果一个值原来是A,变成了B,又变成了A,那么使用CAS进行检查时会发现它的值没有发生变化,但是实际上却变化了。
ABA问题的解决思路就是使用版本号。在变量前面追加上版本号,每次变量更新的时候把版本号加1,那么A-B-A 就会变成1A-2B-3A。
从Java1.5开始JDK的atomic包里提供的AtomicStampedReference类和AtomicMarkableReference类能够解决CAS的ABA问题。
关于AtomicStampedReference类和AtomicMarkableReference类前文有描述,这里不再赘述。
学了这么久的高并发编程,连Java中的并发原子类都不知道?的更多相关文章
- Java并发编程:Java中的锁和线程同步机制
锁的基础知识 锁的类型 锁从宏观上分类,只分为两种:悲观锁与乐观锁. 乐观锁 乐观锁是一种乐观思想,即认为读多写少,遇到并发写的可能性低,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新 ...
- java编程思想-java中的并发(二)
二.共享受限资源 有了并发就可以同时做多件事情了.但是,两个或多个线程彼此互相干涉的问题也就出现了.如果不防范这种冲突,就可能发生两个线程同时试图访问同一个银行账户,或向同一个打印机打印,改变同一个值 ...
- java编程思想-java中的并发(一)
一.基本的线程机制 并发编程使我们可以将程序划分为多个分离的.独立运行的任务.通过使用多线程机制,这些独立任务中的每一个都将由执行线程来驱动. 线程模型为编程带来了便利,它简化了在单一程序中同时jia ...
- 【并发编程】Java中的锁有哪些?
0.死锁 两个或者两个以上的线程在执行过程中,由于竞争资源或者由于彼此通信而造成的一种阻塞现象,若无外力作用,他们都将无法让程序进行下去: 死锁条件: 不可剥夺条件: T1持有的资源无法被T2剥夺 请 ...
- java编程思想-java中的并发(四)
五. 新类库中的构件 Java SE5的java.util.concurrent引入了大量设计用来解决并发问题的新类.学习使用它们将有助于编写出更加简单而强壮的并发程序. 1. CountDownLa ...
- java编程思想-java中的并发(三)
三.终结任务 1. 在阻塞时终结 线程状态 一个线程可以处于以下四种状态之一: 1)新建(new):当线程被创建时,他只会短暂的处于这种状态.此时,他已经分配了必须的系统资源,并执行了初始化.此刻线程 ...
- Java并发编程笔记1-竞争条件&初识原子类&可重入锁
我们知道,在多线程访问一个共享变量的时候会发生安全问题. 首先看下面例子: public class Counter { private int count; public void add(){ t ...
- java并发编程(十四)----(JUC原子类)对象的属性修改类型介绍
今天我们介绍原子类的最后一个类型--对象的属性修改类型: AtomicIntegerFieldUpdater,AtomicLongFieldUpdater,AtomicReferenceFieldUp ...
- java并发编程(十二)----(JUC原子类)数组类型介绍
上一节我们介绍过三个基本类型的原子类,这次我们来看一下数组类型: AtomicIntegerArray, AtomicLongArray, AtomicReferenceArray.其中前两个的使用方 ...
- 【并发编程】Java中的原子操作
什么是原子操作 原子操作是指一个或者多个不可再分割的操作.这些操作的执行顺序不能被打乱,这些步骤也不可以被切割而只执行其中的一部分(不可中断性).举个列子: //就是一个原子操作 int i = 1; ...
随机推荐
- C#计数排序算法
前言 计数排序是一种非比较性的排序算法,适用于排序一定范围内的整数.它的基本思想是通过统计每个元素的出现次数,然后根据元素的大小依次输出排序结果. 实现原理 首先找出待排序数组中的最大值max和最小值 ...
- 虹科分享|被困云端?虹科Redis企业版数据库来解救!
数字化时代已然到来,各行企业奋起直追数字化进程.为应对数据爆炸式增长导致的数据负载,并保证降低成本,增加效益的前提下,提升企业运行程序的灵活性.在云上进行应用程序部署的新趋势,风头正劲! 但这种方式为 ...
- Splay 详细图解 & 轻量级代码实现
学 LCT 发现有点记不得 Splay 怎么写,又实在不知道这篇博客当时写了些什么东西(分段粘代码?),决定推倒重写. 好像高一学弟也在学平衡树,但相信大家都比樱雪喵强,都能一遍学会!/kel 写在前 ...
- Thread类 常用方法
3.6 start 与 run 调用 run public static void main(String[] args) { Thread t1 = new Thread("t1" ...
- [vue]精宏技术部试用期学习笔记 III
精宏技术部试用期学习笔记(vue) 父子通信 什么是通信 / 为什么要通信 通信即在不同组件之间传输数据 当在 复用组件 时,需要传递不同数据达成不同的表现效果 能够根据其他组件的行动,响应式 的做出 ...
- 前后端都用得上的 Nginx 日常使用经验
前言 nginx 是一个高性能的开源反向代理服务器和 web 服务器,一般用来搭建静态资源服务器.负载均衡器.反向代理,本文将分享其在 Windows/docker 中的使用,使用 nssm 部署成服 ...
- Kubernetes 漫游:理解 ConfigMap
安装说明 通过 docker desktop 可以安装适用于单机和开发环境单机版的 K8S,如果 docker desktop 无法启动 Kubernates 通过以下方式解决: 一:添加国内镜像源 ...
- Windows Server 2022 安装IIS 报错 访问临时文件夹 C:\WINDOWS\TEMP\3C 读取/写入权限 错误: 0x80070005
在windows中使用命令行方式安装IIS(Web服务器) Windows Server 2022 安装IIS 报错 访问临时文件夹 C:\WINDOWS\TEMP\3C 读取/写入权限 错误: 0x ...
- CPF C#跨平台UI框架开源了
介绍 C#跨平台UI框架 提供NETStandard2.0和net4的库,通过Netcore可以跨平台,支持Windows.Mac.Linux,Net4的可以支持XP. 各个平台运行效果一致,不依赖系 ...
- AtCoder_abc331
AtCoder_abc331 (这次题真的真的真的好难) 比赛链接 A - Tomorrow 题目链接 题目大意 有一个\(M\)个月,\(D\)天的日历,请输出\(y年m月z日\)的下一天. 解题思 ...