
时序数据库 Apache-IoTDB 源码解析之文件索引块(五)
上一章聊到 TsFile 的文件组成,以及数据块的详细介绍。详情请见:
时序数据库 Apache-IoTDB 源码解析之文件数据块(四)
打一波广告,欢迎大家访问IoTDB 仓库,求一波 Star。
这一章主要想聊聊:
- TsFile索引块的组成
- 索引块的查询过程
- 索引块目前在做的改进项
索引块
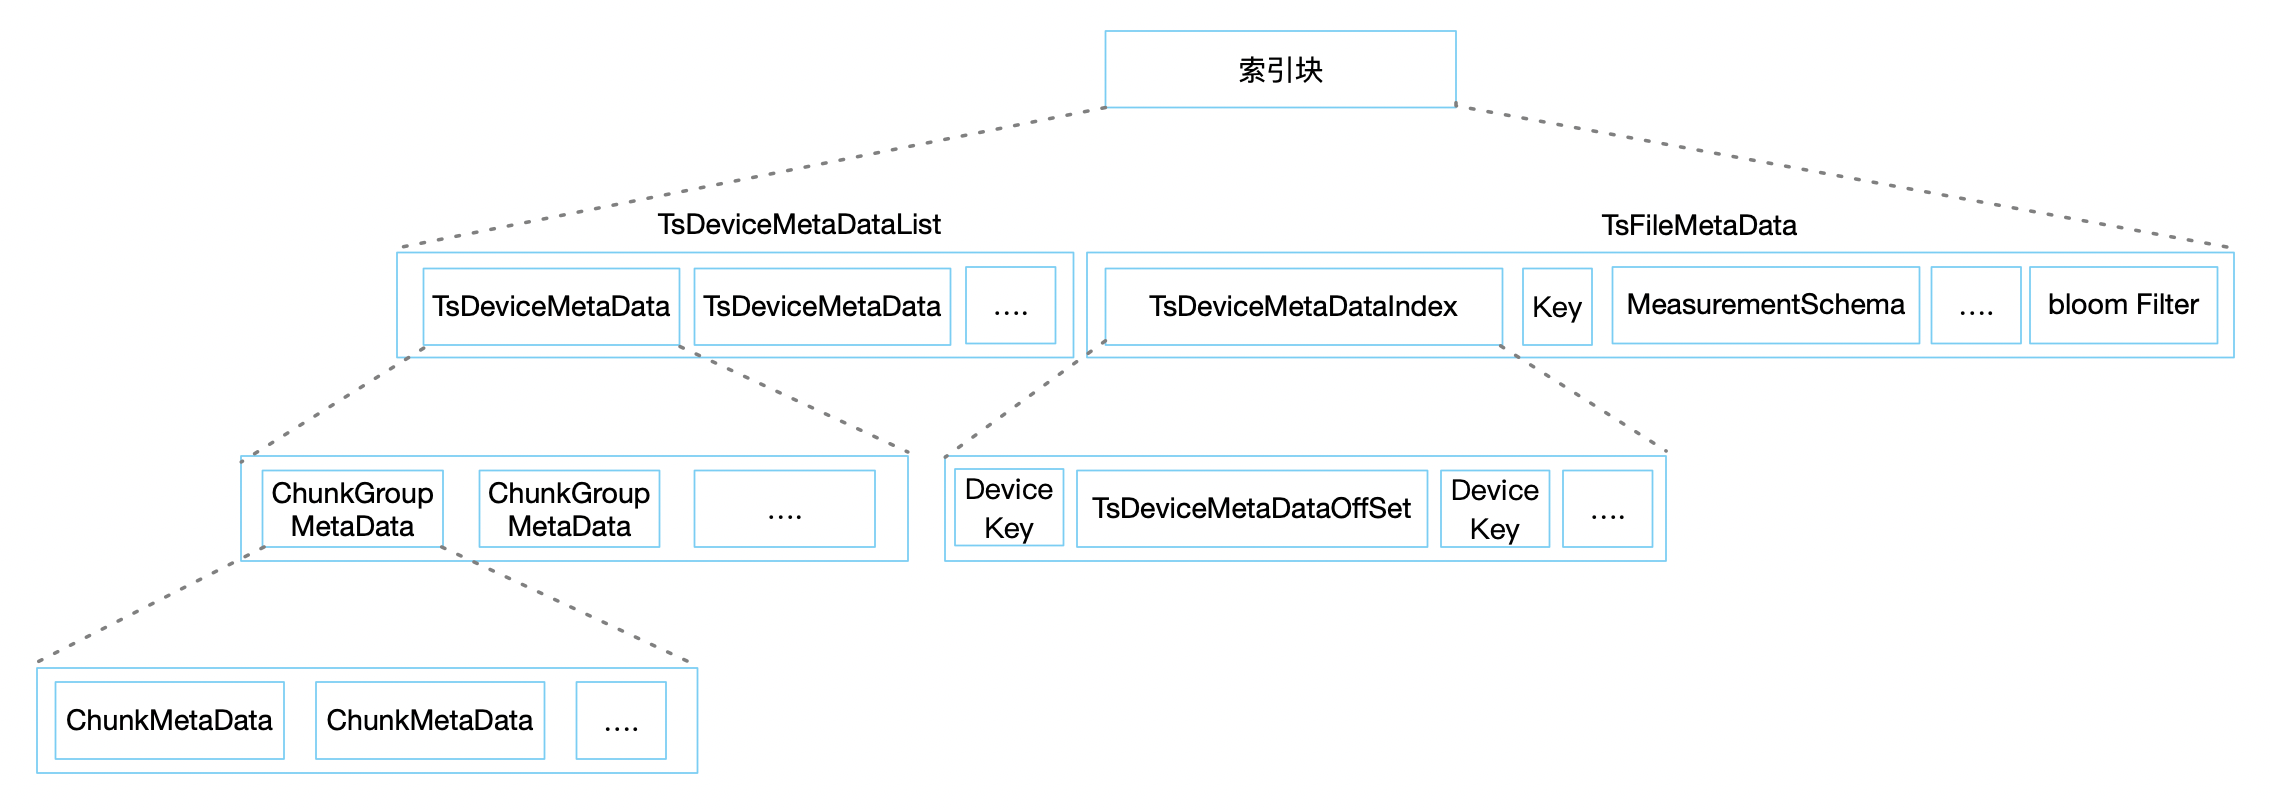
索引块由两大部分组成,其写入的方式是从左到右写入,也就是从文件头向文件尾写入。但读出的方式是先读出TsFileMetaData 再读出 TsDeviceMetaDataList 中的具体一部分。我们按照读取数据的顺序介绍:
TsFileMetaData
TsFileMetaData属于文件的 1 级索引,用来索引 Device 是否存在、在哪里等信息,其中主要保存了:
- DeviceMetaDataIndexMap:Map结构,Key 是设备名,Value 是 TsDeviceMetaDataIndex ,保存了包含哪些 Device(逻辑概念上的一个集合一段时间内的数据,例如前几章我们讲到的:张三、李四、王五)以及他们的开始时间及结束时间、在左侧 TsDeviceMetaDataList 文件块中的偏移量等。
- MeasurementSchemaMap:Map结构,Key 是测点的一个全路径,Value 是 measurementSchema ,保存了包含的测点数据(逻辑概念上的某一类数据的集合,如体温数据)的原信息,如:压缩方式,数据类型,编码方式等。
- 最后是一个布隆过滤器,快速检测某一个
时间序列是不是存在于文件内(这里等聊到 server 模块写文件的策略时候再聊)。我们知道这个过滤器的特点就是:没有的一定没有,但有的不一定有。为了保证准确性和过滤器序列化后的大小均衡,这里提供了一个 1% - 10% 错误率的可配置,当为 1% 错误率时,保存 1 万个测点信息,大概是 11.7 K。
我们再回想 SQL :SELECT 体温 FROM 王五 WHERE time = 1 。读文件的过程就应该是:
- 先用
布隆过滤器判断文件内是否有王五的体温列,如果没有,查找下一个文件。 - 从 DeviceMetaDataIndexMap 中找到
王五的 TsDeviceMetaDataIndex ,从而得到了王五的 TsDeviceMetadata 的 offset,接下来就寻道至这个 offset 把王五的 TsDeviceMetadata 读出来。 - MeasurementSchemaMap 不用关注,主要是给 Spark 使用的,ChunkHeader 中也保存了这些信息。
TsDeviceMetaDataList
TsDeviceMetaDataList 属于文件的 2 级索引,用来索引具体的测点数据是不是存在、在哪里等信息。其中主要保存了:
- ChunkGroupMetaData:ChunkGroup 的索引信息,主要包含了每个 ChunkGroup 数据块的起止位置以及包含的所有的测点元信息(ChunkMetaData)。
- ChunkMetaData :Chunk 的索引信息,主要包含了每个设备的测点在文件中的起止位置、开始结束时间、数据类型和预聚合信息。
上面的例子中,从 TsFileMetadata 已经拿到了王五的 TsDeviceMetadataIndex,这里就可以直接读出王五的 TsDeviceMetadata,并且遍历里边的 ChunkGroupMetadata 中的 ChunkMetadata,找到体温对应的所有的 ChunkMetadata。通过预聚合信息对时间过滤,判断能否使用当前的 Chunk 或者能否直接使用预聚合信息直接返回数据(等介绍到 server 的查询引擎时候细聊)。
如果不能直接返回,因为 ChunkMetaData 包含了这个 Chunk 对应的文件的偏移量,只需要使用 seek(offSet) 就会跳转到数据块,使用上一章介绍的读取方法进行遍历就完成了整个读取。
预聚合信息(Statistics)
文中多次提到了预聚合在这里详细介绍一下它的数据结构。
// 所属文件块的开始时间

private long startTime;

// 所属文件块的结束时间

private long endTime;

// 所属文件块的数据类型

private TSDataType tsDataType;

// 所属文件块的最小值

private int minValue;

// 所属文件块的最大值

private int maxValue;

// 所属文件块的第一个值

private int firstValue;

// 所属文件块的最后一个值

private int lastValue;

// 所属文件块的所有值的和

private double sumValue;
这个结构主要保存在 ChunkMetaData 和 PageHeader 中,这样做的好处就是,你不必从硬盘中读取具体的Page 或者 Chunk 的文件内容就可以获得最终的结果,例如:SELECT SUM(体温) FROM 王五 ,当定位到 ChunkMetaData 时,判断能否直接使用这个 Statistics 信息(具体怎么判断,之后会在介绍 server 时具体介绍),如果能使用,那么直接返回 sumValue。这样返回的速度,无论存了多少数据,它的聚合结果响应时间简直就是 1 毫秒以内。
样例数据
我们继续使用上一章聊到的示例数据来展示。
| 时间戳 | 人名 | 体温 | 心率 |
|---|---|---|---|
| 1580950800 | 王五 | 36.7 | 100 |
| 1580950911 | 王五 | 36.6 | 90 |
完整的文件信息如下:
            POSITION|	CONTENT

            -------- 	-------

                   0|	[magic head] TsFile

                   6|	[version number] 000002

                    // 数据块开始

|||||||||||||||||||||	[Chunk Group] of wangwu begins at pos 12, ends at pos 253, version:0, num of Chunks:2

                  12|	[Chunk] of xinlv, numOfPoints:1, time range:[1580950800,1580950800], tsDataType:INT32,

                     	[minValue:100,maxValue:100,firstValue:100,lastValue:100,sumValue:100.0]

                    |		[marker] 1

                    |		[ChunkHeader]

                    |		1 pages

                 121|	[Chunk] of tiwen, numOfPoints:1, time range:[1580950800,1580950800], tsDataType:FLOAT,

                     	[minValue:36.7,maxValue:36.7,firstValue:36.7,lastValue:36.7,sumValue:36.70000076293945]

                    |		[marker] 1

                    |		[ChunkHeader]

                    |		1 pages

                 230|	[Chunk Group Footer]

                    |		[marker] 0

                    |		[deviceID] wangwu

                    |		[dataSize] 218

                    |		[num of chunks] 2

|||||||||||||||||||||	[Chunk Group] of wangwu ends

                    // 索引块开始

                 253|	[marker] 2

                 254|	[TsDeviceMetadata] of wangwu, startTime:1580950800, endTime:1580950800

                    |		[startTime] 1580950800

                    |		[endTime] 1580950800

                    |		[ChunkGroupMetaData] of wangwu, startOffset12, endOffset253, version:0, numberOfChunks:2

                    |			[ChunkMetaData] of xinlv, startTime:1580950800, endTime:1580950800, offsetOfChunkHeader:12, dataType:INT32, statistics:[minValue:100,maxValue:100,firstValue:100,lastValue:100,sumValue:100.0]

                    |			[ChunkMetaData] of tiwen, startTime:1580950800, endTime:1580950800, offsetOfChunkHeader:121, dataType:FLOAT, statistics:[minValue:36.7,maxValue:36.7,firstValue:36.7,lastValue:36.7,sumValue:36.70000076293945]

                 446|	[TsFileMetaData]

                    |		[num of devices] 1

                    |			[TsDeviceMetadataIndex] of wangwu, startTime:1580950800, endTime:1580950800, offSet:254, len:192

                    |		[num of measurements] 2

                    |		2 key&measurementSchema

                    |		[createBy isNotNull] false

                    |		[totalChunkNum] 2

                    |		[invalidChunkNum] 0

                    //布隆过滤器

                    |		[bloom filter bit vector byte array length] 30

                    |		[bloom filter bit vector byte array]

                    |		[bloom filter number of bits] 256

                    |		[bloom filter number of hash functions] 5

                 599|	[TsFileMetaDataSize] 153

                 603|	[magic tail] TsFile

                 609|	END of TsFile
当执行: SELECT 体温 FROM 王五 时:
- 从
599开始读,1 级索引长度为 153. 599 - 153 = 446就是 1 级索引读开始位置,并读出 TsDeviceMetadataIndex of 王五,其中记录了,王五设备的 2 级索引的 offset 为 254.- 跳到
254开始读 2 级索引,找到 ChunkMetaData of 体温, 其中记录了体温数据的 Chunk 的offset 为121 - 跳到
121,这里进入了数据块,从121读取到230,读出的数据就全部是体温数据。
改进项
1. 只读投影列
前面第 3 步中,读取 2 级索引时候,会将这个设备下的所有测点数据全部读出来,这依然不太符合只读投影列的设计,所以在新的 TsFile 中,修改了 1级索引和 2 级索引的部分结构,使得读出的数据更少,更高效。有兴趣的同学可以关注 PR: Refactor TsFile #736
2. 文件级 Statistics
在物联网场景中经常会涉及到查询某个设备的最后状态,比如:车联网中,查询车辆的末次位置( SELECT LAST(lat,lon) FROM VechicleID ),或者当前的点火、熄火状态等 SELECT LAST(accStatus) FROM VechicleID 。
或者当某些分页查询等情况时候,经常会使用到 COUNT(*) 等操作,这些都非常符合 Statistics 结构,这些场景涉及到的索引设计也都会体现到新的 TsFile 索引改动中。
到此已经介绍完了文件的整体结构,了解了大体的写入和读取过程,但是 TsFile 的 API 是如何设计的,怎样在代码里做一些特殊的功课,来绕过 Java 装箱、GC 等问题呢?欢迎持续关注。。。。
时序数据库 Apache-IoTDB 源码解析之文件索引块(五)的更多相关文章
- 时序数据库 Apache-IoTDB 源码解析之元数据索引块(六)
上一章聊到 TsFile 索引块的详细介绍,以及一个查询所经过的步骤.详情请见: 时序数据库 Apache-IoTDB 源码解析之文件索引块(五) 打一波广告,欢迎大家访问 IoTDB 仓库,求一波 ...
- 时序数据库 Apache-IoTDB 源码解析之文件数据块(四)
上一章聊到行式存储.列式存储的基本概念,并介绍了 TsFile 是如何存储数据以及基本概念.详情请见: 时序数据库 Apache-IoTDB 源码解析之文件格式简介(三) 打一波广告,欢迎大家访问Io ...
- Ocelot简易教程(七)之配置文件数据库存储插件源码解析
作者:依乐祝 原文地址:https://www.cnblogs.com/yilezhu/p/9852711.html 上篇文章给大家分享了如何集成我写的一个Ocelot扩展插件把Ocelot的配置存储 ...
- React源码解析之React.Children.map()(五)
一,React.Children是什么? 是为了处理this.props.children(this.props.children表示所有组件的子节点)这个属性提供的工具,是顶层的api之一 二,Re ...
- tp3.2源码解析——入口文件
如果有人读这篇文章并跟着做的话,希望你能使用支持函数跳转的编辑器,还要善用var_dump和exit,对着源码去调试着看.跟着入口文件读,执行到哪里你看到哪里,对于那些不能一眼看出来的配置,则要记录下 ...
- tensorflow源码解析系列文章索引
文章索引 framework解析 resource allocator tensor op node kernel graph device function shape_inference 拾遗 c ...
- Mybatis源码解析(四) —— SqlSession是如何实现数据库操作的?
Mybatis源码解析(四) -- SqlSession是如何实现数据库操作的? 如果拿一次数据库请求操作做比喻,那么前面3篇文章就是在做请求准备,真正执行操作的是本篇文章要讲述的内容.正如标题一 ...
- Parquet 源码解析
date: 2020-07-20 16:15:00 updated: 2020-07-27 13:40:00 Parquet 源码解析 Parquet文件是以二进制方式存储的,所以是不可以直接读取的, ...
- laravel 读写分离源码解析
前言:上一篇我们说了<laravel 配置MySQL读写分离>,这次我们说下,laravel的底层代码是怎样实现读写分离的. 一.实现原理 说明: 1.根据 database.php ...
随机推荐
- Spring事务失效的 8 大原因,这次可以吊打面试官了!
今天再来一篇<吊打面试官>系列,这次真的要吊打了,哈哈!(看往期吊打系列请在后台回复:吊打,我会陆续更新--) 前几天栈长不是发了一篇文章,里面有一个关于事务失效的问题: 用 Spring ...
- 4.eclipse中导入别人用的源代码问题
最近在导入别人用的源代码问题时,出现两个问题: 问题一:提示无法解析导入,如下图: 解决方法:删除项目下的module-info.java文件即可,或者在创建项目时将创建module-info.jav ...
- 面试时面试官想要听到什么答案(关于一些vue的问题)
前言 自己也只是一个前端的小白,因为公司大佬都比较忙,面试这种事就落到了我这小白身上,第一次叫我去的时候我是百般拒绝的,因为自己还是有自知之明的,但是别人实在抽不开身,没办法只能去了,他们开玩笑说就按 ...
- beetlex网关之聚合和url请求过虑
在这里主要介绍beetlex应用网关的两个插件,分别是聚合和url请求过虑.通过聚合插件可以把整合多个请求的数据来应答请求端,而Url请求过虑同可以拒绝一些有非常关键字的请求. 请求聚合 在网关服务中 ...
- 【JavaWeb学习】过滤器Filter
一.简介 Filter也称之为过滤器,它是Servlet技术中最激动人心的技术,WEB开发人员通过Filter技术,对web服务器管理的所有web资源:例如Jsp, Servlet, 静态图片文件或静 ...
- .Net Core Web Api实践(三).net core+Redis+docker实现Session共享
前言:上篇文章介绍了.net core+Redis+IIS+nginx实现Session共享,本来打算直接说明后续填坑过程,但毕竟好多坑是用docker部署后出现的,原计划简单提一下.net core ...
- linux下大文件查询具体段内容
有时候我们的文件比较大,比如几十G,甚至上百G.这么大的文件怎么查询呢? 有很多种方法都可以实现,这儿选择用 cat 这个命令实现. 先来看看 cat 的介绍 cat 有个对应的命令 tac,cat反 ...
- 速石科技携HPC混合云平台亮相AWS技术峰会2019上海站
2019年6月20日,全球云技术盛会——AWS技术峰会2019(上海站)在上海世博中心举行.作为AWS的技术合作伙伴,速石科技携旗下基于混合云的一站式高性能计算(HPC)平台首次公开亮相. 速石科技向 ...
- 随机算法 - Miller_Rabin pollard_rho
#include<stdio.h> #include<string.h> #include<stdlib.h> #include<time.h> #in ...
- 关于爬虫的日常复习(2)—— urllib库