
ZooKeeper系列(二)—— Zookeeper 单机环境和集群环境搭建
一、单机环境搭建
1.1 下载
下载对应版本 Zookeeper,这里我下载的版本 3.4.14。官方下载地址:https://archive.apache.org/dist/zookeeper/
# wget https://archive.apache.org/dist/zookeeper/zookeeper-3.4.14/zookeeper-3.4.14.tar.gz1.2 解压
# tar -zxvf zookeeper-3.4.14.tar.gz1.3 配置环境变量
# vim /etc/profile添加环境变量:
export ZOOKEEPER_HOME=/usr/app/zookeeper-3.4.14
export PATH=$ZOOKEEPER_HOME/bin:$PATH
使得配置的环境变量生效:
# source /etc/profile1.4 修改配置
进入安装目录的 conf/ 目录下,拷贝配置样本并进行修改:
# cp zoo_sample.cfg zoo.cfg指定数据存储目录和日志文件目录(目录不用预先创建,程序会自动创建),修改后完整配置如下:
# The number of milliseconds of each tick
tickTime=2000
# The number of ticks that the initial
# synchronization phase can take
initLimit=10
# The number of ticks that can pass between
# sending a request and getting an acknowledgement
syncLimit=5
# the directory where the snapshot is stored.
# do not use /tmp for storage, /tmp here is just
# example sakes.
dataDir=/usr/local/zookeeper/data
dataLogDir=/usr/local/zookeeper/log
# the port at which the clients will connect
clientPort=2181
# the maximum number of client connections.
# increase this if you need to handle more clients
#maxClientCnxns=60
#
# Be sure to read the maintenance section of the
# administrator guide before turning on autopurge.
#
# http://zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance
#
# The number of snapshots to retain in dataDir
#autopurge.snapRetainCount=3
# Purge task interval in hours
# Set to "0" to disable auto purge feature
#autopurge.purgeInterval=1
配置参数说明:
- tickTime:用于计算的基础时间单元。比如 session 超时:N*tickTime;
- initLimit:用于集群,允许从节点连接并同步到 master 节点的初始化连接时间,以 tickTime 的倍数来表示;
- syncLimit:用于集群, master 主节点与从节点之间发送消息,请求和应答时间长度(心跳机制);
- dataDir:数据存储位置;
- dataLogDir:日志目录;
- clientPort:用于客户端连接的端口,默认 2181
1.5 启动
由于已经配置过环境变量,直接使用下面命令启动即可:
zkServer.sh start1.6 验证
使用 JPS 验证进程是否已经启动,出现 QuorumPeerMain 则代表启动成功。
[root@hadoop001 bin]# jps
3814 QuorumPeerMain
二、集群环境搭建
为保证集群高可用,Zookeeper 集群的节点数最好是奇数,最少有三个节点,所以这里演示搭建一个三个节点的集群。这里我使用三台主机进行搭建,主机名分别为 hadoop001,hadoop002,hadoop003。
2.1 修改配置
解压一份 zookeeper 安装包,修改其配置文件 zoo.cfg,内容如下。之后使用 scp 命令将安装包分发到三台服务器上:
tickTime=2000
initLimit=10
syncLimit=5
dataDir=/usr/local/zookeeper-cluster/data/
dataLogDir=/usr/local/zookeeper-cluster/log/
clientPort=2181

# server.1 这个1是服务器的标识,可以是任意有效数字,标识这是第几个服务器节点,这个标识要写到dataDir目录下面myid文件里
# 指名集群间通讯端口和选举端口
server.1=hadoop001:2287:3387
server.2=hadoop002:2287:3387
server.3=hadoop003:2287:3387
2.2 标识节点
分别在三台主机的 dataDir 目录下新建 myid 文件,并写入对应的节点标识。Zookeeper 集群通过 myid 文件识别集群节点,并通过上文配置的节点通信端口和选举端口来进行节点通信,选举出 Leader 节点。
创建存储目录:
# 三台主机均执行该命令
mkdir -vp  /usr/local/zookeeper-cluster/data/
创建并写入节点标识到 myid 文件:
# hadoop001主机
echo "1" > /usr/local/zookeeper-cluster/data/myid
# hadoop002主机
echo "2" > /usr/local/zookeeper-cluster/data/myid
# hadoop003主机
echo "3" > /usr/local/zookeeper-cluster/data/myid
2.3 启动集群
分别在三台主机上,执行如下命令启动服务:
/usr/app/zookeeper-cluster/zookeeper/bin/zkServer.sh start2.4 集群验证
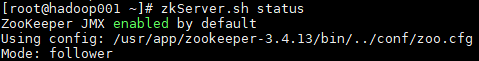
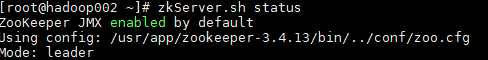
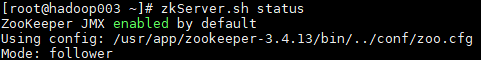
启动后使用 zkServer.sh status 查看集群各个节点状态。如图所示:三个节点进程均启动成功,并且 hadoop002 为 leader 节点,hadoop001 和 hadoop003 为 follower 节点。
更多大数据系列文章可以参见 GitHub 开源项目: 大数据入门指南
ZooKeeper系列(二)—— Zookeeper 单机环境和集群环境搭建的更多相关文章
- ZooKeeper 系列(二)—— Zookeeper单机环境和集群环境搭建
一.单机环境搭建 1.1 下载 1.2 解压 1.3 配置环境变量 1.4 修改配置 1.5 启动 1. ...
- ZooKeeper学习之路(二)—— Zookeeper单机环境和集群环境搭建
一.单机环境搭建 1.1 下载 下载对应版本Zookeeper,这里我下载的版本3.4.14.官方下载地址:https://archive.apache.org/dist/zookeeper/ # w ...
- ZooKeeper —— 单机环境和集群环境搭建
一.单机环境搭建 1.1 下载 下载对应版本Zookeeper,这里我下载的版本3.4.14.官方下载地址:https://archive.apache.org/dist/zookeeper/ # w ...
- Ubuntu 下 Neo4j单机安装和集群环境安装
1. Neo4j简介 Neo4j是一个用Java实现的.高性能的.NoSQL图形数据库.Neo4j 使用图(graph)相关的概念来描述数据模型,通过图中的节点和节点的关系来建模.Neo4j完全兼容A ...
- kafka系列二:多节点分布式集群搭建
上一篇分享了单节点伪分布式集群搭建方法,本篇来分享一下多节点分布式集群搭建方法.多节点分布式集群结构如下图所示: 为了方便查阅,本篇将和上一篇一样从零开始一步一步进行集群搭建. 一.安装Jdk 具体安 ...
- RocketMQ的安装配置:配置jdk环境,配置RocketMQ环境,配置集群环境,配置rocketmq-console
RocketMQ的安装配置 演示虚拟机环境:Centos64-1 (D:\linuxMore\centos6_64) root / itcast : 固定IP 192.168.52.128 一,配置J ...
- ES系列(二):基于多播的集群发现实现原理解析
ES作用超强悍的搜索引擎,除了需要具有齐全的功能支持,超高的性能,还必须要有任意扩展的能力.一定程度上,它是一个大数据产品.而要做扩展性,集群自然少不了.然而单独的集群又是不够的,能够做的事情太少,所 ...
- hadoop2.7.1单机和伪集群的搭建-0
内容中包含 base64string 图片造成字符过多,拒绝显示
- zookeeper集群环境安装配置
众所周知,Zookeeper有三种不同的运行环境,包括:单机环境.集群环境和集群伪分布式环境 在此介绍的是集群环境的安装配置 一.下载: http://apache.fayea.com/zookeep ...
随机推荐
- 雅阁微信群、雅阁车友群、十代雅阁交流微信QQ群
最近一直在关注第十代雅阁,不论是普通汽油版本还是油电混动版本都很不错,在网上看到很多评测文章和视频 后续都会整理发布到微信群中. 由于论坛发帖,博客发文都不是很方便,为了及时沟通,先创建了微信群,方便 ...
- vmware的卸载
vmware出了点问题,在控制面板里或者是360都没法删除干净.在网上搜了点资料,找到一些删除的方法,参考链接如下: http://zhidao.baidu.com/question/30902992 ...
- 最全caffe安装踩坑记录(Anaconda,nvidia-docker,Linux编译)
Anaconda,nvidia-docker,Linux三种方式安装caffe 1.Anaconda安装caffe 1.首先安装anaconda 2.创建虚拟环境(python2.7) conda c ...
- Java将文本文件压缩为tar.gz
压缩 思路 准备输出流 FileOutputStream BufferedOutputStream TarOutputStream GZIPOutputStream 准备输入流 FileInputSt ...
- Hyperledger Fabric 之 Channel ,创建channel链接几项注意点
好长时间没有更新博客,网上也有很多fabric的部署资料,而且也都很不错,也比较全面.我就再想重复的工作暂时就不用做了,后面抽时间在做细化和分类:就将学习和工作中遇到和解决的问题经验,做一些分享. 而 ...
- .Net微信网页开发之使用微信JS-SDK自定义微信分享内容
第一步.微信JS-SDK的使用步骤,配置信息的生成获取讲解: 关于JS-SDK的使用步骤和timestamp(时间戳),nonceStr(随机串),signature(签名),access_token ...
- 《VR入门系列教程》之4---运行平台
运行平台 大多数的VR应用都可以在目前多数的PC和手机上运行,基本上一个不太旧的PC或者配置好点的笔记本电脑都可以正常运行Oculus Rift,如果手机的CPU和显卡不错的话也可以有很好的V ...
- 探究netty的观察者设计模式
javadoc笔记点 观察者的核心思想就是,在适当的时机回调观察者的指定动作函数 我们知道,在使用netty创建channel时,一般都是把这个channel设置成非阻塞的模式,这意味着什么呢? 意味 ...
- Html5web全栈前端开发_angular框架
昵称领取全套angular视频教程 一.Typescript typescript简称ts,是js语法的超集,很多js新的语法就借鉴了ts语法.ts是由微软团队维护的 1.1 TS简介 1.1.1 G ...
- javaweb入门---web服务器与HTTP协议基础
上文web基础简介了web到底是什么,以及身为Java开发人员需要掌握的地方.本文将解答web服务器是什么,怎么使用?还有关于http协议的基础知识. web服务器 web服务器的大概念很广泛,但是通 ...