
分布式机器学习(Parameter Server)
分布式机器学习中,参数服务器(Parameter Server)用于管理和共享模型参数,其基本思想是将模型参数存储在一个或多个中央服务器上,并通过网络将这些参数共享给参与训练的各个计算节点。每个计算节点可以从参数服务器中获取当前模型参数,并将计算结果返回给参数服务器进行更新。
为了保持模型一致性,通常采用下列两种方法:
- 将模型参数保存在一个集中的节点上,当一个计算节点要进行模型训练时,可从集中节点获取参数,进行模型训练,然后将更新后的模型推送回集中节点。由于所有计算节点都从同一个集中节点获取参数,因此可以保证模型一致性。
- 每个计算节点都保存模型参数的副本,因此要定期强制同步模型副本,每个计算节点使用自己的训练数据分区来训练本地模型副本。在每个训练迭代后,由于使用不同的输入数据进行训练,存储在不同计算节点上的模型副本可能会有所不同。因此,每一次训练迭代后插入一个全局同步的步骤,这将对不同计算节点上的参数进行平均,以便以完全分布式的方式保证模型的一致性,即All-Reduce范式
PS架构
在该架构中,包含两个角色:parameter server和worker
parameter server将被视为master节点在Master/Worker架构,而worker将充当计算节点负责模型训练
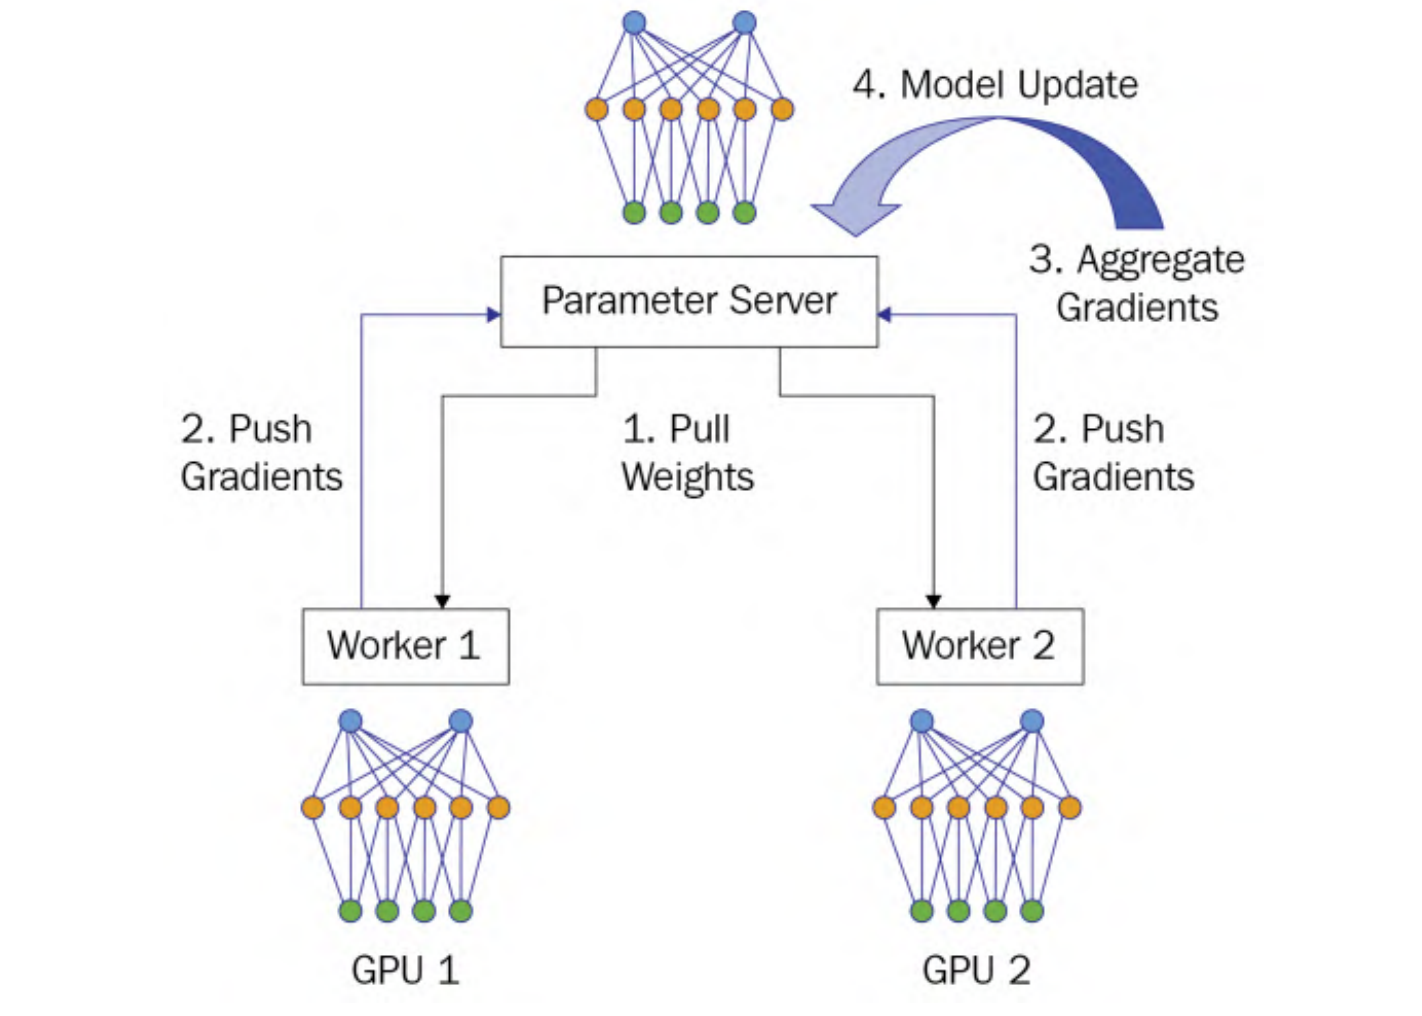
整个系统的工作流程分为4个阶段:
- Pull Weights: 所有worker从参数服务器获取权重参数
- Push Gradients: 每一个worker使用本地的训练数据训练本地模型,生成本地梯度,之后将梯度上传参数服务器
- Aggregate Gradients:收集到所有计算节点发送的梯度后,对梯度进行求和
- Model Update:计算出累加梯度,参数服务器使用这个累加梯度来更新位于集中服务器上的模型参数
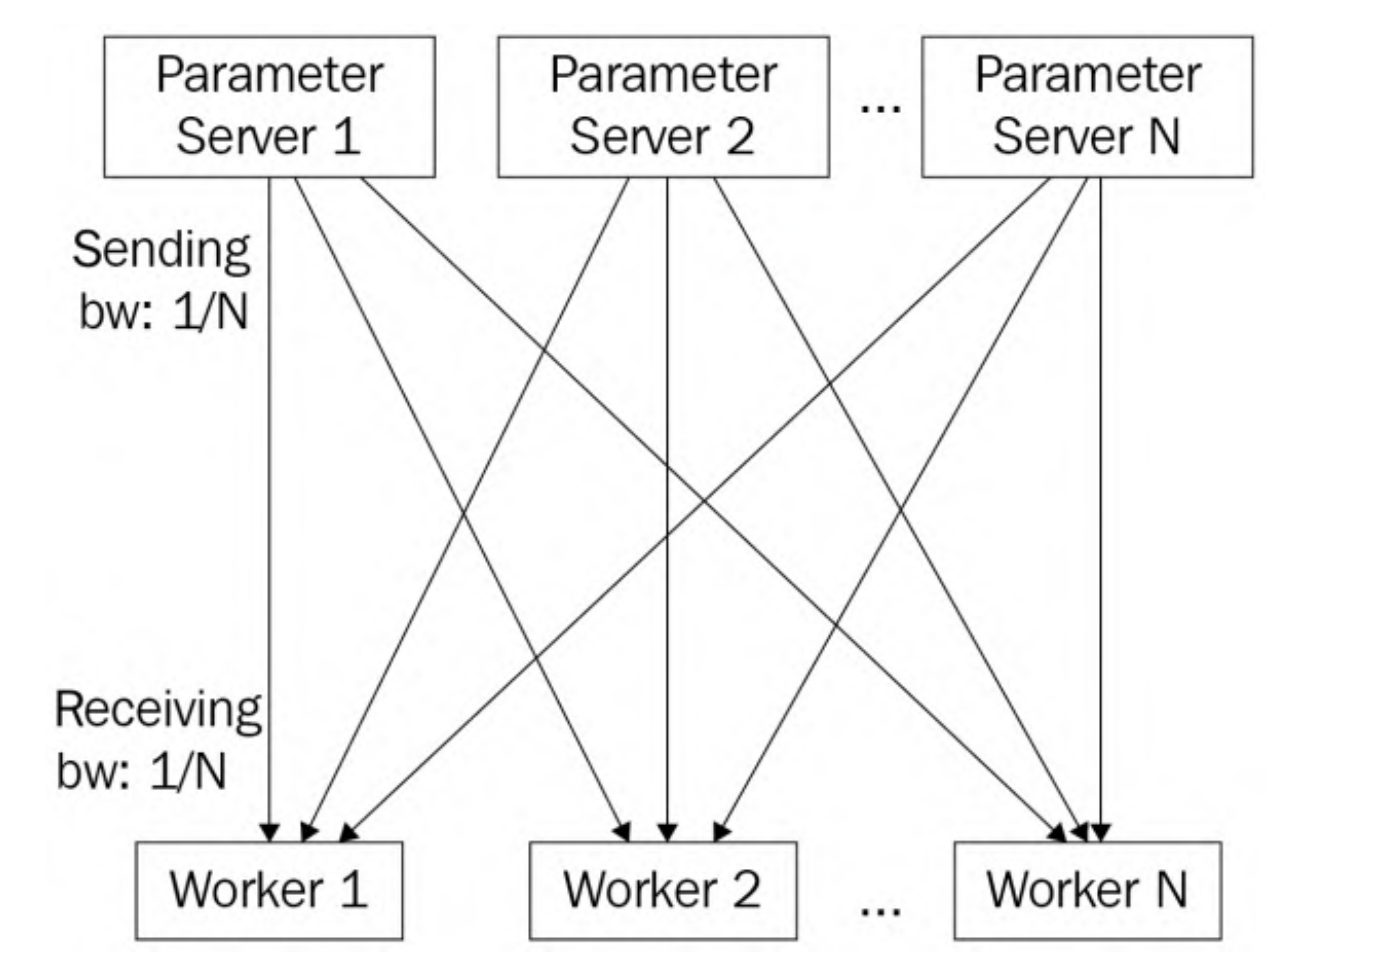
可见,上述的Pull Weights和Push Gradients涉及到通信,首先对于Pull Weights来说,参数服务器同时向worker发送权重,这是一对多的通信模式,称为fan-out通信模式。假设每个节点(参数服务器和工作节点)的通信带宽都为1。假设在这个数据并行训练作业中有N个工作节点,由于集中式参数服务器需要同时将模型发送给N个工作节点,因此每个工作节点的发送带宽(BW)仅为1/N。另一方面,每个工作节点的接收带宽为1,远大于参数服务器的发送带宽1/N。因此,在拉取权重阶段,参数服务器端存在通信瓶颈。
对于Push Gradients来说,所有的worker并发地发送梯度给参数服务器,称为fan-in通信模式,参数服务器同样存在通信瓶颈。
基于上述讨论,通信瓶颈总是发生在参数服务器端,将通过负载均衡解决这个问题
将模型划分为N个参数服务器,每个参数服务器负责更新1/N的模型参数。实际上是将模型参数分片(sharded model)并存储在多个参数服务器上,可以缓解参数服务器一侧的网络瓶颈问题,使得参数服务器之间的通信负载减少,提高整体的通信效率。
代码实现
定义网络结构:
class Net(nn.Module):

    def __init__(self):

        super(Net,self).__init__()

        if torch.cuda.is_available():

            device = torch.device("cuda:0")

        else:

            device = torch.device("cpu")

        self.conv1 = nn.Conv2d(1,32,3,1).to(device)

        self.dropout1 = nn.Dropout2d(0.5).to(device)

        self.conv2 = nn.Conv2d(32,64,3,1).to(device)

        self.dropout2 = nn.Dropout2d(0.75).to(device)

        self.fc1 = nn.Linear(9216,128).to(device)

        self.fc2 = nn.Linear(128,20).to(device)

        self.fc3 = nn.Linear(20,10).to(device)

    def forward(self,x):

        x = self.conv1(x)

        x = self.dropout1(x)

        x = F.relu(x)

        x = self.conv2(x)

        x = self.dropout2(x)

        x = F.max_pool2d(x,2)

        x = torch.flatten(x,1)

        x = self.fc1(x)

        x = F.relu(x)

        x = self.fc2(x)

        x = F.relu(x)

        x = self.fc3(x)

        output = F.log_softmax(x,dim=1)

        return output
如上定义了一个简单的CNN
实现参数服务器:
class ParamServer(nn.Module):

    def __init__(self):

        super().__init__()

        self.model = Net()

        if torch.cuda.is_available():

            self.input_device = torch.device("cuda:0")

        else:

            self.input_device = torch.device("cpu")

        self.optimizer = optim.SGD(self.model.parameters(),lr=0.5)

    def get_weights(self):

        return self.model.state_dict()

    def update_model(self,grads):

        for para,grad in zip(self.model.parameters(),grads):

            para.grad = grad

        self.optimizer.step()

        self.optimizer.zero_grad()
get_weights获取权重参数,update_model更新模型,采用SGD优化器
实现worker:
class Worker(nn.Module):

    def __init__(self):

        super().__init__()

        self.model = Net()

        if torch.cuda.is_available():

            self.input_device = torch.device("cuda:0")

        else:

            self.input_device = torch.device("cpu")

    def pull_weights(self,model_params):

        self.model.load_state_dict(model_params)

    def push_gradients(self,batch_idx,data,target):

        data,target = data.to(self.input_device),target.to(self.input_device)

        output = self.model(data)

        data.requires_grad = True

        loss = F.nll_loss(output,target)

        loss.backward()

        grads = []

        for layer in self.parameters():

            grad = layer.grad

            grads.append(grad)

        print(f"batch {batch_idx} training :: loss {loss.item()}")

        return grads
Pull_weights获取模型参数,push_gradients上传梯度
训练
训练数据集为MNIST
import torch

from torchvision import datasets,transforms

from network import Net

from worker import *

from server import *

train_loader = torch.utils.data.DataLoader(datasets.MNIST('./mnist_data', download=True, train=True,

               transform = transforms.Compose([transforms.ToTensor(),

               transforms.Normalize((0.1307,),(0.3081,))])),

               batch_size=128, shuffle=True)

test_loader = torch.utils.data.DataLoader(datasets.MNIST('./mnist_data', download=True, train=False,

              transform = transforms.Compose([transforms.ToTensor(),

              transforms.Normalize((0.1307,),(0.3081,))])),

              batch_size=128, shuffle=True)

def main():

    server = ParamServer()

    worker = Worker()

    for batch_idx, (data,target) in enumerate(train_loader):

        params = server.get_weights()

        worker.pull_weights(params)

        grads = worker.push_gradients(batch_idx,data,target)

        server.update_model(grads)

    print("Done Training")

if __name__ == "__main__":

    main()
分布式机器学习(Parameter Server)的更多相关文章
- 分布式机器学习系统笔记(一)——模型并行,数据并行,参数平均,ASGD
欢迎转载,转载请注明:本文出自Bin的专栏blog.csdn.net/xbinworld. 技术交流QQ群:433250724,欢迎对算法.技术.应用感兴趣的同学加入. 文章索引::"机器学 ...
- 百度DMLC分布式深度机器学习开源项目(简称“深盟”)上线了如xgboost(速度快效果好的Boosting模型)、CXXNET(极致的C++深度学习库)、Minerva(高效灵活的并行深度学习引擎)以及Parameter Server(一小时训练600T数据)等产品,在语音识别、OCR识别、人脸识别以及计算效率提升上发布了多个成熟产品。
百度为何开源深度机器学习平台? 有一系列领先优势的百度却选择开源其深度机器学习平台,为何交底自己的核心技术?深思之下,却是在面对业界无奈时的远见之举. 5月20日,百度在github上开源了其 ...
- 【分布式计算】MapReduce的替代者-Parameter Server
原文:http://blog.csdn.net/buptgshengod/article/details/46819051 首先还是要声明一下,这个文章是我在入职阿里云1个月以来,对于分布式计算的一点 ...
- MXNet之ps-lite及parameter server原理
MXNet之ps-lite及parameter server原理 ps-lite框架是DMLC组自行实现的parameter server通信框架,是DMLC其他项目的核心,例如其深度学习框架MXNE ...
- 转:Parameter Server 详解
Parameter Server 详解 本博客仅为作者记录笔记之用,不免有很多细节不对之处. 还望各位看官能够见谅,欢迎批评指正. 更多相关博客请猛戳:http://blog.csdn.net/c ...
- Adam:大规模分布式机器学习框架
引子 转载请注明:http://blog.csdn.net/stdcoutzyx/article/details/46676515 又是好久没写博客,记得有一次看Ng大神的訪谈录,假设每周读三篇论文, ...
- 分布式机器学习框架:MxNet 前言
原文连接:MxNet和Caffe之间有什么优缺点一.前言: Minerva: 高效灵活的并行深度学习引擎 不同于cxxnet追求极致速度和易用性,Minerva则提供了一个高效灵活的平台 ...
- [Distributed ML] Parameter Server & Ring All-Reduce
Resource ParameterServer入门和理解[较为详细,涉及到另一个框架:ps-lite] 一文读懂「Parameter Server」的分布式机器学习训练原理 并行计算与机器学习[很有 ...
- parameter server学习
关于parameter server的学习: https://www.zybuluo.com/Dounm/note/517675 机器学习系统相比于其他系统而言,有一些自己的独特特点.例如: 迭代性: ...
- 分布式机器学习框架:CXXNet
caffe是很优秀的dl平台.影响了后面很多相关框架. cxxnet借鉴了很多caffe的思想.相比之下,cxxnet在实现上更加干净,例如依赖很少,通过mshadow的模板化使得gpu ...
随机推荐
- 续集来了!我让 GPT-4 用 Laf 三分钟写了个完整的待办事项 App
书接前文,上篇文章我们教大家如何三分钟时间用 Laf 实现一个自己的 ChatGPT. 一觉醒来,GPT-4 已经发布了! GPT-4 实现了真正的多模态,可以把纸笔画的原型直接写出网页代码.读论文时 ...
- RunnerGo可视化场景管理,还原真实场景
在进行性能测试时,测试场景的正确配置非常关键.首先,需要根据业务场景和需求,设计出合理的测试场景,再利用相应的工具进行配置,实现自动化的性能测试. 在JMeter中,用户需要自己组织测试场景,或是在同 ...
- NX二次开发:保存时导出PDF并打开
该工程为在保存时执行开发的功能,函数入口点ufput.其他还有新建.打开.另存等都可以加入开发的操作,具体看UF_EXIT下的介绍. 用户出口是一个可选特性,允许你在NX中某些预定义的位置(或出口)自 ...
- C++ 测试框架 GoogleTest 初学者入门篇 甲
*以下内容为本人的学习笔记,如需要转载,请声明原文链接微信公众号「ENG八戒」https://mp.weixin.qq.com/s/BS_u9A4EY50y4vDDuxkCAQ 开发者虽然主要负责工程 ...
- java魔功心法-范型篇
前言: https://www.cnblogs.com/LoveBB/p/17277662.html 什么是范型 JDK 1.5开始引入Java泛型(generics)这个特性,该特性提供了编译时类型 ...
- 高尔顿钉板的统计意义—R实现
提到高尔顿,人们总是把他和钉板实验联系在一起,偶尔也会有人提及他是达尔文的表弟.实际上,作为维多利亚时代的人类学家.统计学家.心理学家和遗传学家,同时又是热带探险家.地理学家.发明家.气象学家,高尔顿 ...
- 华为人工智能atlasA800-9000物理服务器离线安装及CANN安装和MindSpore安装和Tensorflow安装
目录 华为人工智能atlas A800-9000 物理服务器全程离线安装驱动以及CANN安装部署和MindSpore安装部署和Tensorflow安装部署 A800-9000 物理服务器安装驱动 使用 ...
- SSM整合的所有配置(配置类)
导入依赖坐标pom.xml <dependencies> <dependency> <groupId>junit</groupId> <artif ...
- LeeCode 942 增减字符串匹配
LeeCode 942 题目描述: 由范围 [0,n] 内所有整数组成的 n+1 个整数的排列序列可以表示为长度为 n 的字符串 s ,其中: 如果 perm[i] < perm[i + 1] ...
- 两种路由模式的区别(hash模式,history模式)
1. hash 带#号的,history不带#号2.hash模式用的hashChange监听路径的变化3.history用的是HTML5相关的API语法 使用pushState => 添加一条历 ...