
Elasticsearch: rollover API
rollover使您可以根据索引大小,文档数或使用期限自动过渡到新索引。 当rollover触发后,将创建新索引,写别名(write alias)将更新为指向新索引,所有后续更新都将写入新索引。
对于基于时间的rollover来说,基于大小,文档数或使用期限过渡至新索引是比较适合的。 在任意时间rollover通常会导致许多小的索引,这可能会对性能和资源使用产生负面影响。
Rollover历史数据
在大多数情况下,无限期保留历史数据是不可行的
- 时间序列数据随着时间的流逝而失去价值,我们最终不得不将其删除
- 但是其中一些数据对于分析仍然非常有用
Elasticsearch 6.3引入了一项新的rollover功能,该功能
- 以紧凑的聚合格式保存旧数据
- 仅保存您感兴趣的数据

就像上面的图片看到的那样,我们定义了一个叫做logs-alias的alias,对于写操作来说,它总是会自动指向最新的可以用于写入index的一个索引。针对我们上面的情况,它指向logs-000002。如果新的rollover发生后,新的logs-000003将被生成,并对于写操作来说,它自动指向最新生产的logs-000003索引。而对于读写操作来说,它将同时指向最先的logs-1,logs-000002及logs-000003。在这里我们需要注意的是:在我们最早设定index名字时,最后的一个字符必须是数字,比如我们上面显示的logs-1。否则,自动生产index将会失败。
rollover例子
我们还是先拿一个rollover的例子来说明,这样比较清楚。首先我们定义一个log-alias的alias:
    PUT /%3Clogs-%7Bnow%2Fd%7D-1%3E

    {

      "aliases": {

        "log_alias": {

          "is_write_index": true

        }

      }

    }
如果大家对于上面的字符串“%3Clogs-%7Bnow%2Fd%7D-1%3E”比较陌生的话,可以参考网站https://www.urlencoder.io/。实际上它就是字符串“<logs-{now/d}-1>”的url编码形式。请注意上面的is_write_index必须设置为true。运行上面的结果是:
    {

      "acknowledged" : true,

      "shards_acknowledged" : true,

      "index" : "logs-2019.10.21-1"

    }
显然,它帮我们生产了一个叫做logs-2019.10.21-1的index。接下来,我们先使用我们的Kibana来准备一下我们的index数据。我们运行起来我们的Kibana:
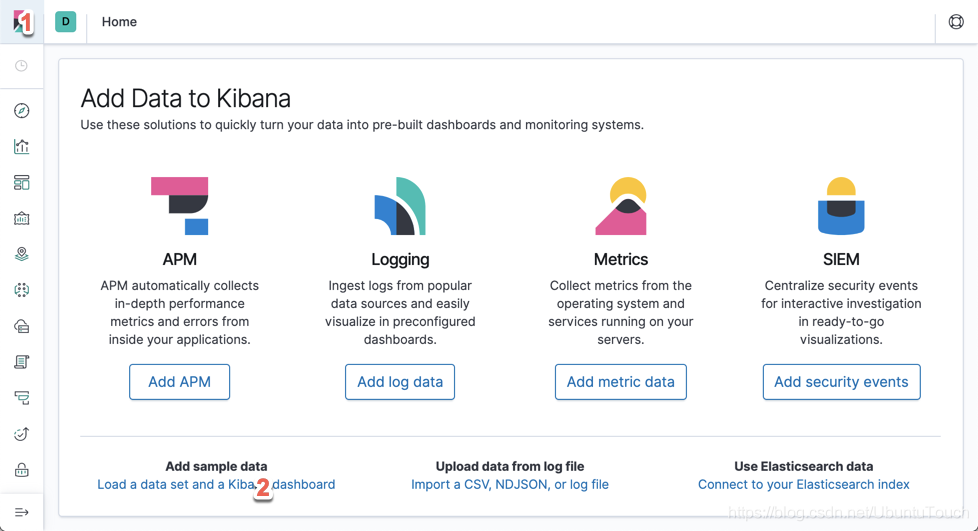
我们分别点击上面的1和2处:
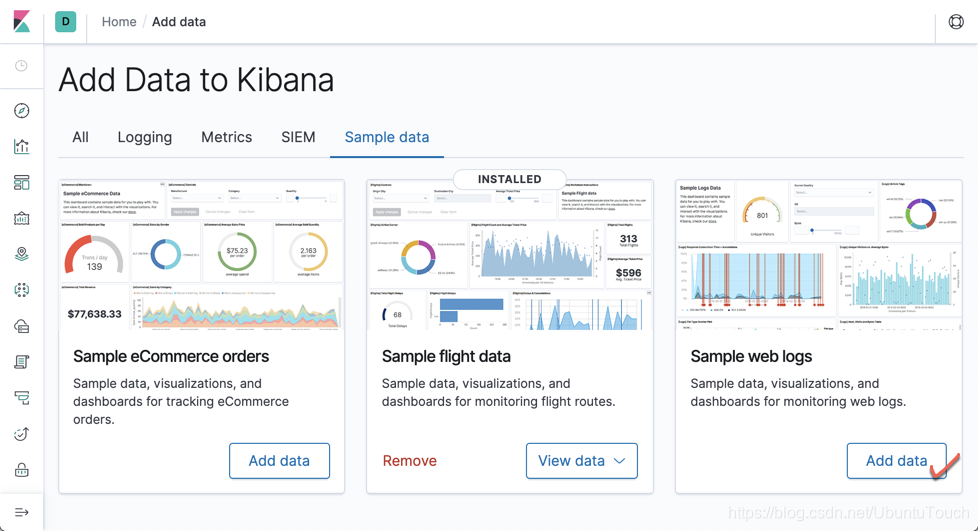
点击上面的“Add data”。这样我们就可以把我们的kibana_sample_data_logs索引加载到Elasticsearch中。我们可以通过如下的命令进行查看:
GET _cat/indices/kibana_sample_data_logs
命令显示结果为:
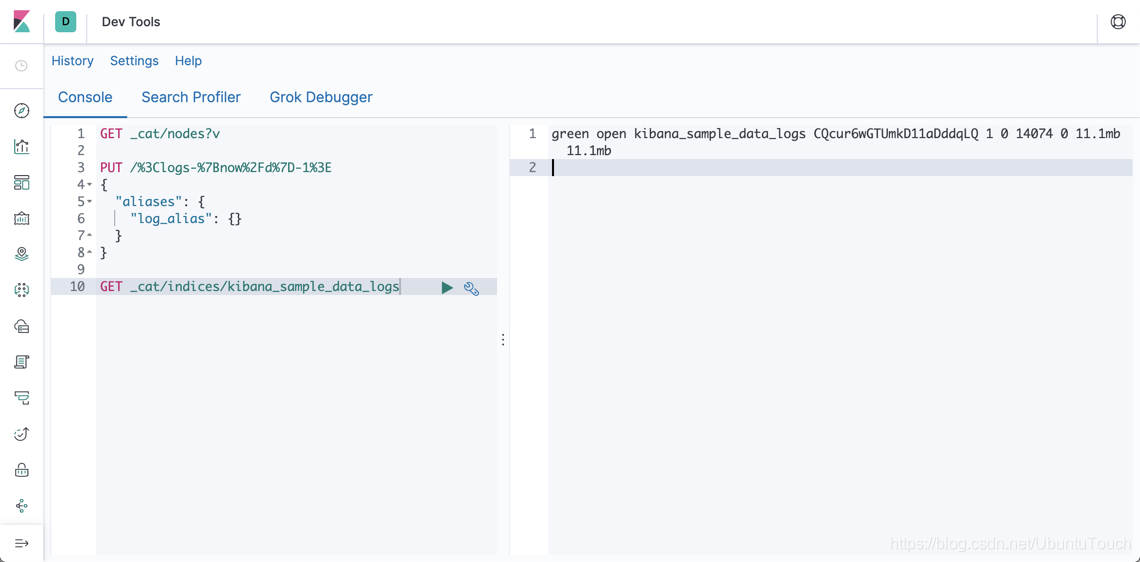
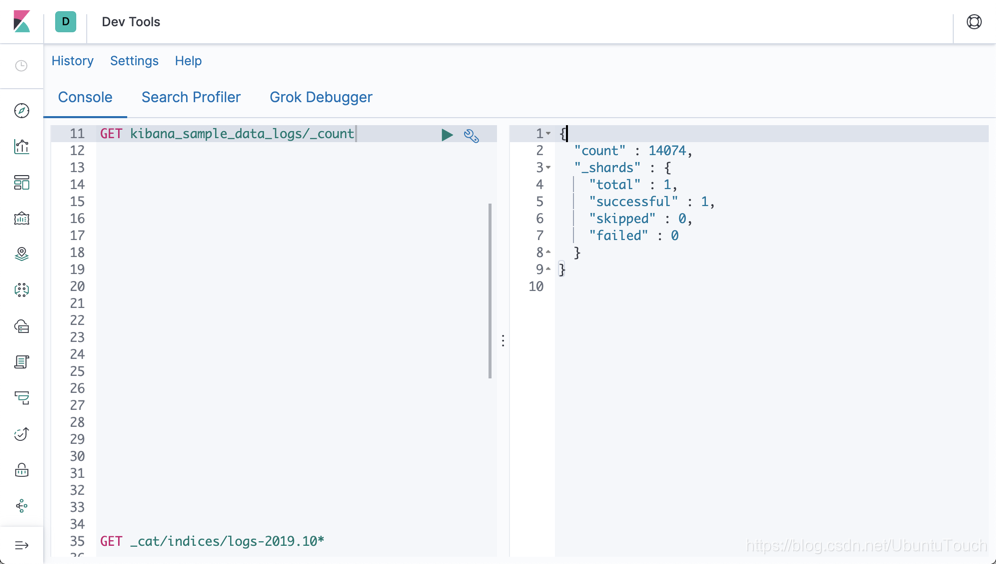
它显示kibana_sample_data_logs具有11.1M的数据,并且它有14074个文档:
我们接下来运行如下的命令:
    POST _reindex

    {

      "source": {

        "index": "kibana_sample_data_logs"

      },

      "dest": {

        "index": "log_alias"

      }

    }
这个命令的作用是把kibana_sample_data_logs里的数据reindex到log_alias所指向的index。也就是把kibana_sample_data_logs的文档复制一份到我们上面显示的logs-2019.10.21-1索引里。我们做如下的操作查看一下结果:
GET logs-2019.10.21-1/_count
显示的结果是:
    {

      "count" : 14074,

      "_shards" : {

        "total" : 1,

        "successful" : 1,

        "skipped" : 0,

        "failed" : 0

      }

    }
显然,我们已经复制到所有的数据。那么接下来,我们来运行如下的一个指令:
    POST /log_alias/_rollover?dry_run

    {

      "conditions": {

        "max_age": "7d",

        "max_docs": 14000,

        "max_size": "5gb"

      }

    }
在这里,我们定义了三个条件:
- 如果时间超过7天,那么自动rollover,也就是使用新的index
- 如果文档的数目超过14000个,那么自动rollover
- 如果index的大小超过5G,那么自动rollover
在上面我们使用了dry_run参数,表明就是运行时看看,但不是真正地实施。显示的结果是:
    {

      "acknowledged" : false,

      "shards_acknowledged" : false,

      "old_index" : "logs-2019.10.21-1",

      "new_index" : "logs-2019.10.21-000002",

      "rolled_over" : false,

      "dry_run" : true,

      "conditions" : {

        "[max_docs: 1400]" : true,

        "[max_size: 5gb]" : false,

        "[max_age: 7d]" : false

      }

    }
根据目前我们的条件,我们的logs-2019.10.21-1文档数已经超过14000个了,所以会生产新的索引logs-2019.10.21-000002。因为我使用了dry_run,也就是演习,所以显示的rolled_over是false。
为了能真正地rollover,我们运行如下的命令:
    POST /log_alias/_rollover

    {

      "conditions": {

        "max_age": "7d",

        "max_docs": 1400,

        "max_size": "5gb"

      }

    }
显示的结果是:
    {

      "acknowledged" : true,

      "shards_acknowledged" : true,

      "old_index" : "logs-2019.10.21-1",

      "new_index" : "logs-2019.10.21-000002",

      "rolled_over" : true,

      "dry_run" : false,

      "conditions" : {

        "[max_docs: 1400]" : true,

        "[max_size: 5gb]" : false,

        "[max_age: 7d]" : false

      }

    }
说明它已经rolled_ovder了。我们可以通过如下写的命令来检查:
GET _cat/indices/logs-2019*
显示的结果为:

我们现在可以看到有两个以logs-2019.10.21为头的index,并且第二文档logs-2019.10.21-000002文档数为0。如果我们这个时候直接再想log_alias写入文档的话:
    POST log_alias/_doc

    {

      "agent": "Mozilla/5.0 (X11; Linux x86_64; rv:6.0a1) Gecko/20110421 Firefox/6.0a1",

      "bytes": 6219,

      "clientip": "223.87.60.27",

      "extension": "deb",

      "geo": {

        "srcdest": "IN:US",

        "src": "IN",

        "dest": "US",

        "coordinates": {

          "lat": 39.41042861,

          "lon": -88.8454325

        }

      },

      "host": "artifacts.elastic.co",

      "index": "kibana_sample_data_logs",

      "ip": "223.87.60.27",

      "machine": {

        "ram": 8589934592,

        "os": "win 8"

      },

      "memory": null,

      "message": """

      223.87.60.27 - - [2018-07-22T00:39:02.912Z] "GET /elasticsearch/elasticsearch-6.3.2.deb_1 HTTP/1.1" 200 6219 "-" "Mozilla/5.0 (X11; Linux x86_64; rv:6.0a1) Gecko/20110421 Firefox/6.0a1"

      """,

      "phpmemory": null,

      "referer": "http://twitter.com/success/wendy-lawrence",

      "request": "/elasticsearch/elasticsearch-6.3.2.deb",

      "response": 200,

      "tags": [

        "success",

        "info"

      ],

      "timestamp": "2019-10-13T00:39:02.912Z",

      "url": "https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-6.3.2.deb_1",

      "utc_time": "2019-10-13T00:39:02.912Z"

    }
显示的结果:
    {

      "_index" : "logs-2019.10.21-000002",

      "_type" : "_doc",

      "_id" : "xPyQ7m0BsjOKp1OsjsP8",

      "_version" : 1,

      "result" : "created",

      "_shards" : {

        "total" : 1,

        "successful" : 1,

        "failed" : 0

      },

      "_seq_no" : 1,

      "_primary_term" : 1

    }
显然它写入的是logs-2019.10.21-000002索引。我们再次查询log_alias的总共文档数:
GET log_alias/_count
显示的结果是:
    {

      "count" : 14075,

      "_shards" : {

        "total" : 2,

        "successful" : 2,

        "skipped" : 0,

        "failed" : 0

      }

    }
显然它和之前的14074个文档多增加了一个文档,也就是说log_alias是同时指向logs-2019.10.21-1及logs-2019.10.21-000002。
总结:在今天的文档里,我们讲述了如何使用rollover API来自动管理我们的index。利用rollover API,它可以很方便地帮我们自动根据我们设定的条件帮我们把我们的Index过度到新的index。在未来的文章里,我们将讲述如何使用Index life cycle policy来帮我们管理我们的index。
Elasticsearch: rollover API的更多相关文章
- elasticsearch REST API方式批量插入数据
elasticsearch REST API方式批量插入数据 1:ES的服务地址 http://127.0.0.1:9600/_bulk 2:请求的数据体,注意数据的最后一行记得加换行 { &quo ...
- [搜索]ElasticSearch Java Api(一) -添加数据创建索引
转载:http://blog.csdn.net/napoay/article/details/51707023 ElasticSearch JAVA API官网文档:https://www.elast ...
- Elasticsearch java api 基本搜索部分详解
文档是结合几个博客整理出来的,内容大部分为转载内容.在使用过程中,对一些疑问点进行了整理与解析. Elasticsearch java api 基本搜索部分详解 ElasticSearch 常用的查询 ...
- Elasticsearch java api 常用查询方法QueryBuilder构造举例
转载:http://m.blog.csdn.net/u012546526/article/details/74184769 Elasticsearch java api 常用查询方法QueryBuil ...
- ElasticSearch的API介绍
ElasticSearch的API介绍 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.ES是基于Restful风格 1>ES是基于Restful风格 Elasticsea ...
- 搜索引擎Elasticsearch REST API学习
Elasticsearch为开发者提供了一套基于Http协议的Restful接口,只需要构造rest请求并解析请求返回的json即可实现访问Elasticsearch服务器.Elasticsearch ...
- 第08章 ElasticSearch Java API
本章内容 使用客户端对象(client object)连接到本地或远程ElasticSearch集群. 逐条或批量索引文档. 更新文档内容. 使用各种ElasticSearch支持的查询方式. 处理E ...
- Elasticsearch 常用API
1. Elasticsearch 常用API 1.1.数据输入与输出 1.1.1.Elasticsearch 文档 #在 Elasticsearch 中,术语 文档 有着特定的含义.它是指最顶 ...
- elasticsearch REST api
elasticsearch REST api========================================命令模式:<REST Verb> /<Index>/ ...
随机推荐
- MyBatis 映射文件
Mybatis映射文件简介 1) MyBatis 的真正强大在于它的映射语句.由于它的异常强大,映射器的 XML 文件就显得相对简单.如果拿它跟具有相同功能的 JDBC 代码进行对比,你会立即发现省掉 ...
- Java8 Stream 的最佳实践
Java8 Stream 的最佳实践 java8stream提供了对于集合类的流失处理,其具有以下特点: Lazy Evaluation(长度可以无限) 只能使用一次 内部迭代 Lazy Evalua ...
- 如何学习Vim
如果你是Linux用户,学习Vim会有很大的好处. 如果你是windows用户,个人建议还是使用vscode. 准备大约40min的学习时间,打开终端,输入下面命令开启自带教程 vimtutor 按操 ...
- 一张图进阶 RocketMQ - 通信机制
前 言 三此君看了好几本书,看了很多遍源码整理的 一张图进阶 RocketMQ 图片,关于 RocketMQ 你只需要记住这张图!觉得不错的话,记得点赞关注哦. [重要]视频在 B 站同步更新,欢迎围 ...
- day06 Java_数组_方法_参数
精华笔记: 数组: 复制: System.arraycopy(a,1,b,0,4); int[ ] b = Arrays.copyOf(a,6); 排序: Arrays.sort(arr); //升序 ...
- c++小游戏--五子棋
大家好,我是芝麻狐! 这是我自制的小游戏,目前仅支持devc++. 如果你没有c++软件, 请打开网站GDB online Debugger | Compiler - Code, Compile, R ...
- 图文并茂演示小程序movable-view的可移动范围
前言 开发过小程序的同学可能对这两个内置组件并不陌生,他们配合用来实现在页面中可以拖拽滑动,其中: movable-area表示元素可移动的区域,它决定元素移动的区域范围 movable-view表示 ...
- 造!又有新的生产力语言了「GitHub 热点速览 v.22.30」
作者:HelloGitHub-小鱼干 你还记得那些 PHP 开发都去哪了吗?转 Golang 了!移动端现在流行什么?Flutter 编程.现在谷歌带着新的生产力语言来了,Carbon,代号:C++ ...
- openstack 虚拟机网卡被重名为cirename0
虚拟机网卡被重名为cirename0 在虚拟机挂载多网卡情况下,你在虚拟机上卸载网卡后,再创建新的port挂给虚拟机使用,如果虚拟机不经过重启的话,是不会有任何问题的.但是,如果虚拟机重启了,你 ...
- Win10环境下使用Flask配合Celery异步推送实时/定时消息(Socket.io)/2020年最新攻略
原文转载自「刘悦的技术博客」https://v3u.cn/a_id_163 首先得明确一点,和Django一样,在2020年Flask 1.1.1以后的版本都不需要所谓的三方库支持,即Flask-Ce ...