
转:为什么数据库选B-tree或B+tree而不是二叉树作为索引结构
转载至:https://blog.csdn.net/sinat_27602945/article/details/80118362
B-Tree就是我们常说的B树,一定不要读成B减树,否则就很丢人了。B树这种数据结构常常用于实现数据库索引,因为它的查找效率比较高。
磁盘IO与预读
磁盘读取依靠的是机械运动,分为寻道时间、旋转延迟、传输时间三个部分,这三个部分耗时相加就是一次磁盘IO的时间,大概9ms左右。这个成本是访问内存的十万倍左右;正是由于磁盘IO是非常昂贵的操作,所以计算机操作系统对此做了优化:预读;每一次IO时,不仅仅把当前磁盘地址的数据加载到内存,同时也把相邻数据也加载到内存缓冲区中。因为局部预读原理说明:当访问一个地址数据的时候,与其相邻的数据很快也会被访问到。每次磁盘IO读取的数据我们称之为一页(page)。一页的大小与操作系统有关,一般为4k或者8k。这也就意味着读取一页内数据的时候,实际上发生了一次磁盘IO。
B-Tree与二叉查找树的对比
我们知道二叉查找树查询的时间复杂度是O(logN),查找速度最快和比较次数最少,既然性能已经如此优秀,但为什么实现索引是使用B-Tree而不是二叉查找树,关键因素是磁盘IO的次数。
数据库索引是存储在磁盘上,当表中的数据量比较大时,索引的大小也跟着增长,达到几个G甚至更多。当我们利用索引进行查询的时候,不可能把索引全部加载到内存中,只能逐一加载每个磁盘页,这里的磁盘页就对应索引树的节点。
一、 二叉树
我们先来看二叉树查找时磁盘IO的次:定义一个树高为4的二叉树,查找值为10:
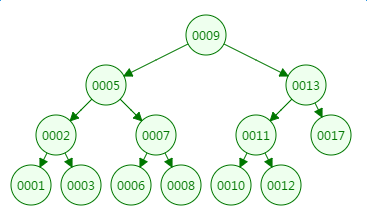
第一次磁盘IO:
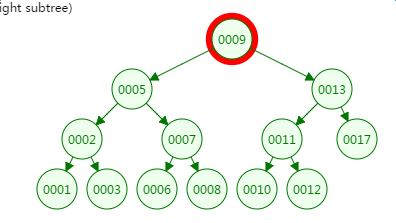
第二次磁盘IO

第三次磁盘IO
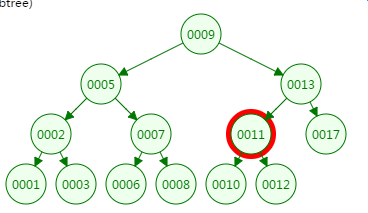
第四次磁盘IO:
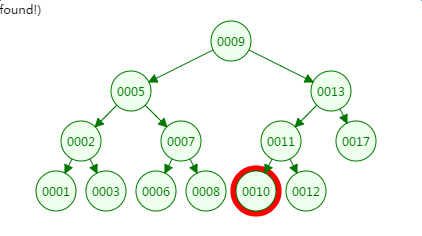
从二叉树的查找过程了来看,树的高度和磁盘IO的次数都是4,所以最坏的情况下磁盘IO的次数由树的高度来决定。
从前面分析情况来看,减少磁盘IO的次数就必须要压缩树的高度,让瘦高的树尽量变成矮胖的树,所以B-Tree就在这样伟大的时代背景下诞生了。
二、B-Tree
m阶B-Tree满足以下条件:
1、每个节点最多拥有m个子树
2、根节点至少有2个子树
3、分支节点至少拥有m/2颗子树(除根节点和叶子节点外都是分支节点)
4、所有叶子节点都在同一层、每个节点最多可以有m-1个key,并且以升序排列
如下有一个3阶的B树,观察查找元素21的过程:
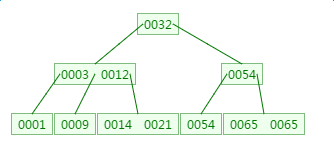
第一次磁盘IO:
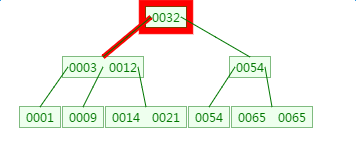
第二次磁盘IO:
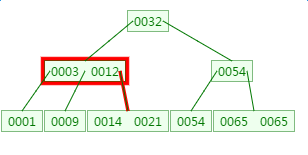
这里有一次内存对比:分别跟3与12对比
第三次磁盘IO:
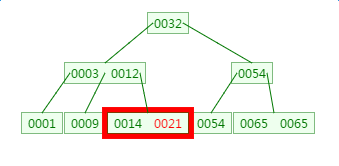
这里有一次内存比对,分别跟14与21比对
从查找过程中发现,B树的比对次数和磁盘IO的次数与二叉树相差不了多少,所以这样看来并没有什么优势。
但是仔细一看会发现,比对是在内存中完成中,不涉及到磁盘IO,耗时可以忽略不计。另外B树种一个节点中可以存放很多的key(个数由树阶决定)。
相同数量的key在B树中生成的节点要远远少于二叉树中的节点,相差的节点数量就等同于磁盘IO的次数。这样到达一定数量后,性能的差异就显现出来了。
转:为什么数据库选B-tree或B+tree而不是二叉树作为索引结构的更多相关文章
- Mysql Index、B Tree、B+ Tree、SQL Optimization
catalog . 引言 . Mysql索引 . Mysql B/B+ Tree . Mysql SQL Optimization . MySQL Query Execution Process 1. ...
- 数据库索引<一> 索引结构表结构
有很长时间没有更新博客了,再过几天都2月分了,如果再不更新一篇,我1月分都没有更新,保持连续,今天更新一篇. 最近没有什么看技术方面的东西,游戏,画画搞这些去了.我发现我每年一到年底就是搞这些东西,其 ...
- 数据库为什么要用B+树结构--MySQL索引结构的实现(转)
B+树在数据库中的应用 { 为什么使用B+树?言简意赅,就是因为: 1.文件很大,不可能全部存储在内存中,故要存储到磁盘上 2.索引的结构组织要尽量减少查找过程中磁盘I/O的存取次数(为什么使用B-/ ...
- 关系型数据库为什么喜欢使用B+树作为索引结构? (转)
问题1. 数据库为什么要设计索引? 图书馆存了1000W本图书,要从中找到<架构师之路>,一本本查,要查到什么时候去? 于是,图书管理员设计了一套规则: (1)一楼放历史类,二楼放文学类, ...
- 【Java面试】Mysql为什么使用B+Tree作为索引结构
一个工作8年的粉丝私信了我一个问题. 他说这个问题是去阿里面试的时候被问到的,自己查了很多资料也没搞明白,希望我帮他解答. 问题是: "Mysql为什么使用B+Tree作为索引结构" ...
- B-Tree、B+Tree和B*Tree
B-Tree(这儿可不是减号,就是常规意义的BTree) 是一种多路搜索树: 1.定义任意非叶子结点最多只有M个儿子:且M>2: 2.根结点的儿子数为[2, M]: 3.除根结点以外的非叶子结点 ...
- 【Luogu1501】Tree(Link-Cut Tree)
[Luogu1501]Tree(Link-Cut Tree) 题面 洛谷 题解 \(LCT\)版子题 看到了顺手敲一下而已 注意一下,别乘爆了 #include<iostream> #in ...
- 【BZOJ3282】Tree (Link-Cut Tree)
[BZOJ3282]Tree (Link-Cut Tree) 题面 BZOJ权限题呀,良心luogu上有 题解 Link-Cut Tree班子提 最近因为NOIP考炸了 学科也炸了 时间显然没有 以后 ...
- [LeetCode] Encode N-ary Tree to Binary Tree 将N叉树编码为二叉树
Design an algorithm to encode an N-ary tree into a binary tree and decode the binary tree to get the ...
随机推荐
- 【C#基础概念】程序集Assembliy
一. 程序集定义 二. 程序集结构 通常,静态程序集可能由以下四个元素组成: 程序集清单(manifest) 类型元数据metadata和程序集元数据. 实现这些类型的 Micro ...
- GAN实战笔记——第六章渐进式增长生成对抗网络(PGGAN)
渐进式增长生成对抗网络(PGGAN) 使用 TensorFlow和 TensorFlow Hub( TFHUB)构建渐进式增长生成对抗网络( Progressive GAN, PGGAN或 PROGA ...
- 记一次加密的ts视频下载
想要下载一个视频,但是网站上不能直接下载.试过IDM,以及Streaming Video Recorder 都不行.因为视频被加密了. ts 是分片的视频文件,m3u8 是播放索引列表(还可配置其他参 ...
- Qt:QMutex
0.说明 QMutex类提供了线程间的同步控制. QMutex的目的是,保护Object.数据结构.代码块,以便每次只有一个线程能访问它(类似Java中的synchronized关键字).不过更好的情 ...
- ASP.NET Core 6框架揭秘实例演示[17]:利用IHttpClientFactory工厂来创建HttpClient
在一个采用依赖注入框架的应用中,我们一般不太推荐利用手工创建的HttpClient对象来进行HTTP调用,使用的HttpClient对象最好利用注入的IHttpClientFactory工厂来创建.前 ...
- 微信小程序授权获取手机号
wxml: <text>pages/logins/logins.wxml</text> // <button open-type="getPhoneNumber ...
- tp5文件上传实现缩略图+水印的功能(参考)
public function AddNews(){ $data = Request::instance()->param(); //接收文件 $file = request()->fil ...
- 商品模型:SPU、商品、SKU概念模型设计
商品系统是电商SaaS.新零售SaaS最基础.最核心的系统之一.商品系统几乎需要支撑所有业务系统,商品详情.购物车.订单.履约.结算.售后.库存.供应链等,都需要依赖商品系统的能力.为了保障业务的稳定 ...
- SQL Server2012安装教程
什么是SQL? 结构化查询语言(Structured Query Language)简称SQL,是一种特殊目的的编程语言,是一种数据库查询和程序设计语言,用于存取数据以及查询.更新和管理关系数据库系统 ...
- calcite物化视图详解
概述 物化视图和视图类似,反映的是某个查询的结果,但是和视图仅保存SQL定义不同,物化视图本身会存储数据,因此是物化了的视图. 当用户查询的时候,原先创建的物化视图会注册到优化器中,用户的查询命中物化 ...