
SQL Server 索引的自动维护 <第十三篇>
在有大量事务的数据库中,表和索引随着时间的推移而碎片化。因此,为了增进性能,应该定期检查表和索引的碎片,并对具有大量碎片的进行整理。
1、确定当前数据库中所有需要分析碎片的表。
2、确定所有表和索引的碎片。
3、考虑一下因素以确定需要进行碎片整理的表和索引。
- 高的碎片水平-avg_fragmentation_in_percent大于20%;
- 不是非常小的表或索引-也就是page_count大于8的;
4、整理具有大量碎片的表和索引;
这里给出一个样板SQL存储过程,它执行以下操作;
- 遍历系统上的所有数据库并确认符合碎片条件的每个数据库中表上的索引,并将它们保存到一个临时表中;
- 根据碎片水平,重新整理碎片较少的索引并重建碎片很多的索引。

CREATE PROCEDURE IndexDefrag

AS

DECLARE @DBName NVARCHAR(255)

    ,@TableName NVARCHAR(255)

    ,@SchemaName NVARCHAR(255)

    ,@IndexName NVARCHAR(255)

    ,@PctFrag DECIMAL

DECLARE @Defrag NVARCHAR(MAX)

IF EXISTS (SELECT * FROM sys.objects WHERE OBJECT_ID = OBJECT_ID(N'#Frag'))

    DROP TABLE #Frag

CREATE TABLE #Frag

(DBName NVARCHAR(255)

,TableName NVARCHAR(255)

,SchemaName NVARCHAR(255)

,IndexName NVARCHAR(255)

,AvgFragment DECIMAL)

EXEC sp_msforeachdb 'INSERT INTO #Frag (

    DBName,

    TableName,

    SchemaName,

    IndexName,

    AvgFragment

) SELECT  ''?'' AS DBName

       ,t.Name AS TableName

       ,sc.Name AS SchemaName

       ,i.name AS IndexName

       ,s.avg_fragmentation_in_percent

FROM    ?.sys.dm_db_index_physical_stats(DB_ID(''?''), NULL, NULL,

                                       NULL, ''Sampled'') AS s

        JOIN ?.sys.indexes i

        ON s.Object_Id = i.Object_id

           AND s.Index_id = i.Index_id

        JOIN ?.sys.tables t

        ON i.Object_id = t.Object_Id

        JOIN ?.sys.schemas sc

        ON t.schema_id = sc.SCHEMA_ID

WHERE s.avg_fragmentation_in_percent > 20

AND t.TYPE = ''U''

AND s.page_count > 8

ORDER BY TableName,IndexName'

DECLARE cList CURSOR

FOR SELECT * FROM #Frag

OPEN cList

FETCH NEXT FROM cList

INTO @DBName, @TableName,@SchemaName,@IndexName,@PctFrag

WHILE @@FETCH_STATUS = 0

BEGIN

    IF @PctFrag BETWEEN 20.0 AND 40.0

    BEGIN

        SET @Defrag = N'ALTER INDEX ' + @IndexName + ' ON ' + @DBName + '.' + @SchemaName + '.' + @TableName + ' REORGANIZE'

        EXEC sp_executesql @Defrag

        PRINT 'Reorganize index: ' + @DBName + '.' + @SchemaName + '.' + @TableName +'.' + @IndexName

    END

    ELSE IF @PctFrag > 40.0

    BEGIN

        SET @Defrag = N'ALTER INDEX ' + @IndexName + ' ON ' + @DBName + '.' + @SchemaName + '.' + @TableName + ' REBUILD'

        EXEC sp_executesql @Defrag

        PRINT 'Rebuild index: '+ @DBName + '.' + @SchemaName + '.' + @TableName +'.' + @IndexName

    END

    FETCH NEXT FROM cList

    INTO @DBName, @TableName,@SchemaName,@IndexName,@PctFrag

END

CLOSE cList

DEALLOCATE cList

DROP TABLE #Frag
为了自动化碎片分析过程,可以从SQL Server企业管理器中用以下简单的步骤创建一个SQL Server任务。
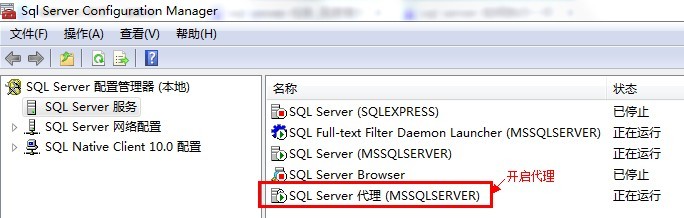
1、开启SQL Server代理;
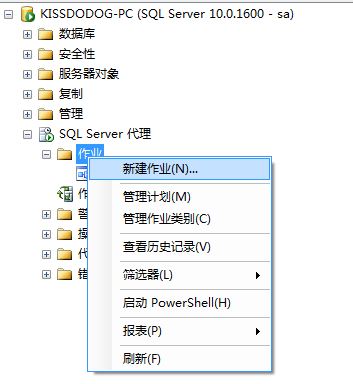
2、打开Management Studio,右键单击,选择新建=》任务;
3、在新建任务对话框的“常规”页面中,输入任务名称和其他细节:

4、在新建任务对话框的“步骤”页面中,单击“新建”并输入用户数据库的SQL命令。

5、在新建任务步骤对话框“高级”页面上,输入报告碎片分析结果的输出文件名称:

6、单击“确定”按钮,返回新建作业对话框;
7、在新建任务对话框“计划”页面,单击“新建计划”,并输入运行SQL Server任务的合适计划:
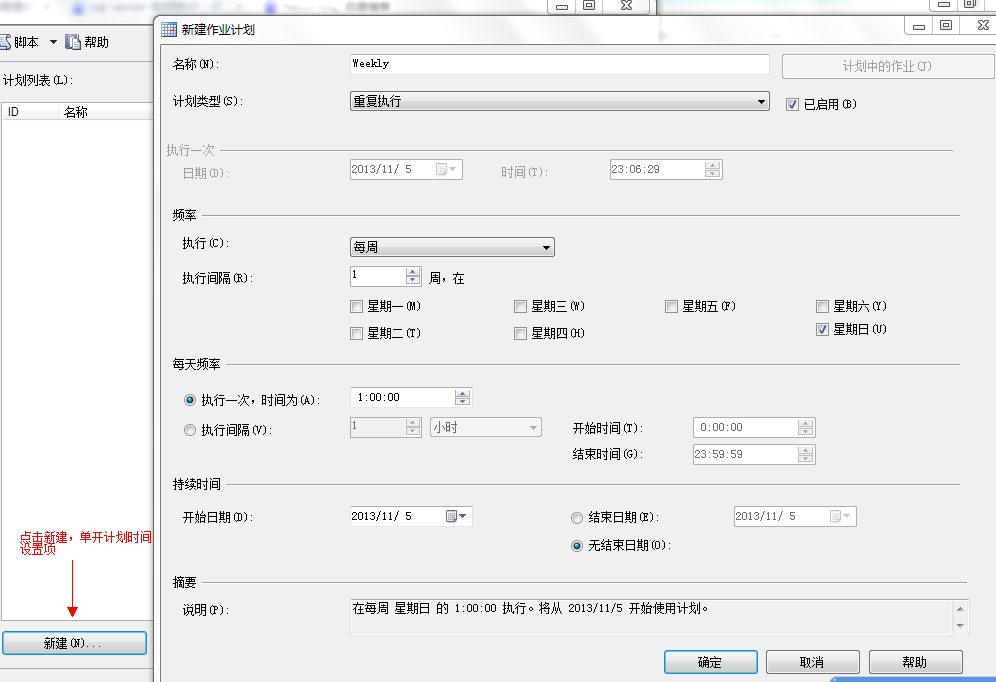
安排这个存储过程在非高峰执行。为了确定数据库的数据库模式,记录整天的SQL Server:SQL Statistics\Batch Requests/sec性能计数器,它将展示数据库负载的波动。
8、单击“确定”按钮,返回新建任务对话框。
9、输入所有信息后,单击新建任务对话框中的“确定”按钮创建SQL Server任务。创建计划在一个固定时间间隔(每周)运行sp_indexDefrag存储过程的SQL Server任务。
10、确保SQL Server代理运行,这样SQL Server任务将自动根据设置的计划运行。
这个SQL任务将在每个星期天的凌晨1点分析每个数据库并且进行碎片整理。
SQL Server 索引的自动维护 <第十三篇>的更多相关文章
- SQL Server 索引 之 书签查找 <第十一篇>
一.书签查找的概念 书签可以帮助SQL Server快速从非聚集索引条目导向到对应的行,其实这东西几句话我就能说明白. 如果表有聚集索引(区段结构),那么书签就是从非聚集索引找到聚集索引后,利用聚集索 ...
- SQL Server 索引知识-应用,维护
创建聚集索引 a索引键最好唯一(如果不唯一会隐形建立uniquier列(4字节)确保唯一,也就是这列都会复制到所有非聚集索引中) b聚集索引列所占空间应尽量小(否则也会使非聚集索引的空间变大) c聚集 ...
- 转: SQL Server索引的维护 - 索引碎片、填充因子
转:http://www.cnblogs.com/kissdodog/archive/2013/06/14/3135412.html 实际上,索引的维护主要包括以下两个方面: 页拆分 碎片 这两个问题 ...
- SQL Server索引的维护 - 索引碎片、填充因子 <第三篇>
实际上,索引的维护主要包括以下两个方面: 页拆分 碎片 这两个问题都和页密度有关,虽然两者的表现形式在本质上有所区别,但是故障排除工具是一样的,因为处理是相同的. 对于非常小的表(比64KB小得多), ...
- SQL Server 索引维护(1)——系统常见的索引问题
前言: 在很多系统中,比如本人目前管理的数据库,索引经常被滥用,甚至使用DTA(数据库引擎优化顾问)来成批创建索引(DTA目前个人认为它的真正用处应该是在发现缺失的统计信息,在以前的项目中,用过一次D ...
- SQL Server 索引维护:系统常见的索引问题
在很多系统中,比如本人目前管理的数据库,索引经常被滥用,甚至使用DTA(数据库引擎优化顾问)来成批创建索引(DTA目前个人认为它的真正用处应该是在发现缺失的统计信息,在以前的项目中,用过一次DTA,里 ...
- SQL Server索引 (原理、存储)聚集索引、非聚集索引、堆 <第一篇>
一.存储结构 在SQL Server中,有许多不同的可用排列规则选项. 二进制:按字符的数字表示形式排序(ASCII码中,用数字32表示空格,用68表示字母"D").因为所有内容都 ...
- SQL Server 索引介绍
数据库索引是对数据表中一个或多个列的值进行排序的结构,就像一本书的目录一样,索引提供了在行中快速查询特定行的能力 详细出处参考:http://www.jb51.net/article/30950.ht ...
- SQL Server索引设计 <第五篇>
SQL Server索引的设计主要考虑因素如下: 检查WHERE条件和连接条件列: 使用窄索引: 检查列的选择性: 检查列的数据类型: 考虑列顺序: 考虑索引类型(聚集索引OR非聚集索引): 一.检查 ...
随机推荐
- Qt编程之转换成8,16bit的灰度图
代码大致是下面这样的.是8bit的灰度图,不是16bit. QString img_path = "C:\\Users\\Yajun Dou\\Desktop\\test.bmp" ...
- find详解
一.简介 在目录结构中搜索文件,并执行指定的操作. 二.语法 find path -option [ -print ] [ -exec -ok command ] {} \;path: find命令所 ...
- EBS查询用户客户化的文件配置
select pro.profile_option_name, pro.user_profile_option_name, lev.level_type type, --lev.level_code, ...
- 如何判断是REQUEST请求是来自移动终端还是来自PC端
public bool IsMoblie() { string agent = (Request.UserAgent + "").ToLower ...
- Maven自定义Archetype
Maven提供了archetype帮助我们快速构建项目骨架,很便捷.但是,中央仓库中的archetype版本过于陈旧,构建好项目后,需要修改很多信息,甚是麻烦,那么如何自定义个archetype就显得 ...
- 关于C++中覆盖,重载,隐藏的一点说明
C++覆盖 重载 隐藏是三个经常容易混淆的概念 这里我们简单总结下: 1.重载的条件(编译时多态) a.同一个类中 b.函数名相同,参数不同(返回值不能作为重载的条件) c.与函数是否为虚函数无关 2 ...
- 7款纯CSS3实现的炫酷动画应用|慕课网只学有用的!
关于我们 | 时尚廊 ♦ 时尚廊,中国大陆地区首家以"Lounge"为概念的艺文空间 ♦ 7款纯CSS3实现的炫酷动画应用|慕课网只学有用的! 7款纯CSS3实现的炫酷动画应用
- SqlServer经典函数之数字去零
需求: 针对带有小数点的数字信息,去除小数点后多余的零 可能存在的情况: 1.精度范围内,出现多余的零 eg:1234.3400 想要的结果为1234.34 2.精度变大出现的多余的零, ...
- poj 2096 Collecting Bugs(期望 dp 概率 推导 分类讨论)
Description Ivan is fond of collecting. Unlike other people who collect post stamps, coins or other ...
- 关于MemoryBarrier
备注:OSG OpenThread::Atomic.cpp中MemoryBarrier(); Atomic::operator unsigned() const { #if defined(_OPE ...