
数据分析-Numpy-Pandas
补充上一篇未完待续的Numpy知识点
索引和切片
数组和标量(数字)之间运算
li1 = [

    [1,2,3],

    [4,5,6]

]

a = np.array(li1)

a * 2

运行结果:

array([[ 2,  4,  6],

       [ 8, 10, 12]])
索引
# 将一维数组变成二维数组

arr = np.arange(30).reshape(5,6) # 后面的参数6可以改为-1,相当于占位符,系统可以自动帮忙算几列

arr

# 将二维变一维

arr.reshape(30)

# 索引使用方法

array([[ 0,  1,  2,  3,  4,  5],

       [ 6,  7,  8,  9, 10, 11],

       [12, 13, 14, 15, 16, 17],

       [18, 19, 20, 21, 22, 23],

       [24, 25, 26, 27, 28, 29]])

现在有这样一组数据,需求:找到20

列表写法:arr[3][2]

数组写法:arr[3,2]  # 中间通过逗号隔开就可以了

切片
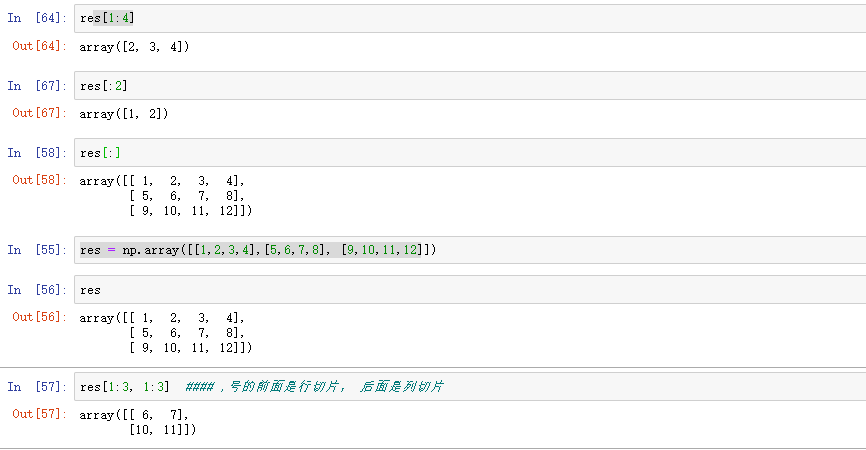
# 多维数组的切片

arr数组

array([[ 0,  1,  2,  3,  4,  5],

       [ 6,  7,  8,  9, 10, 11],

       [12, 13, 14, 15, 16, 17],

       [18, 19, 20, 21, 22, 23],

       [24, 25, 26, 27, 28, 29]])

arr[1:4,1:4]   # 切片方式 行和列

执行结果:

array([[ 7,  8,  9],

       [13, 14, 15],

       [19, 20, 21]])
布尔型索引
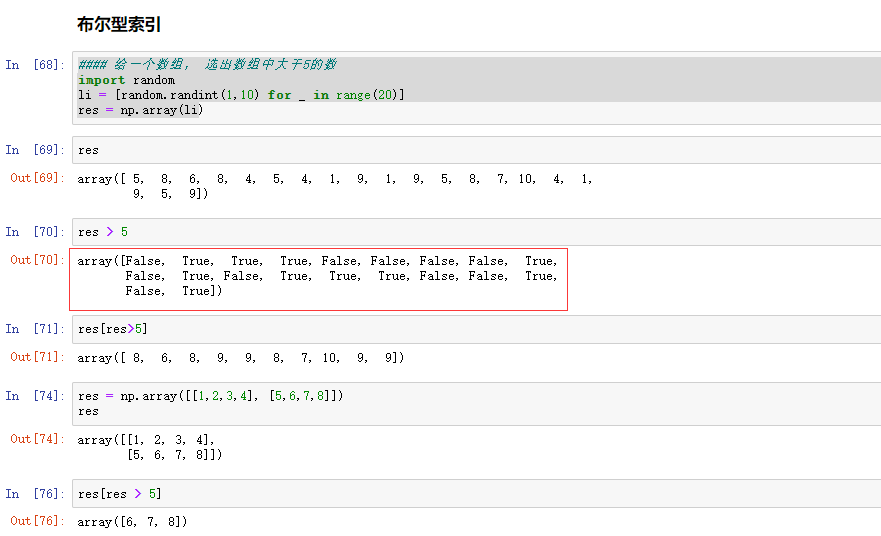
# 现在有这样一个需求:给一个数组,选出数组种所有大于5的数。

li = [random.randint(1,10) for _ in range(30)]

a = np.array(li)

a[a>5]

执行结果:

array([10,  7,  7,  9,  7,  9, 10,  9,  6,  8,  7,  6])

----------------------------------------------

原理:

a>5会对a中的每一个元素进行判断,返回一个布尔数组

a > 5的运行结果:

array([False,  True, False,  True,  True, False,  True, False, False,

       False, False, False, False, False, False,  True, False,  True,

       False, False,  True,  True,  True,  True,  True, False, False,

       False, False,  True])

----------------------------------------------

布尔型索引:将同样大小的布尔数组传进索引,会返回一个有True对应位置的元素的数组
花式索引

通用函数
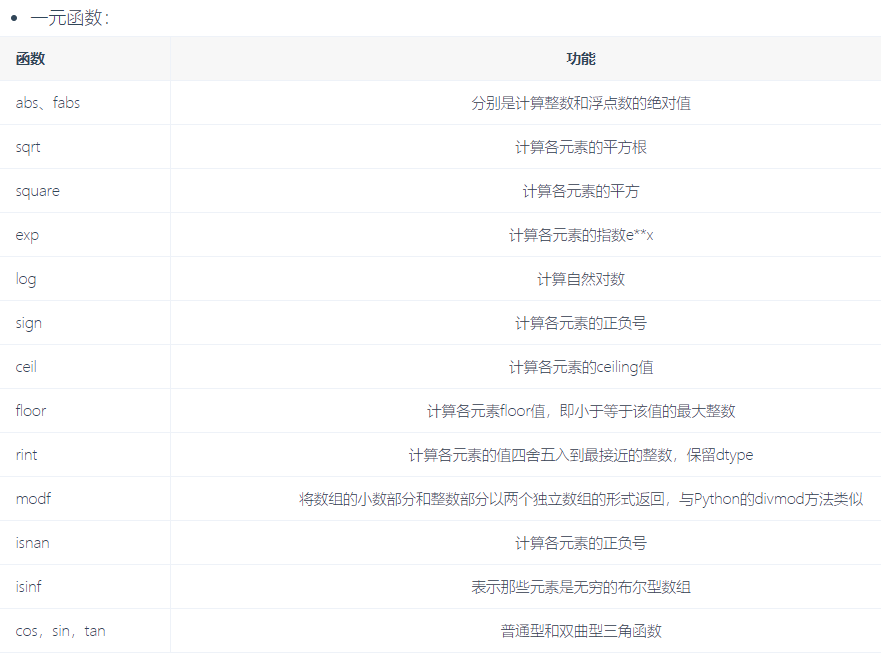
能对数组中所有元素同时进行运算的函数就是通用函数。类似python里的math模块
常见通用函数:
能够接受一个数组的叫做一元函数,接受两个数组的叫二元函数,结果返回的也是一个数组
常用的方式示例:
# 求绝对值

np.abs(-2)

2

np.abs([-2,-4,-5,-10])

array([ 2,  4,  5, 10])

# 浮点型的绝对值

np.fabs([-1.3,-2.5,-3.4])

array([1.3, 2.5, 3.4])

#平方根

np.sqrt(4)

2.0

np.sqrt(2)  # 求平方根

1.4142135623730951

np.square(2)  # 求平方

4

np.exp(2)  # e**2

7.38905609893065

np.log(2)

0.6931471805599453

np.ceil(5.4)  #### 向上取整

6.0

# 向下取整

np.floor(4.6)

4.0

np.rint(3.5)

4.0

np.rint(3.2)

3.0

# 小数部分和整数部分别返回

np.modf([1.2,3.5])

(array([0.2, 0.5]), array([1., 3.]))

##nan === not a number

np.nan

nan

np.nan == np.nan

False

np.isnan(56)

False

np.isnan(np.nan)

True

#求和

np.sum([1,2,3,4,5])

15

np.cumsum?

li = [1,2,3,4,5]

### 方差: ((1-平均数)**2 + (2-平均数)**2 + ....) / 5

### 标准差: 方差开根号

res = np.array(li)

np.max(res)

5

np.argmax(res)

4

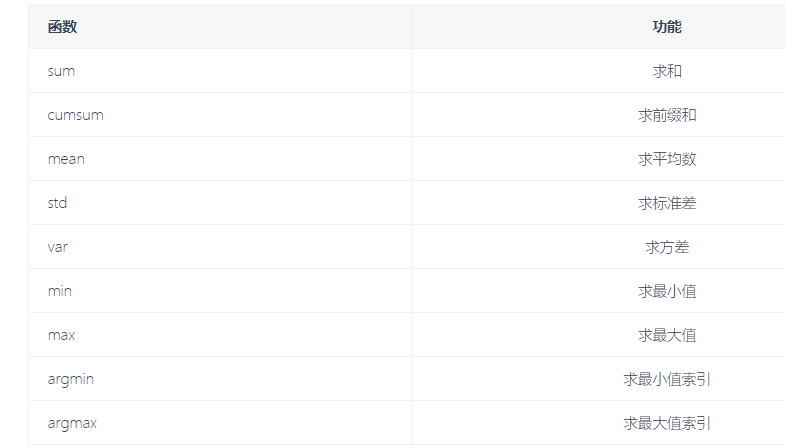
数学统计方法

随机数
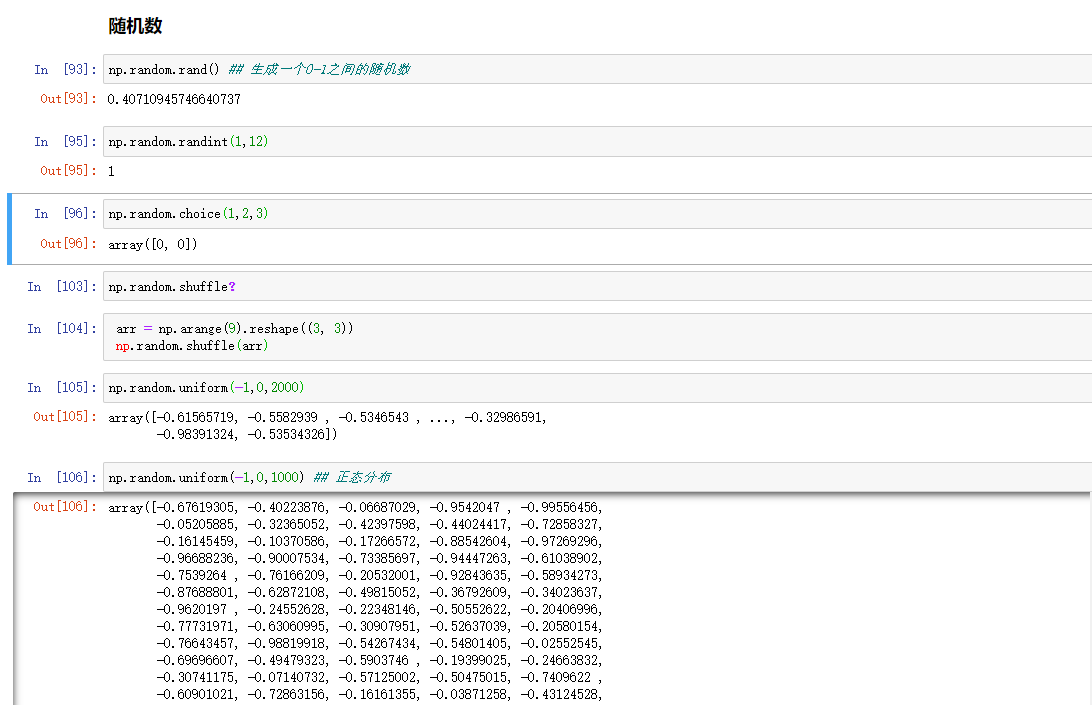
随机数生成函数在np.random的子包当中。

Pandas
简介

Series

DataFrame

时间对象处理

数据分组和聚合

其他常用方法
1、简介
pandas是一个强大的Python数据分析的工具包,它是基于Numpy构建的,正因pandas的出现,让Python语言也成为使用最广泛而且强大的数据分析环境之一。
Pandas的主要功能:
1、具备对其功能的数据结构DataFrame,Series

2、集成时间序列功能

3、提供丰富的数学运算和操作

4、灵活处理缺失数据
安装方法:
# pip3 install pandas
引用方法
# import pandas as pd
导包问题:pyc文件,简单的理解是第一次导入模块或包时,先加载生成pyc文件,后续导入加载读取的速度快些。

Series
Series是一种类似于一维数组的对象,由一组数据和一组与之相关的数据标签(索引)组成。
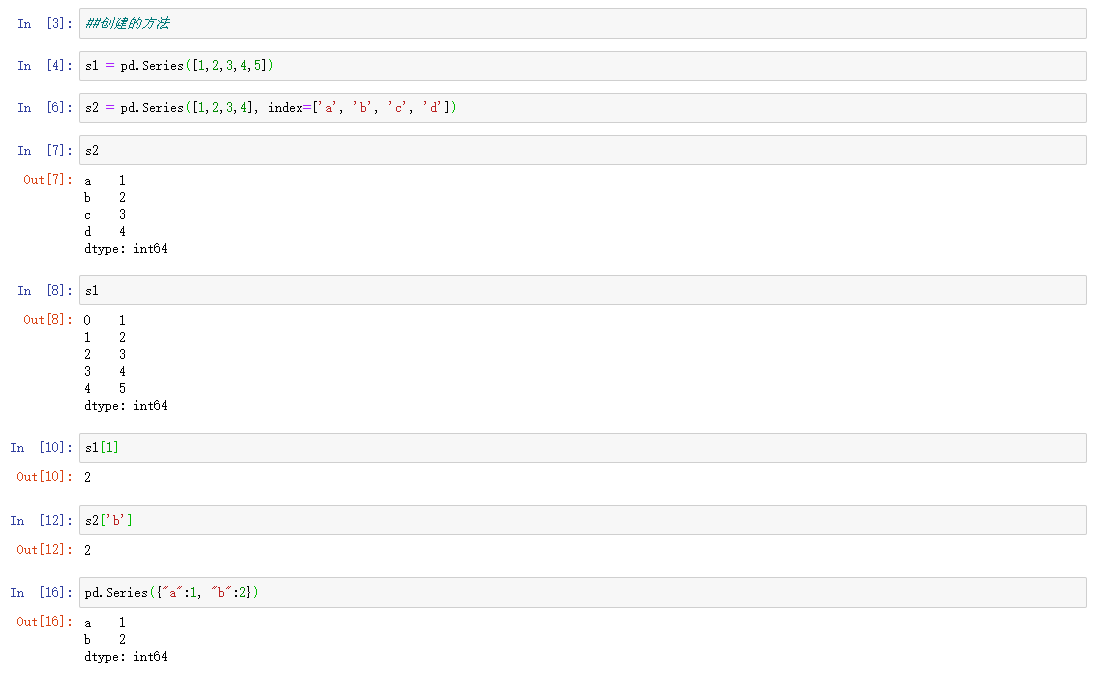
1、创建方法
(1)第一种
pd.Series([4,5,6,7,8])

执行结果:

0    4

1    5

2    6

3    7

4    8

dtype: int64
(2)第二种
pd.Series([4,5,6,7,8],index=['a','b','c','d','e'])

执行结果:

a    4

b    5

c    6

d    7

e    8

dtype: int64
# 自定义索引,index是一个索引列表,里面包含的是字符串,依然可以通过默认索引取值。
(3)第三种
pd.Series({"a":1,"b":2})

执行结果:

a    1

b    2

dtype: int64

# 指定索引
(4)第四种
pd.Series(0,index=['a','b','c'])

执行结果:

a    0

b    0

c    0

dtype: int64

# 创建一个值都是0的数组
对于Series,其实我们可以认为它是一个长度固定且有序的字典,因为它的索引和数据是按位置进行匹配的,像我们会使用字典的上下文,就肯定也会使用Series
缺失数据
一般从网上或其他渠道获取的数据,量大的时候难免都会有数据不完善,缺失的情况出现。
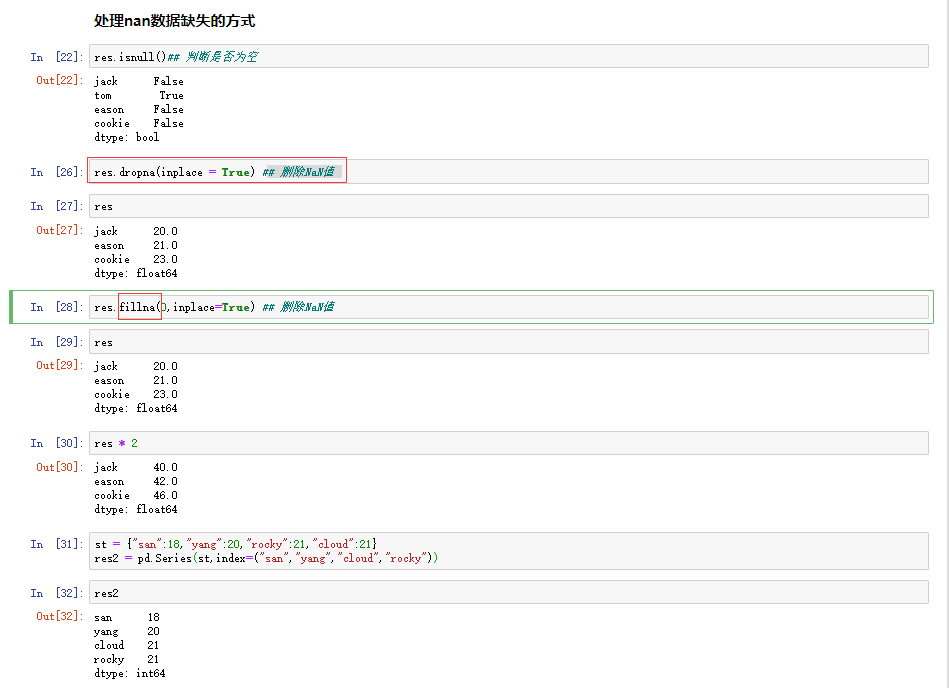
方法:
dropna() # 过滤掉值为NaN的行

fill() # 填充缺失数据

isnull() # 返回布尔数组,缺失值对应为True

notnull() # 返回布尔数组,缺失值对应为False
# 第一步,创建一个字典,通过Series方式创建一个Series对象

st = {"sean":18,"yang":19,"bella":20,"cloud":21}

obj = pd.Series(st)

obj

运行结果:

sean     18

yang     19

bella    20

cloud    21

dtype: int64
# 第二步

a = {'sean','yang','cloud','rocky'}  # 定义一个索引变量
#第三步

obj1 = pd.Series(st,index=a)

obj1  # 将第二步定义的a变量作为索引传入

# 运行结果:

rocky     NaN

cloud    21.0

sean     18.0

yang     19.0

dtype: float64

# 因为rocky没有出现在st的键中,所以返回的是缺失值
通过上面的代码演示,对于缺失值已经有了一个简单的了解,接下来就来看看如何判断缺失值
1、

obj1.isnull()  # 是缺失值返回Ture

运行结果:

rocky     True

cloud    False

sean     False

yang     False

dtype: bool

2、

obj1.notnull()  # 不是缺失值返回Ture

运行结果:

rocky    False

cloud     True

sean      True

yang      True

dtype: bool

3、过滤缺失值 # 布尔型索引

obj1[obj1.notnull()]

运行结果:

cloud    21.0

yang     19.0

sean     18.0

dtype: float64

Series特性
(1)、从ndarray创建Series:Series(arr)

(2)、与标量(数字):sr * 2

(3)、两个Series运算

(4)、通用函数:np.ads(sr)

(5)、布尔值过滤:sr[sr>0]

(6)、统计函数:mean()、sum()、cumsum()
支持字典的特性:
"""

从字典创建Series:Series(dic),

In运算:'a'in sr、for x in sr

键索引:sr['a'],sr[['a','b','d']]

键切片:sr['a':'c']

其他函数:get('a',default=0)等

"""
整数索引
sr = pd.Series(np.arange(10))

sr1 = sr[3:].copy()

sr1

运行结果:

3    3

4    4

5    5

6    6

7    7

8    8

9    9

dtype: int32
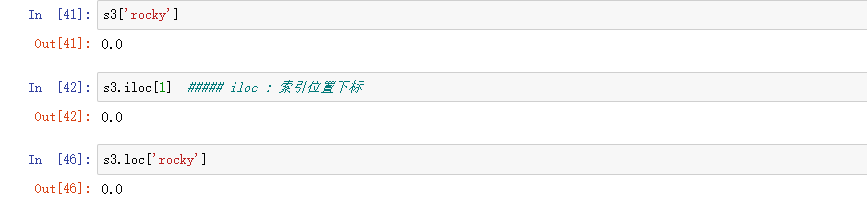
两种取值的方式:
loc属性 # 以标签解释

iloc属性 # 以下标解释
Series数据对齐
pandas在运算时,会按索引进行对齐然后计算。如果存在不同的索引,则结果的索引是两个操作数索引的并集。
sr1 = pd.Series([12,23,34], index=['c','a','d'])

sr2 = pd.Series([11,20,10], index=['d','c','a',])

sr1 + sr2

运行结果:

a    33

c    32

d    45

dtype: int64

# 可以通过这种索引对齐直接将两个Series对象进行运算

DataFrame
DataFrame是一个表格型的数据结构,相当于是一个二维数组,含有一组有序的列。他可以被看做是由Series组成的字典,并且共用一个索引。
创建方式:
创建一个DataFrame数组可以有多种方式,其中最为常用的方式就是利用包含等长度列表或Numpy数组的字典来形成DataFrame:
第一种:
pd.DataFrame({'one':[1,2,3,4],'two':[4,3,2,1]})

# 产生的DataFrame会自动为Series分配所索引,并且列会按照排序的顺序排列

运行结果:

    one two

0   1   4

1   2   3

2   3   2

3   4   1
> 指定列
可以通过columns参数指定顺序排列

data = pd.DataFrame({'one':[1,2,3,4],'two':[4,3,2,1]})

pd.DataFrame(data,columns=['one','two'])

# 打印结果会按照columns参数指定顺序
第二种:
pd.DataFrame({'one':pd.Series([1,2,3],index=['a','b','c']),'two':pd.Series([1,2,3],index=['b','a','c'])})

运行结果:

   one  two

a   1   2

b   2   1

c   3   3

查看数据
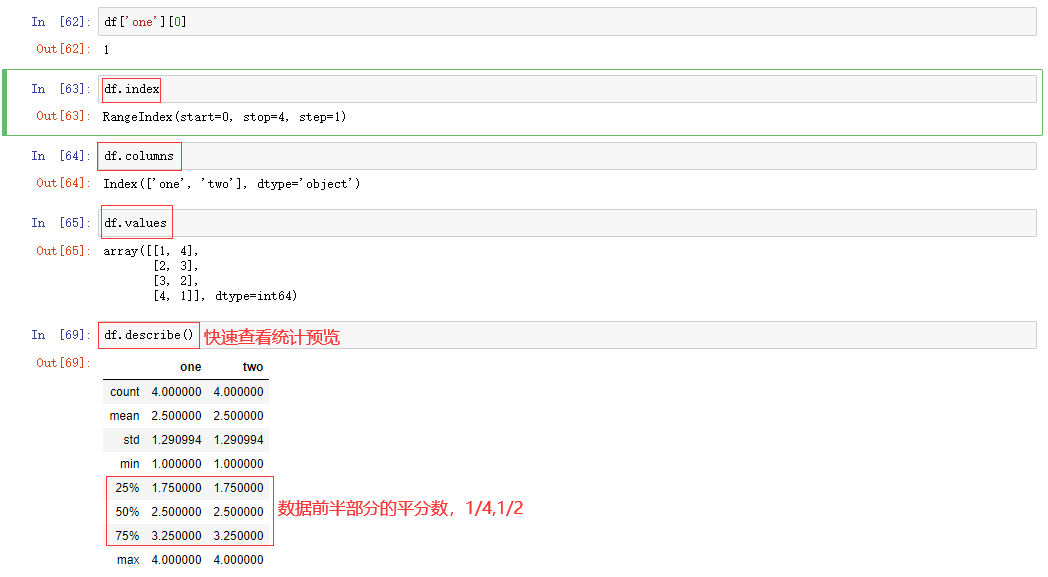
#常用属性和方法:

    index 获取行索引

    columns 获取列索引

    T 转置

    columns 获取列索引

    values 获取值索引

    describe 获取快速统计
 one    two

a   1   2

b   2   1

c   3   3

# 这样一个数组df
df.index

运行结果:

Index(['a', 'b', 'c'], dtype='object')
df.columns

运行结果:

Index(['one', 'two'], dtype='object')
df.describe()

运行结果:

one two

count   3.0 3.0

mean    2.0 2.0

std 1.0 1.0

min 1.0 1.0

25% 1.5 1.5

50% 2.0 2.0

75% 2.5 2.5

max 3.0 3.0
常见的获取数据的方式
例如从execl中把数据读出来:
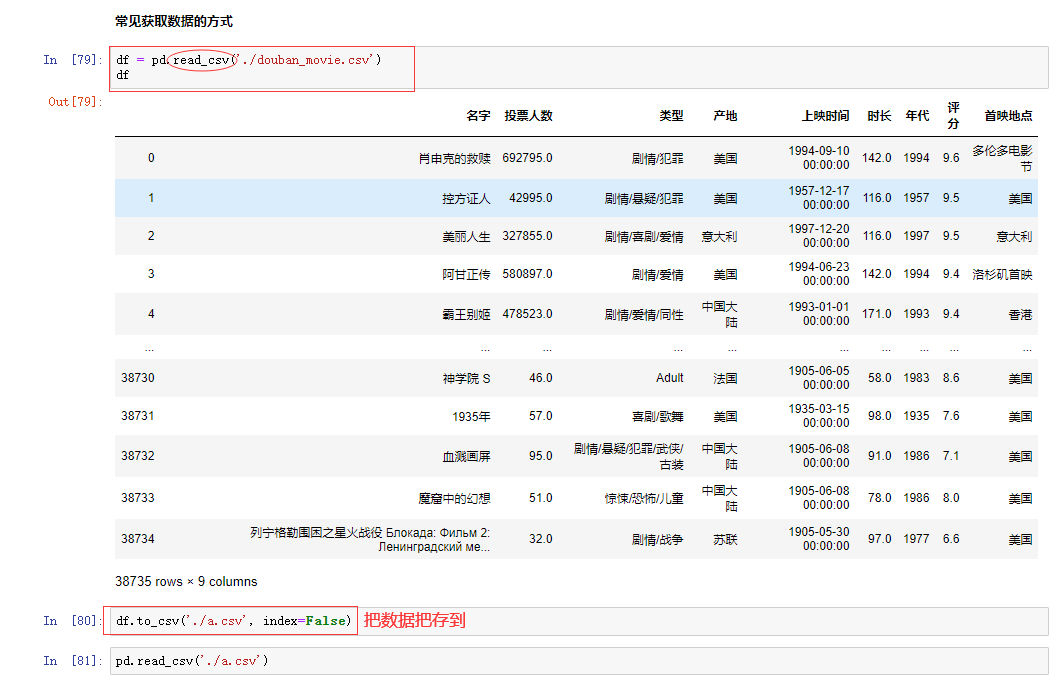
# df.head() 显示前5条数据 可以传数字,代表显示的条数

# df.tail() 显示后面的6条数据

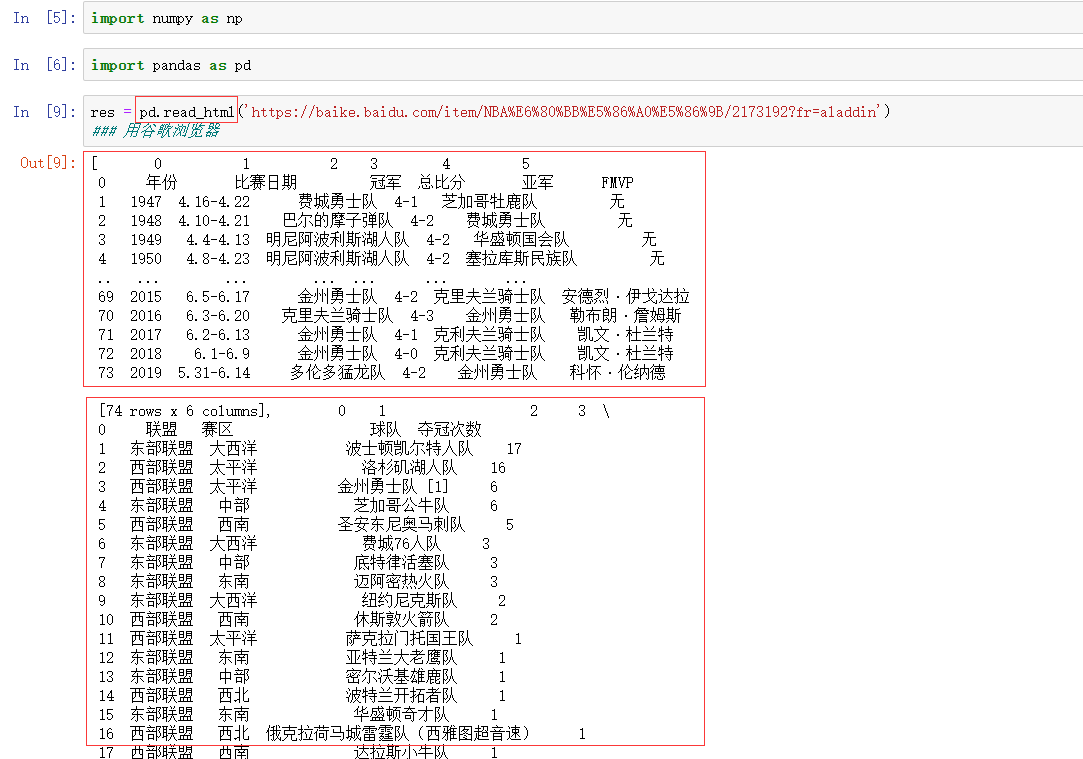
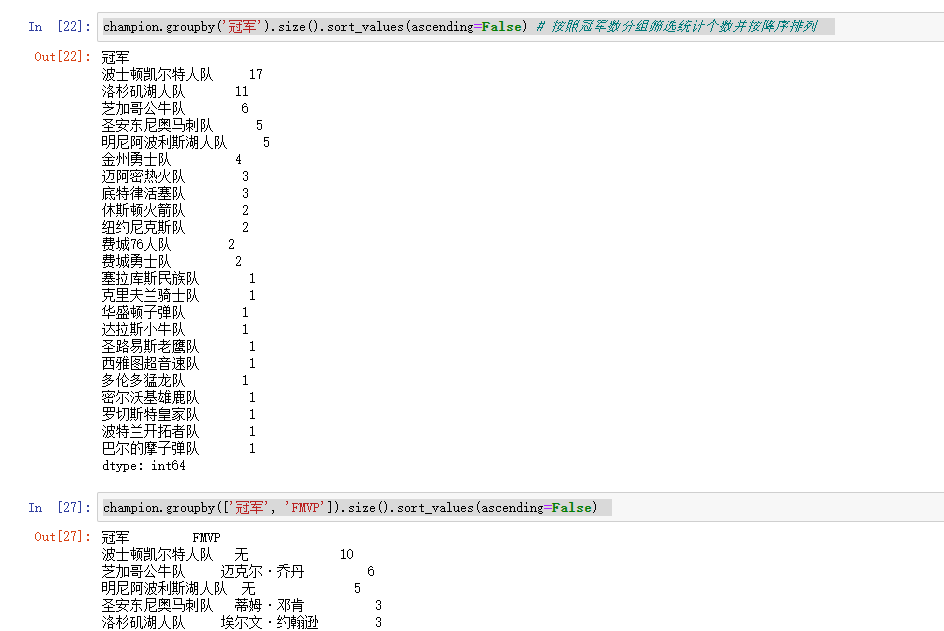
作业:获取NBA历年的总冠军数
# 用到的是pandas模块里的一些方法:

    res = pd.read_html(“url”) # 读取页面的表格数据,建议用哦用谷歌浏览器打开网页并粘贴url连接。

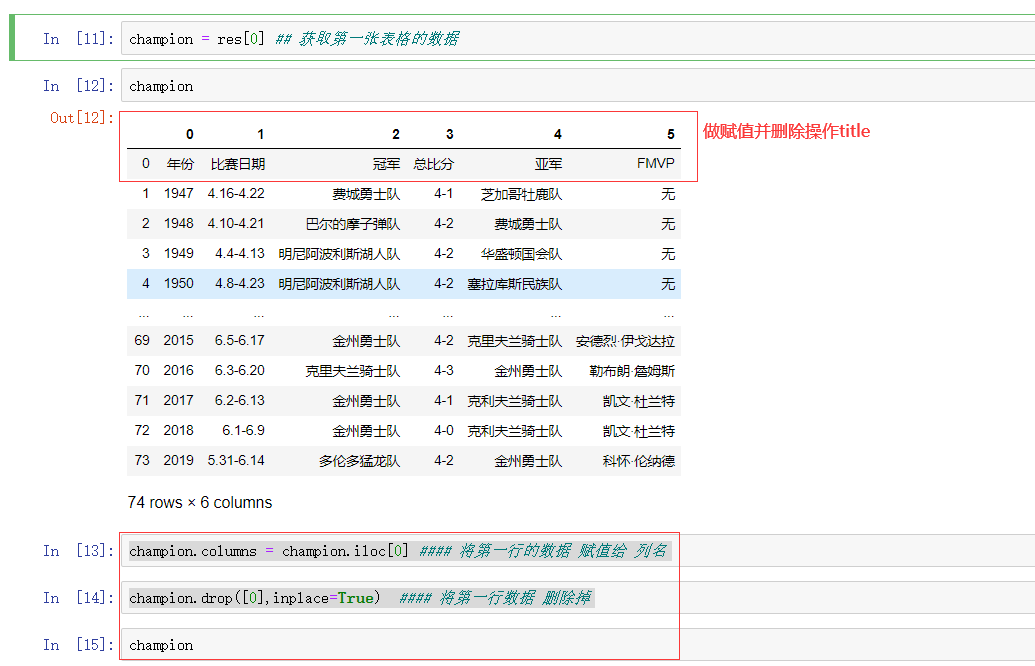
    champion =  res [0]   # 获取第一张表格的数据

    champion.columns = champion.iloc[0] #### 将第一行的数据 赋值给 列名

    champion.drop([0],inplace=True)  #### 将第一行数据 删除掉

    champion.groupby('冠军').groups

    champion.groupby('冠军').size().sort_values(ascending=False) # 按照冠军数分组筛选统计个数并按降序排列

    champion.groupby(['冠军', 'FMVP']).size().sort_values(ascending=False) # 获取球星FMVP数量并排序。
索引和切片
- DataFrame有行索引和列索引。
- DataFrame同样可以通过标签和位置两种方法进行索引和切片。
DataFrame使用索引切片:
- 方法1:两个中括号,先取列再取行。 df['A'][0]
- 方法2(推荐):使用loc/iloc属性,一个中括号,逗号隔开,先取行再取列。
- loc属性:解释为标签
- iloc属性:解释为下标
- 向DataFrame对象中写入值时只使用方法2
- 行/列索引部分可以是常规索引、切片、布尔值索引、花式索引任意搭配。(注意:两部分都是花式索引时结果可能与预料的不同)
时间对象处理
时间序列类型
(1)时间戳:特定时刻

(2)固定时期:如2019年1月

(3)时间间隔:起始时间-结束时间
Python库:datatime
"""

date、time、datetime、timedelta

dt.strftime()

strptime()

"""
灵活处理时间对象:dateutil包
dateutil.parser.parse()

Copy

import dateutil

dateutil.parser.parse("2019 Jan 2nd")  # 这中间的时间格式一定要是英文格式

运行结果:

datetime.datetime(2019, 1, 2, 0, 0)
成组处理时间对象:pandas
pd.to_datetime(['2018-01-01', '2019-02-02'])

Copy

pd.to_datetime(['2018-03-01','2019 Feb 3','08/12-/019'])

运行结果:

DatetimeIndex(['2018-03-01', '2019-02-03', '2019-08-12'], dtype='datetime64[ns]', freq=None)  # 产生一个DatetimeIndex对象
# 转换时间索引

ind = pd.to_datetime(['2018-03-01','2019 Feb 3','08/12-/019'])

sr = pd.Series([1,2,3],index=ind)

sr

运行结果:

2018-03-01    1

2019-02-03    2

2019-08-12    3

dtype: int64

通过以上方式就可以将索引转换为时间
产生时间对象数组:data_range
start 开始时间

end 结束时间

periods 时间长度

freq 时间频率,默认为'D',可选H(our),W(eek),B(usiness),S(emi-)M(onth),(min)T(es), S(econd), A(year),…
pd.date_range("2019-1-1","2019-2-2")

运行结果:

DatetimeIndex(['2019-01-01', '2019-01-02', '2019-01-03', '2019-01-04',

               '2019-01-05', '2019-01-06', '2019-01-07', '2019-01-08',

               '2019-01-09', '2019-01-10', '2019-01-11', '2019-01-12',

               '2019-01-13', '2019-01-14', '2019-01-15', '2019-01-16',

               '2019-01-17', '2019-01-18', '2019-01-19', '2019-01-20',

               '2019-01-21', '2019-01-22', '2019-01-23', '2019-01-24',

               '2019-01-25', '2019-01-26', '2019-01-27', '2019-01-28',

               '2019-01-29', '2019-01-30', '2019-01-31', '2019-02-01',

               '2019-02-02'],

              dtype='datetime64[ns]', freq='D')
时间序列
时间序列就是以时间对象为索引的Series或DataFrame。datetime对象作为索引时是存储在DatetimeIndex对象中的。
# 转换时间索引

dt = pd.date_range("2019-01-01","2019-02-02")

a = pd.DataFrame({"num":pd.Series(random.randint(-100,100) for _ in range(30)),"date":dt})

# 先生成一个带有时间数据的DataFrame数组

a.index = pd.to_datetime(a["date"])

# 再通过index修改索引
特殊功能:
传入“年”或“年月”作为切片方式

传入日期范围作为切片方式

丰富的函数支持:resample(), strftime(), ……

批量转换为datetime对象:to_pydatetime()

a.resample("3D").mean()  # 计算每三天的均值

a.resample("3D").sum()  #  计算每三天的和

...
数据分组和聚合
分组(GroupBY机制)

聚合(组内应用某个函数)

apply

透视表和交叉表
聚合(组内应用某个函数)
聚合是指任何能够从数组产生标量值的数据转换过程。刚才上面的操作会发现使用GroupBy并不会直接得到一个显性的结果
,而是一个中间数据,可以通过执行类似mean、count、min等计算得出结果,常见的还有一些
apply
GroupBy当中自由度最高的方法就是apply,它会将待处理的对象拆分为多个片段,然后各个片段分别调用传入的函数,最后将它们组合到一起。
df.apply(

['func', 'axis=0', 'broadcast=None', 'raw=False', 'reduce=None', 'result_type=None', 'args=()', '**kwds']

func:传入一个自定义函数

axis:函数传入参数当axis=1就会把一行数据作为Series的数据
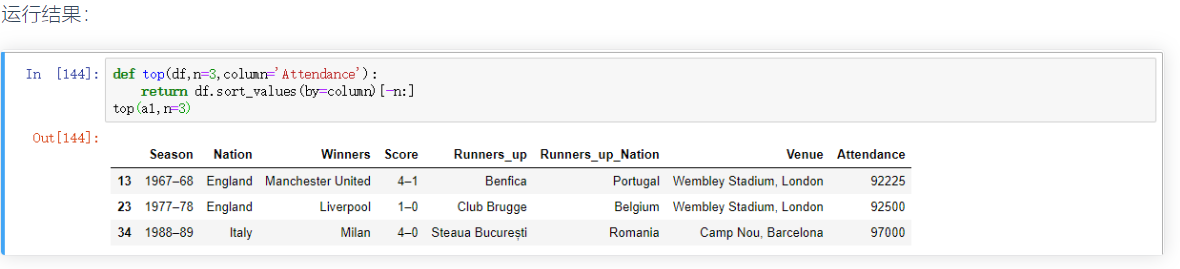
# 分析欧洲杯和欧洲冠军联赛决赛名单

import pandas as pd

url="https://en.wikipedia.org/wiki/List_of_European_Cup_and_UEFA_Champions_League_finals"

eu_champions=pd.read_html(url)  # 获取数据

a1 = eu_champions[2]    # 取出决赛名单

a1.columns = a1.loc[0]  # 使用第一行的数据替换默认的横向索引

a1.drop(0,inplace=True)  # 将第一行的数据删除

a1.drop('#',axis=1,inplace=True)  # 将以#为列名的那一列删除

a1.columns=['Season', 'Nation', 'Winners', 'Score', 'Runners_up', 'Runners_up_Nation', 'Venue','Attendance']  # 设置列名

a1.tail()  # 查看后五行数据

a1.drop([64,65],inplace=True)  # 删除其中的缺失行以及无用行

a1
其他常用方法
pandas常用方法(适用Series和DataFrame)

mean(axis=0,skipna=False)

sum(axis=1) # x

sort_index(axis, …, ascending) # 按行或列索引排序

sort_values(by, axis, ascending) # 按值排序

apply(func, axis=0) # 将自定义函数应用在各行或者各列上,func可返回标量或者Series

applymap(func) # 将函数应用在DataFrame各个元素上

map(func) # 将函数应用在Series各个元素上
数据分析-Numpy-Pandas的更多相关文章
- 数据分析——Numpy/pandas
NumPy NumPy是高性能科学计算和数据分析的基础包.部分功能如下: ndarray, 具有矢量算术运算和复杂广播能力的快速且节省空间的多维数组. 用于对整组数据进行快速运算的标准数学函数(无需编 ...
- python 数据分析工具之 numpy pandas matplotlib
作为一个网络技术人员,机器学习是一种很有必要学习的技术,在这个数据爆炸的时代更是如此. python做数据分析,最常用以下几个库 numpy pandas matplotlib 一.Numpy库 为了 ...
- 利用Python进行数据分析(7) pandas基础: Series和DataFrame的简单介绍
一.pandas 是什么 pandas 是基于 NumPy 的一个 Python 数据分析包,主要目的是为了数据分析.它提供了大量高级的数据结构和对数据处理的方法. pandas 有两个主要的数据结构 ...
- Ipython自动导入Numpy,pandas等模块
一.引言 最近在学习numpy,书上要求安装一个Ipythpn,可以自动导入Numpy,pandas等数据分析的模块,可是当我安装后,并不能自动导入numpy模块,还需要自己import.我就去查了一 ...
- Python数据分析库pandas基本操作
Python数据分析库pandas基本操作2017年02月20日 17:09:06 birdlove1987 阅读数:22631 标签: python 数据分析 pandas 更多 个人分类: Pyt ...
- Python数据分析-Numpy数值计算
Numpy介绍: NumPy是高性能科学计算和数据分析的基础包.它是pandas等其他各种工具的基础. NumPy的主要功能: 1)ndarray,一个多维数组结构,高效且节省空间 2)无需循环对整组 ...
- Python数据分析之pandas基本数据结构:Series、DataFrame
1引言 本文总结Pandas中两种常用的数据类型: (1)Series是一种一维的带标签数组对象. (2)DataFrame,二维,Series容器 2 Series数组 2.1 Series数组构成 ...
- 数据分析--numpy的基本使用
一.numpy概述 NumPy是高性能科学计算和数据分析的基础包.它是pandas等其他各种工具的基础. NumPy的主要功能: ndarray,一个多维数组结构,高效且节省空间 无需循环对整组数据进 ...
- linux下安装numpy,pandas,scipy,matplotlib,scikit-learn
python在数据科学方面需要用到的库: a.Numpy:科学计算库.提供矩阵运算的库. b.Pandas:数据分析处理库 c.scipy:数值计算库.提供数值积分和常微分方程组求解算法.提供了一个非 ...
- 数据分析-numpy的用法
一.jupyter notebook 两种安装和启动的方式: 第一种方式: 命令行安装:pip install jupyter 启动:cmd 中输入 jupyter notebook 缺点:必须手动去 ...
随机推荐
- Spark笔记(一)
简介 Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎.Spark是UC Berkeley AMP lab (加州大学伯克利分校的AMP实验室)所开源的类Hadoop MapR ...
- Node.js 文件系统模块
章节 Node.js 介绍 Node.js 入门 Node.js 模块 Node.js HTTP模块 Node.js 文件系统模块 Node.js URL模块 Node.js NPM Node.js ...
- mp4流化
MP4需要流化 不然会频繁seek 对于http形式的播放而言 苦不堪言 ffmpeg -i g:/media/err.mp4 -movflags +faststart -codec copy g:/ ...
- Webpack - 把json文件打包进js文件
把html文件打包进index.js 1 新建文件 typings.d.ts declare module "*.html" { const content: st ...
- html使用aes进行加密
1.导入 aes.js 文件 !function(t,n){*t.length},toString:function(t){);o<r;o++){]>>>-o%*&;n ...
- 量化投资_Multicharts数组操作函数_append()追加函数(自定义)
1. Multicharts中关于数组的操作比较麻烦,而且当中所谓的动态数组的定义并不是像其他语言那种的概念.因此要对数组进行元素“”追加“”的话,需要重新更改数组的索引,然后再最后一个位置添加val ...
- UVALive 6763 / CSU 1446
今天比赛的时候拿到的第一道题,其实挺简单的,求两等差序列中相同元素的个数,我想了一下就觉得,只要找到了第一个相等的点,然后后面求最大公约数就可以直接得到结果了 网上叫什么拓展欧几里得,我反正是按照我们 ...
- idea中maven下载jar包不完整问题
解决: 1.输入 mvn -U idea:idea 等1.都下载完毕后,在点击2.即Reimport
- LeetCode刷题笔记(1-9)
LeetCode1-9 本文更多是作为一个习题笔记,没有太多讲解 1.两数之和 题目请点击链接 ↑ 最先想到暴力解法,直接双循环,但是这样复杂度为n平方 public int[] twoSum(int ...
- promise 核心 几个小问题
1.如何改变pending的壮体 抛出异常.pending变为rejected // throw new Error('fail') 内部抛出异常也这样 reason为抛出的error resol ...