
2017.11.15 hashmap的工作原理
参考来自:http://blog.csdn.net/jeffleo/article/details/54946424
一 hashMap的基本概念
1.HashMap的定义
public class HashMap<K,V>

    extends AbstractMap<K,V>

    implements Map<K,V>, Cloneable, Serializable
HashMap继承自AbstractMap,AbstractMap是Map接口的骨干实现,AbstractMap中实现了Map中最重要最常用和方法。而在这里仍然实现Map结构,没有什么作用,应该是为了让map的层次结构更加清晰。
2.HashMap的成员变量
    int DEFAULT_INITIAL_CAPACITY = 16:默认的初始容量为16

   int MAXIMUM_CAPACITY = 1 << 30:最大的容量为 2 ^ 30

   float DEFAULT_LOAD_FACTOR = 0.75f:默认的加载因子为 0.75f

   Entry<K,V>[] table:Entry类型的数组,HashMap用这个来维护内部的数据结构,它的长度由容量决定

   int size:HashMap的大小

   int threshold:HashMap的极限容量,扩容临界点(容量和加载因子的乘积)
3.HashMap的构造函数
    public HashMap():构造一个具有默认初始容量 (16) 和默认加载因子 (0.75) 的空 HashMap

   public HashMap(int initialCapacity):构造一个带指定初始容量和默认加载因子 (0.75) 的空 HashMap

   public HashMap(int initialCapacity, float loadFactor):构造一个带指定初始容量和加载因子的空 HashMap

   public HashMap(Map< ? extends K, ? extends V> m):构造一个映射关系与指定 Map 相同的新 HashMap
HashMap 的实例有两个参数影响其性能:初始容量和加载因子。
初始容量:哈希表在创建时的容量,实际上就是Entry< K,V>[] table的容量。
加载因子 :是哈希表在其容量自动增加之前可以达到多满的一种尺度。它衡量的是一个散列表的空间的使用程度,加载因子越大表示散列表的装填程度越高,反之愈小。对于使用链表法的散列表来说,查找一个元素的平均时间是O(1+a),因此如果加载因子越大,对空间的利用更充分,然而后果是查找效率的降低;如果负载因子太小,那么散列表的数据将过于稀疏,对空间造成严重浪费。系统默认负载因子为0.75,一般情况下我们是无需修改的。
当哈希表中的条目数超出了加载因子与当前容量的乘积时,则要对该哈希表进行 rehash 操作(即重建内部数据结构),从而哈希表将具有大约两倍的桶数。
二 HashMap的数据结构
1. 数据结构的图示
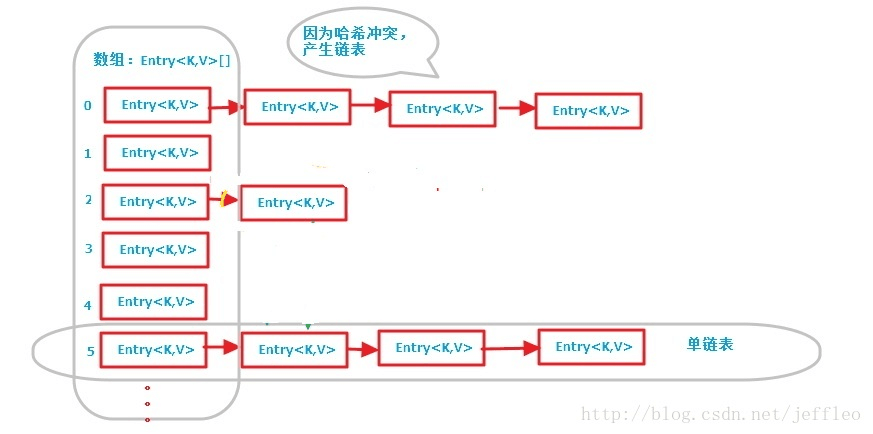
从上图我们可以看出HashMap底层实现还是数组,只是数组的每一项都是一条链。其中参数initialCapacity就代表了该数组的长度。
2.HashMap构造函数的源码
 public HashMap(int initialCapacity, float loadFactor) {

         //容量不能小于0

         if (initialCapacity < 0)

             throw new IllegalArgumentException("Illegal initial capacity: " +                                           initialCapacity);

         //容量不能超出最大容量

         if (initialCapacity > MAXIMUM_CAPACITY)

             initialCapacity = MAXIMUM_CAPACITY;

         //加载因子不能<=0 或者 为非数字

         if (loadFactor <= 0 || Float.isNaN(loadFactor))

             throw new IllegalArgumentException("Illegal load factor: " +

                                                loadFactor);

         //计算出大于初始容量的最小2的n次方作为哈希表table的长度,下面会说明为什么要这样

         int capacity = 1;

         while (capacity < initialCapacity)

             capacity <<= 1;

         this.loadFactor = loadFactor;

         //设置HashMap的容量极限,当HashMap的容量达到该极限时就会进行扩容操作

         threshold = (int)Math.min(capacity * loadFactor, MAXIMUM_CAPACITY + 1);

         //创建Entry数组

         table = new Entry[capacity];

         useAltHashing = sun.misc.VM.isBooted() &&

                 (capacity >= Holder.ALTERNATIVE_HASHING_THRESHOLD);

         init();

     }
可以看到,这个构造函数主要做的事情就是:
 对传入的容量和加载因子进行判断处理

 设置HashMap的容量极限

 计算出大于初始容量的最小2的n次方作为哈希表table的长度,然后用该长度创建Entry数组(table),这个是最核心的。
这里用到了Entry数组。
Entry是HashMap的一个内部类,它也是维护着一个key-value映射关系,除了key和value,还有next引用(该引用指向当前table位置的链表),hash值(用来确定每一个Entry链表在table中位置)。
Entry的内部实现如下:
     static class Entry<K,V> implements Map.Entry<K,V> {

         final K key;

         V value;

         Entry<K,V> next;

         int hash;

         /**

          * Creates new entry.

          */

         Entry(int h, K k, V v, Entry<K,V> n) {

             value = v;

             next = n;

             key = k;

             hash = h;

         }

     }
三 HashMap的存储实现put(k,v)
1.过程概述
 传入key和value,判断key是否为null,如果为null,则调用putForNullKey,以null作为key存储到哈希表中;

 然后计算key的hash值,根据hash值搜索在哈希表table中的索引位置。
3 若当前索引位置不为null,则对该位置的Entry链表进行遍历。
  如果链中存在该key,则用传入的value覆盖掉旧的value,同时把旧的value返回,结束;

 否则调用addEntry,用key-value创建一个新的节点,并把该节点插入到该索引对应的链表的头部。
2.源码解读
     public V put(K key, V value) {

         //如果key为空的情况

         if (key == null)

             return putForNullKey(value);

         //计算key的hash值

         int hash = hash(key);

         //计算该hash值在table中的下标,即计算bucketIndex

         int i = indexFor(hash, table.length);

         //对table[i]存放的链表进行遍历

         for (Entry<K,V> e = table[i]; e != null; e = e.next) {

             Object k;

             //判断该条链上是否有hash值相同的(key相同)

             //若存在相同,则直接覆盖value,返回旧value

             if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {

                 V oldValue = e.value;

                 e.value = value;

                 e.recordAccess(this);

                 return oldValue;

             }

         }

         //修改次数+1

         modCount++;

         //把当前key,value添加到table[i]的链表中

         addEntry(hash, key, value, i);

         return null;

     }

 }
(1) 如果为null,则调用putForNullKey:这就是为什么HashMap可以用null作为键的原因。
      private V putForNullKey(V value) {

         //查找链表中是否有null键

         for (Entry<K,V> e = table[0]; e != null; e = e.next) {

             if (e.key == null) {

                 V oldValue = e.value;

                 e.value = value;

                 e.recordAccess(this);

                 return oldValue;

             }

         }

         modCount++;

         //如果链中查找不到,则把该null键插入

         addEntry(0, null, value, 0);

         return null;

     }
(2)如果链中存在该key,则用传入的value覆盖掉旧的value,同时把旧的value返回:这就是为什么HashMap不能有两个相同的key的原因。
HashMap中,首先计算key的hash值,然后通过hash值获得bucketIndex。
    final int hash(Object k) {

         int h = 0;

         if (useAltHashing) {

             if (k instanceof String) {

                 return sun.misc.Hashing.stringHash32((String) k);

             }

             h = hashSeed;

         }

         h ^= k.hashCode();

         h ^= (h >>> 20) ^ (h >>> 12);

         return h ^ (h >>> 7) ^ (h >>> 4);

     }
     static int indexFor(int h, int length) {

         return h & (length-1);

     }
对于HashMap的table而言,数据分布需要均匀(最好每项都只有一个元素,这样就可以直接找到),不能太紧也不能太松,太紧会导致查询速度慢,太松则浪费空间。计算hash值后,怎么才能保证table元素分布均与呢?
可以采用取模的方式。但是由于取模的消耗较大,HashMap是通过&运算符(按位与操作)来实现的:h & (length-1)。在构造函数中存在:capacity <<= 1,这样做总是能够保证HashMap的底层数组长度为2的n次方。当length为2的n次方时,h&(length - 1)就相当于对length取模,而且速度比直接取模快得多。即等价不等效。
所以说当length = 2^n时,不同的hash值发生碰撞的概率比较小,这样就会使得数据在table数组中分布较均匀,查询速度也较快。
在获得bucketIndex之后,调用addEntry将key-value插入到该索引的联表中。首先取得bucketIndex位置的Entry头结点,并创建新节点,把该新节点插入到链表中的头部,该新节点的next指针指向原来的头结点 。
其中addEntry:
    void addEntry(int hash, K key, V value, int bucketIndex) {

         //如果size大于极限容量,将要进行重建内部数据结构操作,之后的容量是原来的两倍,并且重新设置hash值和hash值在table中的索引值

         if ((size >= threshold) && (null != table[bucketIndex])) {

             resize(2 * table.length);

             hash = (null != key) ? hash(key) : 0;

             bucketIndex = indexFor(hash, table.length);

         }

         //真正创建Entry节点的操作

         createEntry(hash, key, value, bucketIndex);

     }
    void createEntry(int hash, K key, V value, int bucketIndex) {

         Entry<K,V> e = table[bucketIndex];

         table[bucketIndex] = new Entry<>(hash, key, value, e);

         size++;

     }
系统总是将新的Entry对象添加到bucketIndex处。如果bucketIndex处已经有了对象,那么新添加的Entry对象将指向原有的Entry对象,形成一条Entry链,但是若bucketIndex处没有Entry对象,也就是e==null,那么新添加的Entry对象指向null,也就不会产生Entry链了。
(3)扩容问题
threshold是容器的容量极限,size是HashMap中键值对的数量,也就是node的数量。当不断添加key-value,size大于了容量极限threshold时,会发生扩容。扩容发生在resize方法中,也就是扩大数组(桶)的数量,如何扩容参考:http://blog.csdn.net/jeffleo/article/details/63684953
threshold = (int)Math.min(capacity * loadFactor, MAXIMUM_CAPACITY + 1);
四 HashMap的读取实现get(key, value)
1.过程概述
 调用hash(key)求得key的hash值。
2 然后调用indexFor(hash)求得hash值对应的table的索引位置。
3 然后遍历索引位置的链表,如果存在key,则把key对应的Entry返回,否则返回null。
2.源码解读
     public V get(Object key) {

         //如果key为null,求null键

         if (key == null)

             return getForNullKey();

         // 用该key求得entry

         Entry<K,V> entry = getEntry(key);

         return null == entry ? null : entry.getValue();

     }

    final Entry<K,V> getEntry(Object key) {

         int hash = (key == null) ? 0 : hash(key);

         for (Entry<K,V> e = table[indexFor(hash, table.length)]; e != null; e = e.next) {

             Object k;

             if (e.hash == hash &&((k = e.key) == key || (key != null && key.equals(k))))

                 return e;

         }

         return null;

     }
五 HashMap键的遍历
HashMap遍历时,按哈希表的每一个索引的链表从上往下遍历,由于HashMap的存储规则,最晚添加的节点都有可能在第一个索引的链表中,这就造成了HashMap的遍历时无序的。
    private abstract class HashIterator<E> implements Iterator<E> {

         Entry<K,V> next;        // next entry to return

         int expectedModCount;   // For fast-fail

         int index;              // current slot

         Entry<K,V> current;     // current entry

         //当调用keySet().iterator()时,调用此代码

         HashIterator() {

             expectedModCount = modCount;

             if (size > 0) { // advance to first entry

                 Entry[] t = table;

                 //从哈希表数组从上到下,查找第一个不为null的节点,并把next引用指向该节点

                 while (index < t.length && (next = t[index++]) == null);

             }

         }

         public final boolean hasNext() {

             return next != null;

         }

         //当调用next时,会调用此代码

         final Entry<K,V> nextEntry() {

             if (modCount != expectedModCount)

                 throw new ConcurrentModificationException();

             Entry<K,V> e = next;

             if (e == null)

                 throw new NoSuchElementException();

             //如果当前节点的下一个节点为null,从节点处罚往下查找哈希表,找到第一个不为null的节点

             if ((next = e.next) == null) {

                 Entry[] t = table;

                 while (index < t.length && (next = t[index++]) == null);

             }

             current = e;

             return e;

         }

         public void remove() {

             if (current == null)

                 throw new IllegalStateException();

             if (modCount != expectedModCount)

                 throw new ConcurrentModificationException();

             Object k = current.key;

             current = null;

             HashMap.this.removeEntryForKey(k);

             expectedModCount = modCount;

         }

     }
2017.11.15 hashmap的工作原理的更多相关文章
- 从头认识java-15.7 Map(6)-介绍HashMap的工作原理-装载因子与性能
这一章节我们通过讨论装载因子与性能,再来介绍HashMap的工作原理. 1.什么是装载因子?他有什么作用? 以下的代码就是装载因子 /** * The load factor used when no ...
- HashMap的工作原理
HashMap的工作原理 HashMap的工作原理是近年来常见的Java面试题.几乎每个Java程序员都知道HashMap,都知道哪里要用HashMap,知道HashTable和HashMap之间 ...
- HashMap的工作原理深入再深入
前言 首先再次强调hashcode (==)和equals的真正含义(我记得以前有人会说,equals是判断对象内容,hashcode是判断是否相等之类): equals:是否同一个对象实例.注意,是 ...
- [转] HashMap的工作原理
HashMap的工作原理是近年来常见的Java面试题.几乎每个Java程序员都知道HashMap,都知道哪里要用HashMap,知道Hashtable和HashMap之间的区别,那么为何这道面试题如此 ...
- 【转】HashMap的工作原理
很好的文章,推荐Java的一个好网站:ImportNew HashMap的工作原理是近年来常见的Java面试题.几乎每个Java程序员都知道HashMap,都知道哪里要用HashMap,知道Hasht ...
- 转:HashMap的工作原理,及笔记
HashMap的工作原理是近年来常见的Java面试题.几乎每个Java程序员都知道HashMap,都知道哪里要用HashMap,知道Hashtable和HashMap之间的区别,那么为何这道面试题如此 ...
- HashMap的工作原理(转)
HashMap的工作原理是近年来常见的Java面试题.几乎每个Java程序员都知道HashMap,都知道哪里要用HashMap,知道Hashtable和HashMap之间的区别,那么为何这道面试题如此 ...
- 【伯乐在线】HashMap的工作原理
本文由 ImportNew - 唐小娟 翻译自 Javarevisited.欢迎加入翻译小组.转载请见文末要求. HashMap的工作原理是近年来常见的Java面试题.几乎每个Java程序员都知道Ha ...
- 【转】Java学习---HashMap的工作原理
[原文]https://www.toutiao.com/i6592560649652404744/ HashMap的工作原理是近年来常见的Java面试题.几乎每个Java程序员都知道HashMap,都 ...
随机推荐
- Linux服务器中OpenSSH的源码编译与升级
Linux服务器中OpenSSH的源码编译与升级 https://www.oschina.net/question/12_7383
- Quorum一致性协议
Quorum一致性协议 一个分布式数据库系统中通常是一系列密切关联的操作组成完整的系统. 分布式系统最基本的要保证一致性, 分区性通常是无法避免的, 在这种情况下尽力通过软件协议做到最大可用性. 根据 ...
- C#实例:Unity依赖注入使用
http://jingyan.baidu.com/article/c74d6000840b260f6b595d78.html
- DRF的限流功能
限流,可以对接口访问的频次进行限制,以减轻服务器压力. 全局配置 在settings.py上添加 REST_FRAMEWORK = { 'DEFAULT_THROTTLE_CLASSES': ( 'r ...
- Selenium2+python自动化26-js处理内嵌div滚动条【转载】
前言 前面有篇专门用js解决了浏览器滚动条的问题,生活总是多姿多彩,有的滚动条就在页面上,这时候又得仰仗js大哥来解决啦. 一.内嵌滚动条 1.下面这张图就是内嵌div带有滚动条的样子,记住它的长相.
- ES6的特性(译+注解)
介绍 ES6,也叫ECMAScript2015(以下统称ES6),是ECMAScript标准的最新版本.这个标准在2015年6月份被正式批准.ES6是js语言很有意义的一次更新,也是2009年ES5被 ...
- Error converting bytecode to dex: Cause: java.lang.RuntimeException: Exception parsing classes
http://blog.csdn.net/xx326664162/article/details/51859106 总算有个靠谱的了
- Ubuntu 14.04 安装JDK 8
1.安装JDK,参考 1.下载 JDK 8 从http://www.oracle.com/technetwork/java/javasebusiness/downloads/选择下载JDK的最新版本 ...
- HDU 6081 度度熊的王国战略【并查集/数据弱水题/正解最小割算法】
链接6081 度度熊的王国战略 Time Limit: 40000/20000 MS (Java/Others) Memory Limit: 32768/132768 K (Java/Others) ...
- 【状压基础题】poj3254 Corn Fields
题目大意 :农夫约翰有n*m块地,其中一些地荒掉了.玉米是一种傲娇的植物,种在相邻的地里会导致不孕不育.求所有种法数对100000000求余. 读入:第一行一个n一个m, 接下来是一个n行m列的矩形, ...