
Solr6.6 配置中文分词库mmseg4j
1、准备
首先安装solr:参照搜索引擎Solr-6.6.0搭建,如果版本高于6,可能会不支持,需要改mmseg4j包
mmseg4j包下载: mmseg4j-solr-2.3.0-with-mmseg4j-core.zip 或https://pan.baidu.com/s/1dD7qMFf#list/path=%2F
开源地址:https://github.com/chenlb/mmseg4j-solr
解压下载的压缩包mmseg4j-solr-2.3.0-with-mmseg4j-core.zip,得到mmseg4j-core-1.10.0.jar和mmseg4j-solr-2.3.0.jar把这两个文件拷贝到tomcat的webapps\solr\WEB-INF\lib路径下

2、建立core
建立mycore,具体参见搜索引擎Solr-6.6.0搭建的“四、Solr6.6.0环境搭建”部分。
3、修改配置文件
修改mycore/conf的配置文件managed-schema,增加以下内容:
<!-- mmseg4j fieldType-->

    <fieldType name="text_mmseg4j_complex" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

            <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="complex" />

        </analyzer>

    </fieldType>

    <fieldType name="text_mmseg4j_maxword" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

            <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="max-word" />

        </analyzer>

    </fieldType>

    <fieldType name="text_mmseg4j_simple" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

          <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="simple" />

        </analyzer>

    </fieldType>
启动重新启动tomcat,在浏览器中输入http://localhost:8080/solr/index.html,
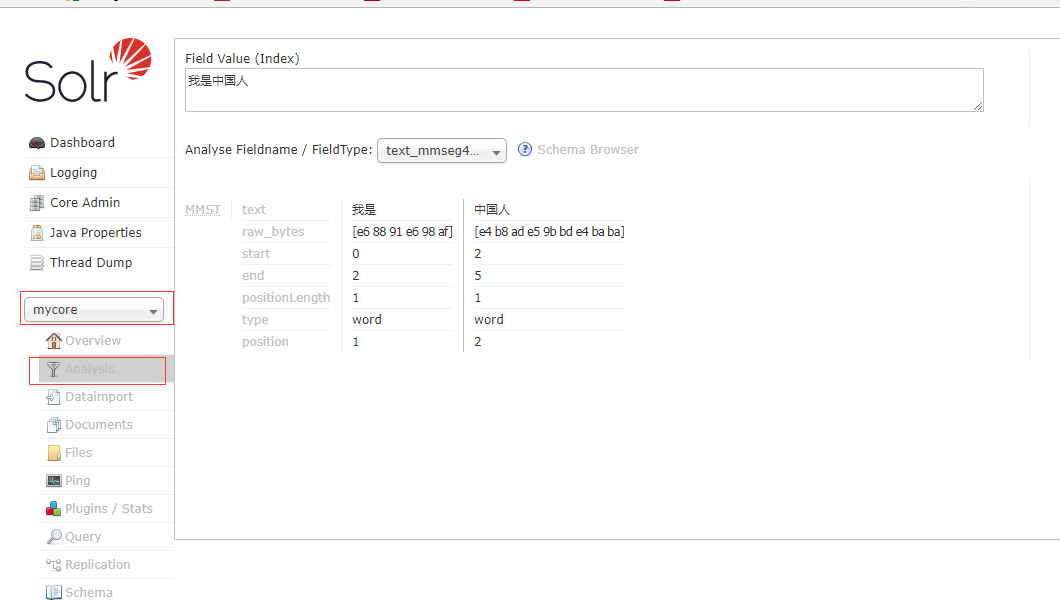
在管理界面选择分析,输入“我是中国人” 类型选择上面的三种的一种进行分析如下:
4、直接启动solr自带的Jetty,不用tomcat
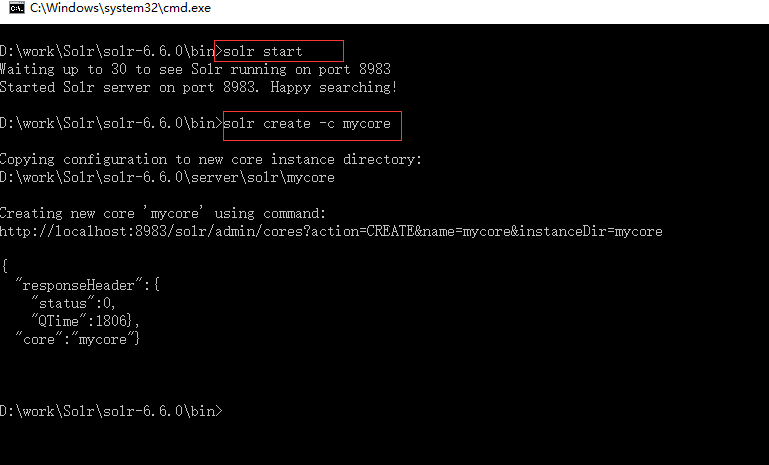
进入solr6.6的bin目录,启动solr,通过命令建立core
solr create -c mycore
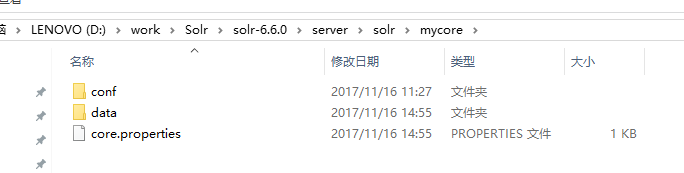
这样在solr-6.6.0\server\solr目录下生成mycore

修改mycore\conf文件夹下的配置文件managed-schema,在最后新增一项内容
<!-- mmseg4j fieldType-->

    <fieldType name="text_mmseg4j_complex" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

            <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="complex" />

        </analyzer>

    </fieldType>

    <fieldType name="text_mmseg4j_maxword" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

            <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="max-word" />

        </analyzer>

    </fieldType>

    <fieldType name="text_mmseg4j_simple" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

          <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="simple" />

        </analyzer>

    </fieldType>
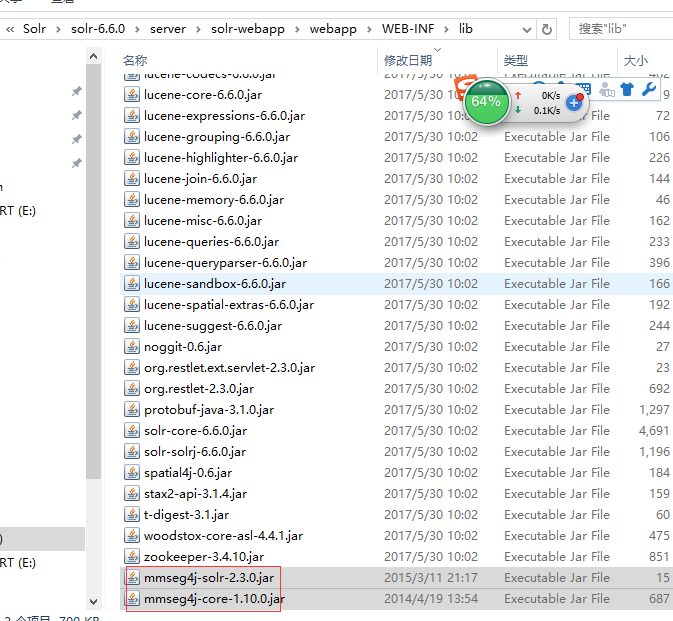
把mmseg4j-core-1.10.0.jar和mmseg4j-solr-2.3.0.jar拷贝到solr-6.6.0\server\solr-webapp\webapp\WEB-INF\lib文件夹下
执行命令solr stop -all
重新启动solr
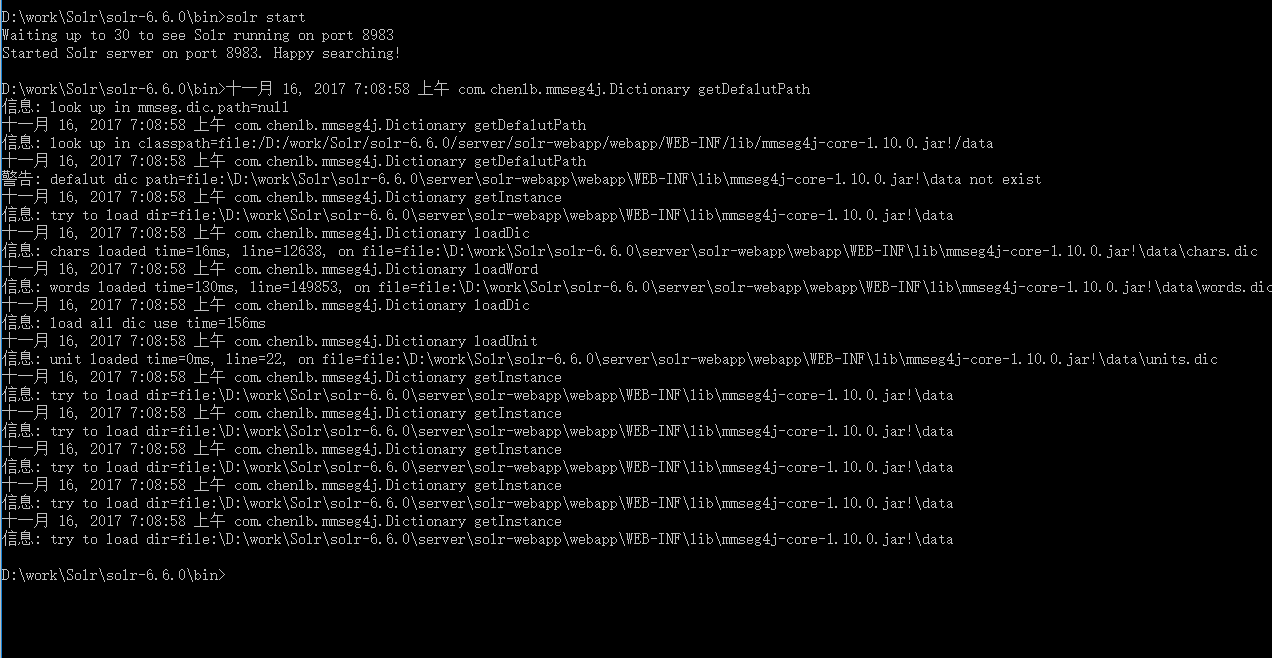
重新打开浏览器输入:http://localhost:8983/solr/#/
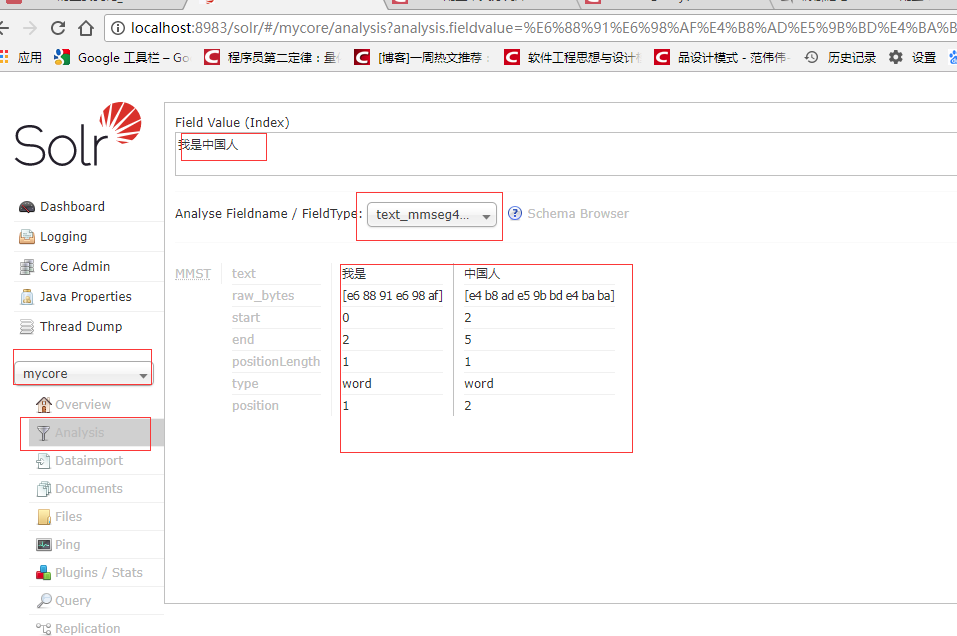
或者直接修改solr-6.6.0\server\solr\configsets\data_driven_schema_configs\conf文件夹下的配置文件managed-schema,在最后新增以下内容:
<!-- mmseg4j fieldType-->

    <fieldType name="text_mmseg4j_complex" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

            <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="complex" />

        </analyzer>

    </fieldType>

    <fieldType name="text_mmseg4j_maxword" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

            <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="max-word" />

        </analyzer>

    </fieldType>

    <fieldType name="text_mmseg4j_simple" class="solr.TextField" positionIncrementGap="100" >

        <analyzer>

          <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="simple" />

        </analyzer>

    </fieldType>
这样在新建core的时候就不用每次都修改单个core的managed-schema配置文件了
参照资料:http://blog.csdn.net/jiangchao858/article/details/53026374
Solr6.6 配置中文分词库mmseg4j的更多相关文章
- 转:solr6.0配置中文分词器IK Analyzer
solr6.0中进行中文分词器IK Analyzer的配置和solr低版本中最大不同点在于IK Analyzer中jar包的引用.一般的IK分词jar包都是不能用的,因为IK分词中传统的jar不支持s ...
- 我与solr(六)--solr6.0配置中文分词器IK Analyzer
转自:http://blog.csdn.net/linzhiqiang0316/article/details/51554217,表示感谢. 由于前面没有设置分词器,以至于查询的结果出入比较大,并且无 ...
- Solr6.5配置中文分词IKAnalyzer和拼音分词pinyinAnalyzer (二)
之前在 Solr6.5在Centos6上的安装与配置 (一) 一文中介绍了solr6.5的安装.这篇文章主要介绍创建Solr的Core并配置中文IKAnalyzer分词和拼音检索. 一.创建Core: ...
- Solr6.5配置中文分词器
Solr作为搜索应用服务器,我们在使用过程中,不可避免的要使用中文搜索.以下介绍solr自带的中文分词器和第三方分词器IKAnalyzer. 注:下面操作在Linux下执行,所添加的配置在windo ...
- Hanlp等七种优秀的开源中文分词库推荐
Hanlp等七种优秀的开源中文分词库推荐 中文分词是中文文本处理的基础步骤,也是中文人机自然语言交互的基础模块.由于中文句子中没有词的界限,因此在进行中文自然语言处理时,通常需要先进行分词. 纵观整个 ...
- Slackware Linux or FreeBSD 配置中文环境。
配置中文环境. Slackware Linux 如果在控制面板的语言与地区选项中没有找到中文,那说明在安装系统选择软件的时候没有将国际语言支持包选上,可以从slackware的安装盘或ISO文件中提取 ...
- centos7 学习1 KDE配置中文
安装kde桌面后没有中文,可以用以下方法配置中文 #yum list kde*chinese 会显示可以安装的包,我的显示如下 kde-l10n-Chinese.noarch -.fc14 @upda ...
- 沈逸老师ubuntu速学笔记(1)--安装flashplayer,配置中文输入法以及常用命令
开篇首先感谢程序员在囧途(www.jtthink.com)以及沈逸老师,此主题笔记主要来源于沈老师课程.同时也感谢少年郎,秦少.花旦等同学分享大家的学习笔记. 1.安装flash player ctr ...
- 5.Solr4.10.3中配置中文分词器
转载请出自出处:http://www.cnblogs.com/hd3013779515/ 1.下载IK Analyzer 2012FF_hf1.zip并上传到/home/test 2.按照如下命令安装 ...
随机推荐
- Winform 中panel的mousewheel鼠标滚轮事件触发
如果将窗体或容器控件(如Panel控件)的AutoScroll属性设置为True时,那么当窗体或Panel容不下其中的子控件时就会出现 滚动条,通过移动滚动条可以上下显示出窗体或Panel中的全部内容 ...
- 关于一些Java基础数据类型的常用方法的应用场景的小思考
昨天遇到一个问题,按照我的一半解决方法是传一个参数,然后通过参数来控制逻辑处理:但是领导发现String的一个方法也可以完全完成该问题!而我完全没有get到这个点! so,我认识到了自己的知识盲区:基 ...
- [ Python - 2 ] 常见内置函数
1. abs(): 绝对值 In [1]: abs(-10) Out[1]: 10 2. all(): 当参数中任何一个值为False时,all() 都为False all(iterable) ...
- DRF的限流功能
限流,可以对接口访问的频次进行限制,以减轻服务器压力. 全局配置 在settings.py上添加 REST_FRAMEWORK = { 'DEFAULT_THROTTLE_CLASSES': ( 'r ...
- 【python】python2.x 与 python3.x区别对照+缩进错误解决方法
仅仅列出我用到的,不全. 划重点: 1. urllib2 用 urllib.request 代替 2. urllib.urlencode 用 urllib.parse.urlencode 代替 3. ...
- elasticsearch SpanNearQuery inOrder参数
一直没有注意还有一个inOrder参数: public SpanNearQuery(SpanQuery[] clauses, int slop, boolean inOrder) When inOrd ...
- 浅谈replace()
replace()简单介绍 replace()基本语法是String.replace(searchValue,replaceValue),其中searchValue为字符串或者正则,replaceVa ...
- Square Number & Cube Number
Square Number: Description In mathematics, a square number is an integer that is the square of an in ...
- CSU 1337 搞笑版费马大定理【优化枚举】
费马大定理:当n>2时,不定方程an+bn=cn没有正整数解.比如a3+b3=c3没有正整数解.为了活跃气氛,我们不妨来个搞笑版:把方程改成a3+b3=c3,这样就有解了,比如a=4, b=9, ...
- RabbitMQ生产部署指南
像RabbitMQ这样的数据服务通常有许多可调参数.一些配置对开发有很大的意义,但并不适合生产,本指南旨在为此提供帮助 虚拟主机 例如,在单租户环境中,当您的RabbitMQ集群专门为生产中的单个系统 ...