
Python基于jieba的中文词云
今日学习了python的词云技术
from os import path

from wordcloud import WordCloud

import matplotlib.pyplot as plt

d=path.dirname(__file__)

text=open(path.join(d,"data//constitution.txt")).read()

# 步骤3-2:设置一张词云图对象

wordcloud = WordCloud(background_color="white", max_font_size=40).generate(text)

# 步骤4-1:创建一个图表画布

plt.figure()

# 步骤4-2:设置图片

plt.imshow(wordcloud, interpolation="bilinear")

# 步骤4-3:取消图表x、y轴

plt.axis("off")

# 显示图片

plt.show()
结果如下:这是没有背景图的词云

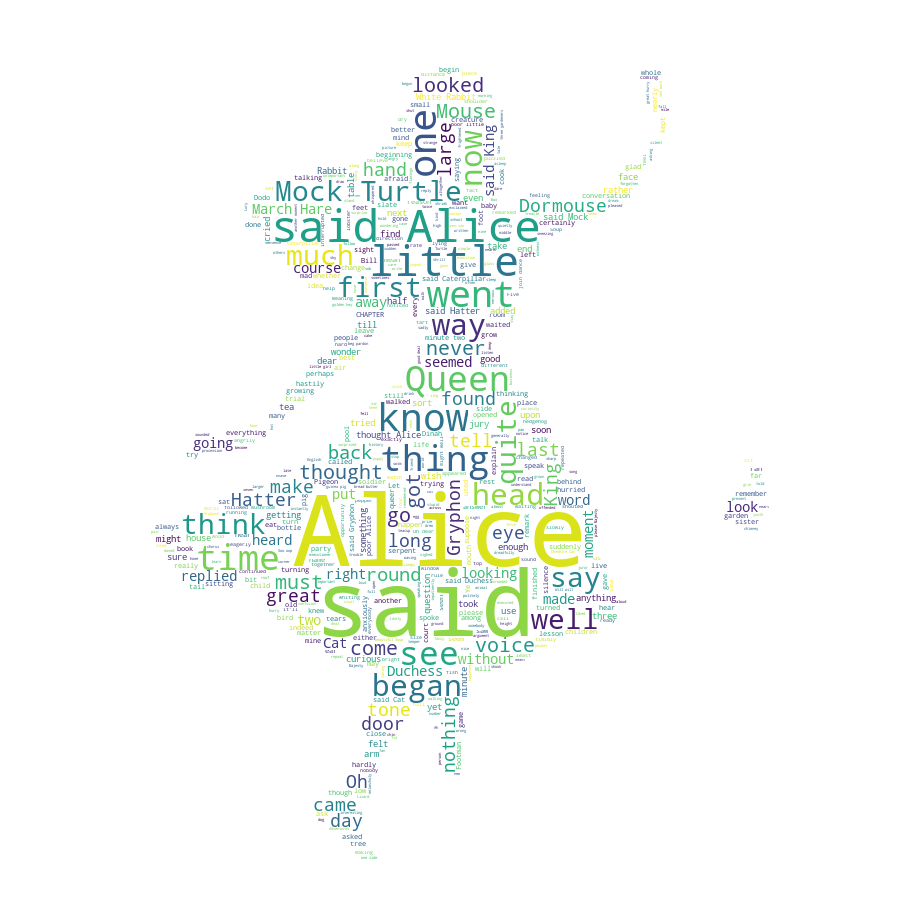
接下来这个是爱丽丝漫游小说的词云
from os import path

from PIL import Image

import numpy as np

from wordcloud import WordCloud

import matplotlib.pyplot as plt

d=path.dirname(__file__)

text=open(path.join(d,"data//alice.txt")).read()

alice_mask = np.array(Image.open(path.join(d, "data/alice_mask.png")))

wordcloud=WordCloud(background_color="white",max_words=2000,mask=alice_mask)

wordcloud.generate(text)

wordcloud.to_file(path.join(d,"images//alice_word.png"))
用英文做词云很简单,不需要很麻烦的分词技术,用wordcloud模块就可以简单实现
运行结果如下
背景图:
最后是中文词云,中文词云就比较麻烦了,得用到jieba模块的分词技术,还得筛选
import jieba

from os import path  #用来获取文档的路径

#词云

from PIL import Image

import numpy as  np

import matplotlib.pyplot as plt

#词云生成工具

from wordcloud import WordCloud,ImageColorGenerator

#需要对中文进行处理

import matplotlib.font_manager as fm

#背景图

bg=np.array(Image.open("data/4.jpg"))

#获取当前的项目文件加的路径

d=path.dirname(__file__)

#读取停用词表

stopwords_path='data/alice.txt'

#添加需要自定以的分词

jieba.add_word("侯亮平")

#读取要分析的文本

text_path="data//sanguo.txt"

#读取要分析的文本,读取格式

text=open(path.join(d,text_path),encoding="utf8").read()

#定义个函数式用于分词

def jiebaclearText(text):

    #定义一个空的列表,将去除的停用词的分词保存

    mywordList=[]

    #进行分词

    seg_list=jieba.cut(text,cut_all=False)

    #将一个generator的内容用/连接

    listStr='/'.join(seg_list)

    #打开停用词表

    f_stop=open(stopwords_path,encoding="utf8")

    #读取

    try:

        f_stop_text=f_stop.read()

    finally:

        f_stop.close()#关闭资源

    #将停用词格式化,用\n分开,返回一个列表

    f_stop_seg_list=f_stop_text.split("\n")

    #对默认模式分词的进行遍历,去除停用词

    for myword in listStr.split('/'):

        #去除停用词

        if not(myword.split()) in f_stop_seg_list and len(myword.strip())>1:

            mywordList.append(myword)

    return ' '.join(mywordList)

text1=jiebaclearText(text)

#生成

wc=WordCloud(

    background_color="white",

    max_words=150,

    mask=bg,            #设置图片的背景

    max_font_size=60,

    random_state=42,

    font_path='C:/Windows/Fonts/simkai.ttf'   #中文处理,用系统自带的字体

    ).generate(text1)

#为图片设置字体

my_font=fm.FontProperties(fname='C:/Windows/Fonts/simkai.ttf')

#产生背景图片,基于彩色图像的颜色生成器

image_colors=ImageColorGenerator(bg)

#开始画图

plt.imshow(wc,interpolation="bilinear")

#为云图去掉坐标轴

plt.axis("off")

#画云图,显示

#plt.figure()

plt.show()

#为背景图去掉坐标轴

plt.axis("off")

plt.imshow(bg,cmap=plt.cm.gray)

#plt.show()

#保存云图

wc.to_file("data/sanguo.png")
运行结果:
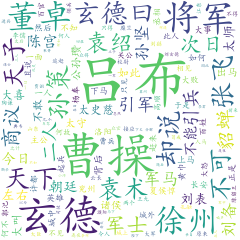
可以看出,三国前20回里,吕布,曹操,玄德等词出现的最多
Python基于jieba的中文词云的更多相关文章
- Python 爬取生成中文词云以爬取知乎用户属性为例
代码如下: # -*- coding:utf-8 -*- import requests import pandas as pd import time import matplotlib.pyplo ...
- 超详细:Python(wordcloud+jieba)生成中文词云图
# coding: utf-8 import jieba from scipy.misc import imread # 这是一个处理图像的函数 from wordcloud import WordC ...
- [Python] 基于 jieba 的中文分词总结
目录 模块安装 开源代码 基本用法 启用Paddle 词性标注 调整词典 智能识别新词 搜索引擎模式分词 使用自定义词典 关键词提取 停用词过滤 模块安装 pip install jieba jieb ...
- python 基于 wordcloud + jieba + matplotlib 生成词云
词云 词云是啥?词云突出一个数据可视化,酷炫.以前以为很复杂,不想python已经有成熟的工具来做词云.而我们要做的就是准备关键词数据,挑一款字体,挑一张模板图片,非常非常无脑.准备好了吗,快跟我一起 ...
- python抓取数据构建词云
1.词云图 词云图,也叫文字云,是对文本中出现频率较高的"关键词"予以视觉化的展现,词云图过滤掉大量的低频低质的文本信息,使得浏览者只要一眼扫过文本就可领略文本的主旨. 先看几个词 ...
- Java爬取B站弹幕 —— Python云图Wordcloud生成弹幕词云
一 . Java爬取B站弹幕 弹幕的存储位置 如何通过B站视频AV号找到弹幕对应的xml文件号 首先爬取视频网页,将对应视频网页源码获得 就可以找到该视频的av号aid=8678034 还有弹幕序号, ...
- AAAI 2018 论文 | 蚂蚁金服公开最新基于笔画的中文词向量算法
AAAI 2018 论文 | 蚂蚁金服公开最新基于笔画的中文词向量算法 2018-01-18 16:13蚂蚁金服/雾霾/人工智能 导读:词向量算法是自然语言处理领域的基础算法,在序列标注.问答系统和机 ...
- [python] 基于词云的关键词提取:wordcloud的使用、源码分析、中文词云生成和代码重写
1. 词云简介 词云,又称文字云.标签云,是对文本数据中出现频率较高的“关键词”在视觉上的突出呈现,形成关键词的渲染形成类似云一样的彩色图片,从而一眼就可以领略文本数据的主要表达意思.常见于博客.微博 ...
- python使用matplotlib画图,jieba分词、词云、selenuium、图片、音频、视频、文字识别、人脸识别
一.使用matplotlib画图 关注公众号"轻松学编程"了解更多. 使用matplotlib画柱形图 import matplotlib from matplotlib impo ...
随机推荐
- lLinux安装JDK
1.在Linux中新建文件夹 mkdir /usr/local/java 2.上传jdk-7u55-linux-i586.tar到Linux中 3.解压文件 tar xzvf jdk-7u55-l ...
- 转:C函数调用理解
1 空函数 int main() { 00411360 push ebp ;压入ebp 00411361 mov ebp,esp ;ebp = esp,保留esp,待函数调用完再恢复,因为函数调用中肯 ...
- fstat、stat和lstat 区别(转)
fstat.stat和lstat 区别(转) stat系统调用系列包括了fstat.stat和lstat,它们都是用来返回“相关文件状态信息”的,三者的不同之处在于设定源文件的方式不同. 1 首先隆重 ...
- 走进git
一.什么是git和githob? Git是一款免费.开源的分布式版本控制系统.Git 是 Linus Torvalds 为了帮助管理 Linux 内核开发而开发的一个开放源码的版本控制软件.Githu ...
- python入门22 pymssql模块(python连接sql server查询)
安装 pip install pymssql 连接数据库 pymssql.connect() # coding:utf-8 import pymssql server = '192.168.8.1' ...
- 2019年5月训练记录(更新ing)
前言 \(ZJOI\)正式结束了. 但期中考试只考了年级\(216\),退役既视感... 于是就被抓回去补文化课了. 下半个学期可能要以文化课为主了吧! 但周三.周日应该还是会正常参加训练的,但其他时 ...
- POJ 3694 无向图的桥
Network Time Limit: 5000MS Memory Limit: 65536K Total Submissions: 10404 Accepted: 3873 Descript ...
- mac下配置Node.js开发环境、express安装、创建项目
mac下配置Node.js开发环境.express安装.创建项目 一.node.js的安装 去官网下载对应的平台版本就可以了,https://nodejs.org 二.express安装 sudo n ...
- mybatis学习记录六——一对一、一对多和多对多查询
9 订单商品数据模型 9.1 数据模型分析思路 1.每张表记录的数据内容 分模块对每张表记录的内容进行熟悉,相当 于你学习系统 需求(功能)的过程. 2.每张表重要的字段设置 非空 ...
- 【luogu P2661 信息传递】 题解
题目链接:https://www.luogu.org/problemnew/show/P2661#sub 一种利用并查集求最小环的做法: 对于每个同学看作一个点,每次信息传递是一条有向边,当出现最小环 ...