
Pytorch基础(6)----参数初始化
一、使用Numpy初始化:【直接对Tensor操作】
对Sequential模型的参数进行修改:
 import numpy as np

 import torch

 from torch import nn

 # 定义一个 Sequential 模型

 net1 = nn.Sequential(

     nn.Linear(30, 40),

     nn.ReLU(),

     nn.Linear(40, 50),

     nn.ReLU(),

     nn.Linear(50, 10)

 )

 # 访问第一层的参数

 w1 = net1[0].weight

 b1 = net1[0].bias

 print(w1)

 #对第一层Linear的参数进行修改:

 # 定义第一层的参数 Tensor 直接对其进行替换

 net1[0].weight.data = torch.from_numpy(np.random.uniform(3, 5, size=(40, 30)))

 print(net1[0].weight)
23
24 #若模型中相同类型的层都需要初始化成相同的方式,一种更高效的方式:使用循环去访问:
25 for layer in net1:
26     if isinstance(layer, nn.Linear): # 判断是否是线性层
27         param_shape = layer.weight.shape
28         layer.weight.data = torch.from_numpy(np.random.normal(0, 0.5, size=param_shape))
29         # 定义为均值为 0,方差为 0.5 的正态分布
对Module模型 的参数初始化:
对于 Module 的参数初始化,其实也非常简单,如果想对其中的某层进行初始化,可以直接像 Sequential 一样对其 Tensor 进行重新定义,其唯一不同的地方在于,如果要用循环的方式访问,需要介绍两个属性,children 和 modules,下面我们举例来说明:
1、创建Module模型类:
 class sim_net(nn.Module):

     def __init__(self):

         super(sim_net, self).__init__()

         self.l1 = nn.Sequential(

             nn.Linear(30, 40),

             nn.ReLU()

         )

         self.l1[0].weight.data = torch.randn(40, 30) # 直接对某一层初始化

         self.l2 = nn.Sequential(

             nn.Linear(40, 50),

             nn.ReLU()

         )

         self.l3 = nn.Sequential(

             nn.Linear(50, 10),

             nn.ReLU()

         )

     def forward(self, x):

         x = self.l1(x)

         x =self.l2(x)

         x = self.l3(x)

         return x
2、创建模型对象:
net2 = sim_net()
3、访问children:
# 访问 children

for i in net2.children():

    print(i)
     #打印的结果:
Sequential(

  (0): Linear(in_features=30, out_features=40)

  (1): ReLU()

)

Sequential(

  (0): Linear(in_features=40, out_features=50)

  (1): ReLU()

)

Sequential(

  (0): Linear(in_features=50, out_features=10)

  (1): ReLU()

)
4、访问modules:
# 访问 modules

for i in net2.modules():

    print(i)

#打印的结果

sim_net(

  (l1): Sequential(

    (0): Linear(in_features=30, out_features=40)

    (1): ReLU()

  )

  (l2): Sequential(

    (0): Linear(in_features=40, out_features=50)

    (1): ReLU()

  )

  (l3): Sequential(

    (0): Linear(in_features=50, out_features=10)

    (1): ReLU()

  )

)

Sequential(

  (0): Linear(in_features=30, out_features=40)

  (1): ReLU()

)

Linear(in_features=30, out_features=40)

ReLU()

Sequential(

  (0): Linear(in_features=40, out_features=50)

  (1): ReLU()

)

Linear(in_features=40, out_features=50)

ReLU()

Sequential(

  (0): Linear(in_features=50, out_features=10)

  (1): ReLU()

)

Linear(in_features=50, out_features=10)

ReLU()
通过上面的例子,可以看到:
children 只会访问到模型定义中的第一层,因为上面的模型中定义了三个 Sequential,所以只会访问到三个 Sequential,而 modules 会访问到最后的结构,比如上面的例子,modules 不仅访问到了 Sequential,也访问到了 Sequential 里面,这就对我们做初始化非常方便。
5、采用循环初始化:
for layer in net2.modules():

    if isinstance(layer, nn.Linear):

        param_shape = layer.weight.shape

        layer.weight.data = torch.from_numpy(np.random.normal(0, 0.5, size=param_shape))
二、torch.nn.init初始化
PyTorch 还提供了初始化的函数帮助我们快速初始化,就是 torch.nn.init,其操作层面仍然在 Tensor 上。先介绍一种初始化方法:
Xavier 初始化方法:
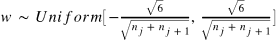
其中 和
表示该层的输入和输出数目。
这种非常流行的初始化方式叫 Xavier,方法来源于 2010 年的一篇论文 Understanding the difficulty of training deep feedforward neural networks,其通过数学的推到,证明了这种初始化方式可以使得每一层的输出方差是尽可能相等的。
torch.nn.init:
from torch.nn import init

init.xavier_uniform(net1[0].weight) # 这就是上面我们讲过的 Xavier 初始化方法,PyTorch 直接内置了其实现

#这就直接修改了net1[0].weight的值
Pytorch基础(6)----参数初始化的更多相关文章
- pytorch对模型参数初始化
1.使用apply() 举例说明: Encoder :设计的编码其模型 weights_init(): 用来初始化模型 model.apply():实现初始化 # coding:utf- from t ...
- PyTorch常用参数初始化方法详解
1. 均匀分布 torch.nn.init.uniform_(tensor, a=0, b=1) 从均匀分布U(a, b)中采样,初始化张量. 参数: tensor - 需要填充的张量 a - 均匀分 ...
- PyTorch模型读写、参数初始化、Finetune
使用了一段时间PyTorch,感觉爱不释手(0-0),听说现在已经有C++接口.在应用过程中不可避免需要使用Finetune/参数初始化/模型加载等. 模型保存/加载 1.所有模型参数 训练过程中,有 ...
- 【转载】 pytorch自定义网络结构不进行参数初始化会怎样?
原文地址: https://blog.csdn.net/u011668104/article/details/81670544 ------------------------------------ ...
- pytorch和tensorflow的爱恨情仇之参数初始化
pytorch和tensorflow的爱恨情仇之基本数据类型 pytorch和tensorflow的爱恨情仇之张量 pytorch和tensorflow的爱恨情仇之定义可训练的参数 pytorch版本 ...
- DL基础补全计划(五)---数值稳定性及参数初始化(梯度消失、梯度爆炸)
PS:要转载请注明出处,本人版权所有. PS: 这个只是基于<我自己>的理解, 如果和你的原则及想法相冲突,请谅解,勿喷. 前置说明 本文作为本人csdn blog的主站的备份.(Bl ...
- [源码解析] PyTorch分布式(6) -------- DistributedDataParallel -- 初始化&store
[源码解析] PyTorch分布式(6) ---DistributedDataParallel -- 初始化&store 目录 [源码解析] PyTorch分布式(6) ---Distribu ...
- pytorch基础教程1
0.迅速入门:根据上一个博客先安装好,然后终端python进入,import torch ******************************************************* ...
- [人工智能]Pytorch基础
PyTorch基础 摘抄自<深度学习之Pytorch>. Tensor(张量) PyTorch里面处理的最基本的操作对象就是Tensor,表示的是一个多维矩阵,比如零维矩阵就是一个点,一维 ...
随机推荐
- pascal+sublime搭建Pascal学习环境
一.fpc安装 1. 下载:http://www.freepascal.org/down/i386/win32.var(或者:http://download.csdn.net/detail/wenph ...
- 零基础学python-2.17 文件、open()、file()
今天我们来说说文件,以及跟文件有关的内建函数open和file 首先我们在python的根文件夹下建一个名为"123"的txt文本文件 文件中面我们输入一些文本 watermark ...
- 虚函数的特点就是执行的时候会下降到子类去执行同名覆盖函数 good
var t: TBitBtn;begin t:=TBitBtn.Create(nil); t.Name:='BitBtn100'; t.parent :=Self; // 这里下断点end; 一路跟踪 ...
- 传智播客C/C++学员荣膺微软&Cocos 2d-x黑客松最佳创新奖
6月30日,历时32小时的微软开放技术Cocos 2d-x 编程黑客松在北京望京微软大厦成功落下帷幕,这是微软开放技术首次联合Cocos 2d-x 在中国举办黑客松. 此次活动共同拥有包含传智播 ...
- [RK3288][Android6.0] U-boot 启动流程小结【转】
本文转载自:http://blog.csdn.net/kris_fei/article/details/52536093 Platform: RK3288OS: Android 6.0Version: ...
- bzoj5085: 最大
暴力是4方的,开始我只3方(扫描的时候更新当前最大) 二分+暴力可以做到m^2logMAX 二分答案,暴力枚举可行的两个位置形成一段,对于段,最多只会有m^2种情况. #include<cstd ...
- hdu 4704(费马小定理+快速幂取模)
Sum Time Limit: 2000/ ...
- 洛谷P2756 飞行员配对方案问题(二分图匹配)
P2756 飞行员配对方案问题 题目背景 第二次世界大战时期.. 题目描述 英国皇家空军从沦陷国征募了大量外籍飞行员.由皇家空军派出的每一架飞机都需要配备在航行技能和语言上能互相配合的2 名飞行员,其 ...
- 原生JS---2
js中的程序控制语句 常见的程序有三种执行结构: 1. 顺序结构 2. 分支结构 3. 循环结构 顺序结构:程序从第一行开始执行,按顺序执行到最后一行 分支结构:就像一条岔路口,必须选择且只能选择其中 ...
- 解决VS2008 开发Wince应用程序项目生成速度慢的问题
最近用VS2008开发Windows Mobile程序,使用C#..NET Compact Framework,发现项目生成速度比较慢.用VS2008打开项目后,开始一段时间生成速度还能忍受,时间一长 ...