
浅谈PipelineDB系列一: Stream数据是如何写到Continuous View中的
PipelineDB Version:0.9.7
PostgreSQL Version:9.5.3
PipelineDB的数据处理组件:
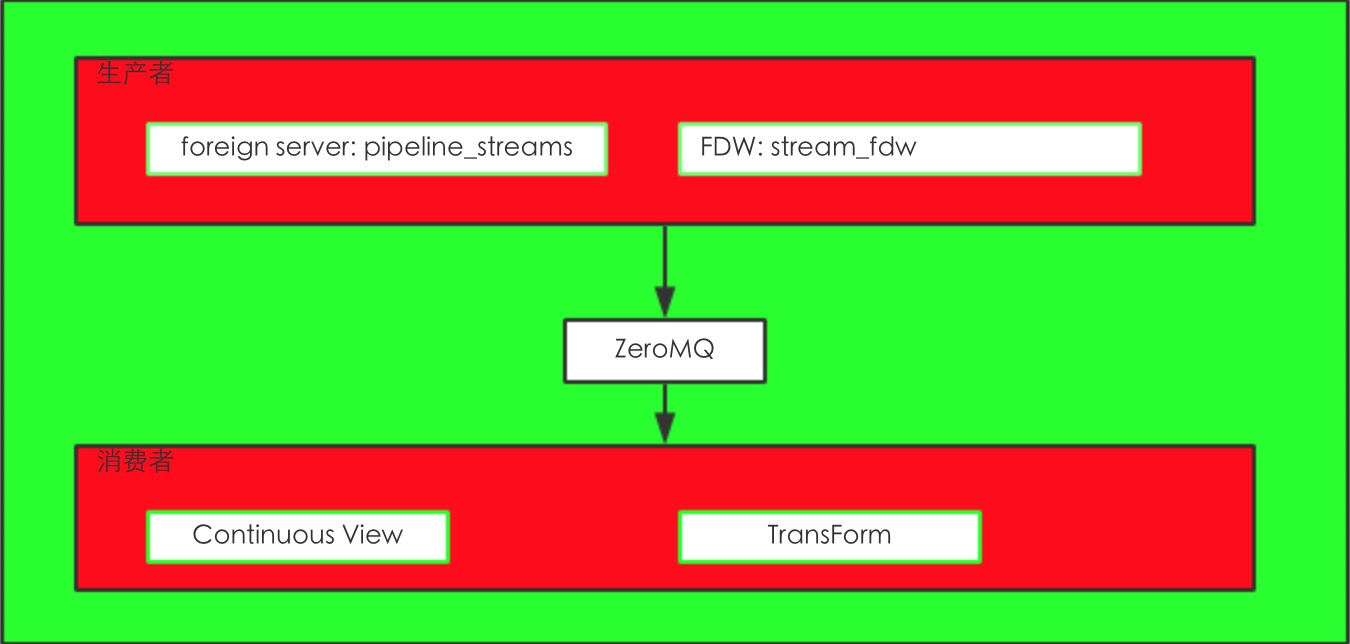
从上图来看主要就是pipeline_streams,stream_fdw,Continuous View,Transform。
其实就是运用了Postgres的FDW功能来实现的stream功能。
从数据库也能看到这个FDW
pipeline=# \des

                  List of foreign servers

       Name       |      Owner      | Foreign-data wrapper

------------------+-----------------+----------------------

 pipeline_streams | unknown (OID=0) | stream_fdw

(1 row)
数据流转入下图
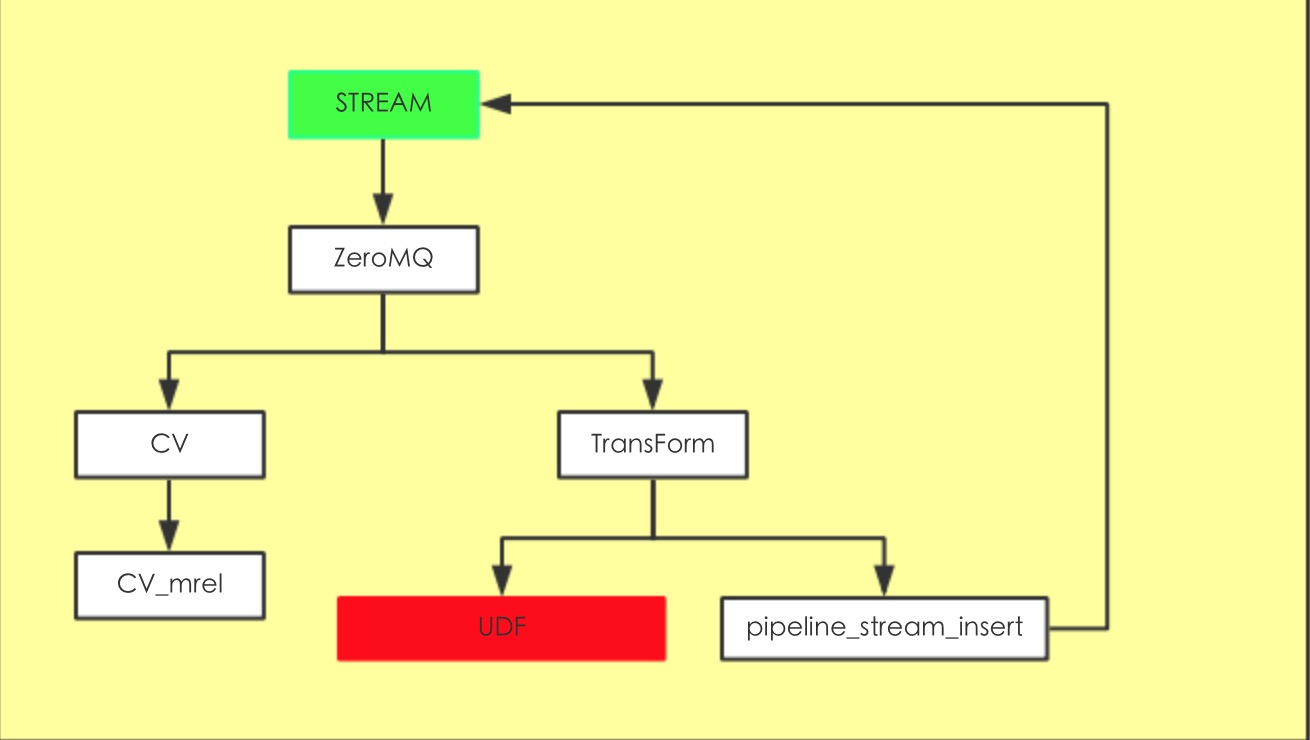
可以看到数据流转都是通过ZeroMQ来实现的(前面的版本0.8.2之前是通过TupleBuff来实现)
数据插入到Stream后然后调用ForiegnInsert,插入到初始化的IPC里面去,在数据库目录下面有个pipeline/zmq
TransForm其实就是把数据的dest指向了Stream,数据库默认有个pipeline_stream_insert其实这个是个Trigger,把tuple再扔到目标stream里面。
或者你可以自己写UDF,就是写个trigger,数据可以写到表或者别的FDW里面,或者是自己封装的消息队列IPC都没问题,这块自由发挥的空间就比较大。
首先我们来创建个STREAM跟CV
pipeline=# create stream my_stream(x bigint,y bigint,z bigint);

CREATE STREAM

pipeline=# create continuous view v_1 as select x,y,z from my_stream;

CREATE CONTINUOUS VIEW

pipeline=#
插入一条数据:
pipeline=# insert into my_stream(x,y,z) values(1,2,3);

INSERT 0 1

pipeline=# select * from v_1;

 x | y | z

---+---+---

 1 | 2 | 3

(1 row)

pipeline=#
数据插入到CV中了,我们现在来看看PipelineDB是如何插入的。
上面有介绍了Stream就是个FDW。我们来看看他的handler(source:src/backend/pipeline/stream_fdw.c)
/*

 * stream_fdw_handler

 */

Datum

stream_fdw_handler(PG_FUNCTION_ARGS)

{

	FdwRoutine *routine = makeNode(FdwRoutine);

	/* Stream SELECTS (only used by continuous query procs) */

	routine->GetForeignRelSize = GetStreamSize;

	routine->GetForeignPaths = GetStreamPaths;

	routine->GetForeignPlan = GetStreamScanPlan;

	routine->BeginForeignScan = BeginStreamScan;

	routine->IterateForeignScan = IterateStreamScan;

	routine->ReScanForeignScan = ReScanStreamScan;

	routine->EndForeignScan = EndStreamScan;

	/* Streams INSERTs */

	routine->PlanForeignModify = PlanStreamModify;

	routine->BeginForeignModify = BeginStreamModify;

	routine->ExecForeignInsert = ExecStreamInsert;

	routine->EndForeignModify = EndStreamModify;

	routine->ExplainForeignScan = NULL;

	routine->ExplainForeignModify = NULL;

	PG_RETURN_POINTER(routine);

}
主要是关注Streams Inserts这几个函数.
每个worker process启动的时候都会初始化一个recv_id,其实这个就是ZeroMQ的ID
数据会发送到对应的队列里面去,worker process就去这个IPC里面去获取数据
source:src/backend/pipeline/ipc/microbath.c
void

microbatch_send_to_worker(microbatch_t *mb, int worker_id)

{

    ......

			worker_id = rand() % continuous_query_num_workers;

		}

	}

	recv_id = db_meta->db_procs[worker_id].pzmq_id;

	microbatch_send(mb, recv_id, async, db_meta);

	microbatch_reset(mb);

}
首先是获取worker_id 这个是随机获取的一个worker进程。stream数据随机发到一worker process里面去了
recv_id这个就是从初始化的IPC队列获取ID,数据就发送到该队列里面
最后就调用
pzmq_send(recv_id, buf, len, true)
数据就推送到了IPC中了。
(gdb) p	recv_id

$12 = 1404688165

(gdb)
这部分就是数据生产者部分。
下面就是数据消费者CV
数据接受还是通过ZMQ的API来接受的
这个主要是worker process来干活的
srouce:src/backend/pipeline/ipc/pzmq.c&reader.c
(gdb) p *zmq_state->me

$8 = {id = 1404688165, type = 7 '\a', sock = 0x1139ba0, addr = "ipc:///home/pipeline/db_0.9.7/pipeline/zmq/1404688165.sock", '\000' <repeats 965 times>}

(gdb)
可以看到这个数据是从1404688165里面获取的 ,并且把IPC的addr也给出来了,这个就是我数据库目录
获取到是个buf,然后unpack,从消息里面获取到对应的Tuple.
获取到了tuple后,然后就找所有的CV跟这个stream相关的target。遍历他们,然后执行CV中对应的SQL。
执行流程跟标准SQL差不多也是初始化执行计划然后ExecutePlan然后endplan 。
数据会到Combiner里面,如果是AGG还会有一系列操作的。
如果数据符合CV的SQL逻辑,那么数据就插入到对应的物理表。
这就是Stream的一个简单的工作原理。
谢谢
浅谈PipelineDB系列一: Stream数据是如何写到Continuous View中的的更多相关文章
- 浅谈POSIX线程的私有数据
当线程中的一个函数需要创建私有数据时,该私有数据在对函数的调用之间保持一致,数据能静态地分配在存储器中,当我们采用命名范围也许可以实现它使用在函数或是文件(静态),或是全局(EXTERN).但是当涉及 ...
- 浅谈c#的三个高级参数ref out 和Params C#中is与as的区别分析 “登陆”与“登录”有何区别 经典SQL语句大全(绝对的经典)
浅谈c#的三个高级参数ref out 和Params c#的三个高级参数ref out 和Params 前言:在我们学习c#基础的时候,我们会学习到c#的三个高级的参数,分别是out .ref 和 ...
- 浅谈ASP.net处理XML数据
XML是一种可扩展的标记语言,比之之前谈到的html有着很大的灵活性,虽然它只是与HTML仅有一个字母只差,但两者有很大的区别. XML也是标记语言,所以它每个标签必须要闭合,而HTML偶尔忘了闭合也 ...
- sqlite升级--浅谈Android数据库版本升级及数据的迁移
Android开发涉及到的数据库采用的是轻量级的SQLite3,而在实际开发中,在存储一些简单的数据,使用SharedPreferences就足够了,只有在存储数据结构稍微复杂的时候,才会使用数据库来 ...
- 浅谈c语言代码段 数据段 bss段
代码段.数据段.bss段 (1)编译器在编译程序的时候,将程序中的所有的元素分成了一些组成部分,各部分构成一个段,所以说段是可执行程序的组成部分. (2)代码段:代码段就是程序中的可执行部分,直观理解 ...
- 浅谈Xcode5和Xcode7在系统创建的文件夹和文件中的区别
*:first-child { margin-top: 0 !important; } body > *:last-child { margin-bottom: 0 !important; } ...
- 【WebApi系列】浅谈HTTP
[01]浅谈HTTP在WebApi开发中的运用 [02]聊聊WebApi体系结构 [03]详解WebApi如何传递参数 [04]详解WebApi测试和PostMan [05]浅谈WebApi Core ...
- 【WebApi系列】浅谈HTTP在WebApi开发中的运用
WebApi系列文章 [01]浅谈HTTP在WebApi开发中的运用 [02]聊聊WebApi体系结构 [03]详解WebApi参数的传递 [04]详解WebApi测试和PostMan [05]浅谈W ...
- 浅谈如何使用python抓取网页中的动态数据
我们经常会发现网页中的许多数据并不是写死在HTML中的,而是通过js动态载入的.所以也就引出了什么是动态数据的概念, 动态数据在这里指的是网页中由Javascript动态生成的页面内容,是在页面加载到 ...
随机推荐
- 笔记-JDBC和commons-dbutils
1.前言 玩过Java web的人应该都接触过JDBC,正是有了它,Java程序才能轻松地访问数据库.JDBC很多人都会,但是为什么我还要写它呢?我曾经一度用烂了JDBC,一度认为JDBC不过如此,后 ...
- 基于Lua脚本解决实时数据处理流程中的关键问题
摘要 在处理实时数据的过程中需要缓存的参与,由于在更新实时数据时并发处理的特点,因此在更新实时数据时经常产生新老数据相互覆盖的情况,针对这个情况调查了Redis事务和Lua脚本后,发现Redis事务并 ...
- 安装PyQt5之后mayavi和VTK不能使用
mayavi在显示数据的过程中需要调用PyQt4的GUI方法产生应用框架.但是新发布的PyQt5和PyQt4在很多方面都是不兼容的,这也就导致了用mayavi编写的程序运行失败.在实践之后,我的解决方 ...
- Windows环境下Android Studio安装和使用教程
Windows环境下Android Studio安装和使用教程 来源: http://www.cnblogs.com/liuhongfeng/archive/2015/12/30/5084896.ht ...
- code forces 436 D. Make a Permutation!
D. Make a Permutation! time limit per test 2 seconds memory limit per test 256 megabytes input stand ...
- spring cloud+dotnet core搭建微服务架构:Api授权认证(六)
前言 这篇文章拖太久了,因为最近实在太忙了,加上这篇文章也非常长,所以花了不少时间,给大家说句抱歉.好,进入正题.目前的项目基本都是前后端分离了,前端分Web,Ios,Android...,后端也基本 ...
- 从一个实例谈谈postgresql索引锁
最近客户在使用我司开发的数据库时,报告了如下问题(也不能算是问题,就是疑惑吧),环境如下: OS : Red Hat Enterprise Linux Server release 6.7 (Sant ...
- LNMP架构部署
第1章 部署LNMP架构步骤 1.1 ①部署Linux系统(OK) 基本优化完成(ip地址设置 yum源更新 字符集设置) 安全优化完成(iptables关闭 selinux关闭 /tmp/ 1777 ...
- android wear开发:为可穿戴设备创建一个通知 - Creating a Notification for Wearables
注:本文内容来自:https://developer.android.com/training/wearables/notifications/creating.html 翻译水平有限,如有疏漏,欢迎 ...
- C#中抽象类和接口的区别2
1.接口是为了满足外部调用而定义的一个功能约定, 因此反映的是事物的外部特性 抽象类是从一系列相关对象中抽象出来的概念, 因此反映的是事物的内部共性: 2. 下面分别从声明, ...