
java基础系列(三)---HashMap
java基础解析系列(三)---HashMap
java基础解析系列
- java基础解析系列(一)---String、StringBuffer、StringBuilder
- java基础解析系列(二)---Integer
- java基础解析系列(三)---HashMap
- 这是我的博客目录,欢迎阅读
基本概念
- 节点:
Node<Key,Value>,存放key和value
static class Node<K,V> implements Map.Entry<K,V> {

    final int hash;

    final K key;

    V value;

    Node<K,V> next;

}
- 键值对数组:
Node<K,V>[] table - 加载因子
- 容量 :Node数组的长度
- 大小:hashmap存放的Node的数目
- 阈值:容量*加载因子
工作原理
- 创建一个长度为2的次幂的node数组
- put的时候,计算key的hash值,将hash值与长度-1进行与运算
- 如果数组该下标的位置为空,直接存放,如果不为空,判断节点是否为树节点,如果是的话按红黑树的方式存入,否则按照链表的形式存入
- 当hashmap的节点数目大于阈值的时候,将会重新构造hashmap,而这种操作是费时的操作,所以建议初始化一个合适的容量
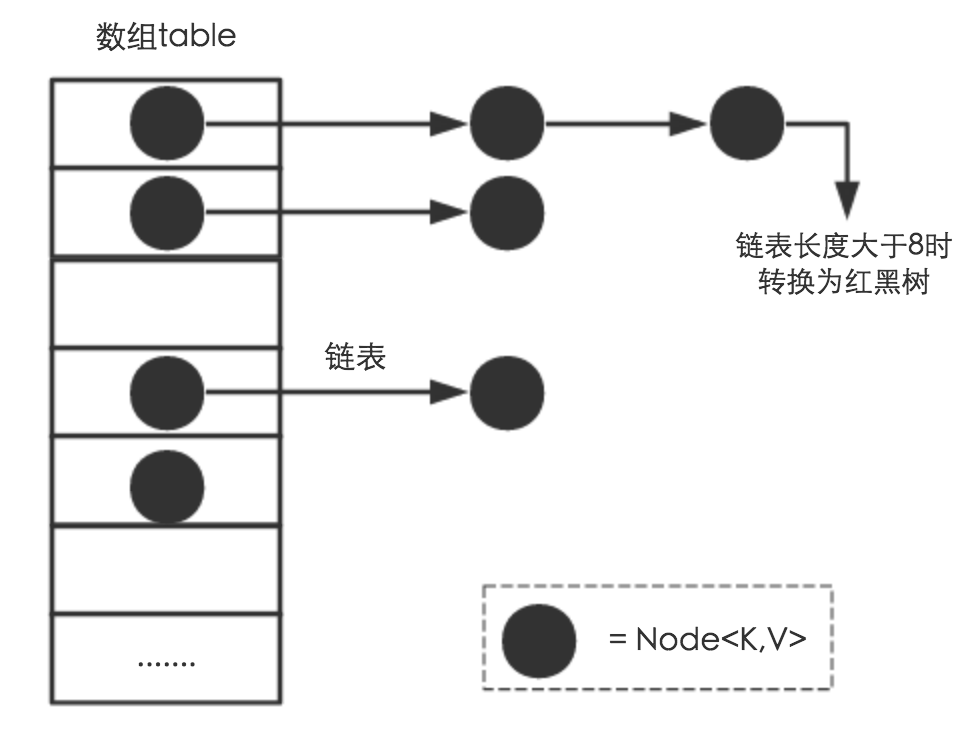
域
- 默认容量,2的四次方
static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16
- 默认加载因子
static final float DEFAULT_LOAD_FACTOR = 0.75f;
- node 数组
transient Node<K,V>[] table;
- 键值对数目,不是table的长度
    /**

     * The number of key-value mappings contained in this map.

     */

    transient int size;
- 阈值
    /**

     * The next size value at which to resize (capacity * load factor).

     *

     * @serial

     */

    //阈值

    int threshold;
- 加载因子
    /**

     * The load factor for the hash table.

     *

     * @serial

     */

     //加载因子

    final float loadFactor;
构造方法
- 传入初始容量和加载因子
 public HashMap(int initialCapacity, float loadFactor) {

        if (initialCapacity < 0)

            throw new IllegalArgumentException("Illegal initial capacity: " +

                                               initialCapacity);

        if (initialCapacity > MAXIMUM_CAPACITY)

            initialCapacity = MAXIMUM_CAPACITY;

        if (loadFactor <= 0 || Float.isNaN(loadFactor))

            throw new IllegalArgumentException("Illegal load factor: " +

                                               loadFactor);

        this.loadFactor = loadFactor;

        this.threshold = tableSizeFor(initialCapacity);

    }
- 传入初始容量,使用默认的加载因子
    public HashMap(int initialCapacity) {

        this(initialCapacity, DEFAULT_LOAD_FACTOR);

    }
- 无参数,默认容量和加载因子
    /**

     * Constructs an empty <tt>HashMap</tt> with the default initial capacity

     * (16) and the default load factor (0.75).

     */

    public HashMap() {

        this.loadFactor = DEFAULT_LOAD_FACTOR; // all other fields defaulted

    }
)
- 容量必须是2的n次方,当你传入的参数不符合条件,会有方法找到一个大于这个参数的最小的2的n次方数(比如大于6的最小2的n次幂是8),
put方法
public V put(K key, V value) {

        return putVal(hash(key), key, value, false, true);

    }

    final V putVal(int hash, K key, V value, boolean onlyIfAbsent,

                   boolean evict) {

        Node<K,V>[] tab; Node<K,V> p; int n, i;

        if ((tab = table) == null || (n = tab.length) == 0)

            n = (tab = resize()).length;

        if ((p = tab[i = (n - 1) & hash]) == null)

            tab[i] = newNode(hash, key, value, null);

        else {

            Node<K,V> e; K k;

            if (p.hash == hash &&

                ((k = p.key) == key || (key != null && key.equals(k))))

                e = p;

            else if (p instanceof TreeNode)

                e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);

            else {

                for (int binCount = 0; ; ++binCount) {

                    if ((e = p.next) == null) {

                        p.next = newNode(hash, key, value, null);

                        if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st

                            treeifyBin(tab, hash);

                        break;

                    }

                    if (e.hash == hash &&

                        ((k = e.key) == key || (key != null && key.equals(k))))

                        break;

                    p = e;

                }

            }

            if (e != null) { // existing mapping for key

                V oldValue = e.value;

                if (!onlyIfAbsent || oldValue == null)

                    e.value = value;

                afterNodeAccess(e);

                return oldValue;

            }

        }

        ++modCount;

        if (++size > threshold)

            resize();

        afterNodeInsertion(evict);

        return null;

    }
- 直接用伪代码表示
put()

{

    index=[hash(key)&(captity-1)]----下标的最大值为captity-1,进行与运算后最终的结果小于等于最大下标

    if(table[index])==null)

        直接添加node

    else

    {

        if(p是treenode)

        {

            直接将节点添加到红黑树

        }

        else

        {

            如果不是红黑树是链表

            if(p的键值==key)

                覆盖value

            else

            {

                遍历链表:

                {

                    if(有对应的key)

                    {

                        覆盖value

                        break;

                    }

                }

               遍历完成后没有发现对应的key

                {

                    添加到链表

                    if(链表长度>8)

                    {

                        将链表转化为红黑树

                    }

                }

            }

        }

        if(大小大于阈值)

        {

            容量加倍,重新构造

        }

    }

}
get方法
 public V get(Object key) {

        Node<K,V> e;

        return (e = getNode(hash(key), key)) == null ? null : e.value;

    }

    final Node<K,V> getNode(int hash, Object key) {

        Node<K,V>[] tab; Node<K,V> first, e; int n; K k;

        if ((tab = table) != null && (n = tab.length) > 0 &&

            (first = tab[(n - 1) & hash]) != null) {

            //如果链表的第一个节点是的键和要查找的键相等,那么返回该node

            if (first.hash == hash && // always check first node

                ((k = first.key) == key || (key != null && key.equals(k))))

                return first;

            //如果不是的,看该节点是不是树节点,是的话,用树的方法查找节点,如果不是的按链表的方式查找

            if ((e = first.next) != null) {

                if (first instanceof TreeNode)

                    return ((TreeNode<K,V>)first).getTreeNode(hash, key);

                do {

                    if (e.hash == hash &&

                        ((k = e.key) == key || (key != null && key.equals(k))))

                        return e;

                } while ((e = e.next) != null);

            }

        }

        return null;

    }
为什么长度设置为2的n次方
if ((p = tab[i = (n - 1) & hash]) == null)

            tab[i] = newNode(hash, key, value, null);
- 存放node到table数组的时候,他的下标是通过(n-1)&hash计算出来的(数组长度-1 和 key的hash的值相与,最后结果小于等于长度-1),n为table的长度。
- 当长度为2的n次幂的时候,(n-1)&hash==hash%n,而前者是位运算,速度会快很多
负载因子
- 负载因子较大,说明阈值较大,也就意味着可能发生更多的冲突
- 负载因子较小,说明阈值较小,也就意味着可能会更少的冲突
- 发生冲突的时候,会降低hashmap的查找速度,所以当要求更少的内存的时候可以增加负载因子,当要求更高的查找速度的时候,可以减少负载因子。
- 默认的参数是平衡的选择,所以不建议修改
我觉得分享是一种精神,分享是我的乐趣所在,不是说我觉得我讲得一定是对的,我讲得可能很多是不对的,但是我希望我讲的东西是我人生的体验和思考,是给很多人反思,也许给你一秒钟、半秒钟,哪怕说一句话有点道理,引发自己内心的感触,这就是我最大的价值。(这是我喜欢的一句话,也是我写博客的初衷)
作者:jiajun 出处: http://www.cnblogs.com/-new/
本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。如果觉得还有帮助的话,可以点一下右下角的【推荐】,希望能够持续的为大家带来好的技术文章!想跟我一起进步么?那就【关注】我吧。
java基础系列(三)---HashMap的更多相关文章
- java‘小秘密’系列(三)---HashMap
java'小秘密'系列(三)---HashMap java基础系列 java'小秘密'系列(一)---String.StringBuffer.StringBuilder java'小秘密'系列(二)- ...
- java基础回顾(三)——HashMap与HashTable
public class Hashtable extends Dictionary implements Map, Cloneable, java.io.Serializable public cla ...
- java基础解析系列(三)---HashMap
java基础解析系列(三)---HashMap java基础解析系列 java基础解析系列(一)---String.StringBuffer.StringBuilder java基础解析系列(二)-- ...
- Java基础系列--HashMap(JDK1.8)
原创作品,可以转载,但是请标注出处地址:https://www.cnblogs.com/V1haoge/p/10022092.html Java基础系列-HashMap 1.8 概述 HashMap是 ...
- Java基础系列-Collector和Collectors
原创作品,可以转载,但是请标注出处地址:https://www.cnblogs.com/V1haoge/p/10748925.html 一.概述 Collector是专门用来作为Stream的coll ...
- 夯实Java基础系列1:Java面向对象三大特性(基础篇)
本系列文章将整理到我在GitHub上的<Java面试指南>仓库,更多精彩内容请到我的仓库里查看 [https://github.com/h2pl/Java-Tutorial](https: ...
- Java基础系列-ArrayList
原创文章,转载请标注出处:<Java基础系列-ArrayList> 一.概述 ArrayList底层使用的是数组.是List的可变数组实现,这里的可变是针对List而言,而不是底层数组. ...
- Java基础系列-二进制操作
原创文章,转载请标注出处:<Java基础系列-二进制操作> 概述 Java源码中涉及到大量的二进制操作,非常的复杂,但非常的快速. Java二进制表示法 首先了解下二进制,二进制是相对十进 ...
- Java基础系列-equals方法和hashCode方法
原创文章,转载请标注出处:<Java基础系列-equals方法和hashCode方法> 概述 equals方法和hashCode方法都是有Object类定义的. publi ...
随机推荐
- 漫谈格兰杰因果关系(Granger Causality)——第一章 野火烧不尽,春风吹又生
2017年7月9日上午6点10分,先师胡三清同志--新因果关系的提出者.植入式脑部电极癫痫治疗法的提出者.IEEE高级会员,因肺癌医治无效于杭州肿瘤医院去世,享年50岁.余蒙先师厚恩数载,一朝忽闻先师 ...
- 初学安卓开发随笔之 Menu、toast 用法、活动的四种启动模式 以及 一个方便的Base活动类使用方法
Toast toast 是安卓系统的一种非常棒的提醒方式 首先定义一个弹出Toast的触发点,比如可以是按钮之类 其中 Toast.LENGTH_SHORT是指显示时长 还有一个内置变量为Toast. ...
- Spring-mybatis没有了XXXmapper.java和Dao的实现类还有Service的实现类
对于刚学过框架的同学可能知道,mybatis有两种主要的配置文件: SqlMapConfig.xml(mybatis全局配置文件,名称不固定,用来配置运行环境(数据源.事务) XXXmapper.xm ...
- C++写#pragma warning(disable 4786)的作用
C++编程时,在使用STL(C++标准模板库)的时候经常引发类似的错误,尤其是vector,map这类模板类,模板中套模板,一不小心就很长了. 当命名超过C++规定范围255字符时,就会产生这个名为d ...
- log4g 使用教程
日志是应用软件中不可缺少的部分,Apache的开源项目log4j是一个功能强大的日志组件,提供方便的日志记录.在apache网站:jakarta.apache.org/log4j 可以免费下载到Log ...
- Solr(二)Centos7 下solr-5.5.4核的创建
solr核的创建 一 拷贝jar包 创建核需要一下两个Jar包,没有的话创建核会失败. (1)solr-dataimporthandler-5.3.1jar (2)solr-dataimporthan ...
- [js高手之路] es6系列教程 - var, let, const详解
function show( flag ){ console.log( a ); if( flag ){ var a = 'ghostwu'; return a; } else { console.l ...
- 七、vue中v-for有时候对页面不会重新渲染,数组变化后如何到渲染页面
v-for不能进行双向数据绑定,页面渲染完成后,再次更改v-for遍历的数据,js里面打印的数据看到数据值已经更改,但是页面的数据就是没有渲染,这是为什么呢? vue中v-for和angularj ...
- ios 监听TextField中内容
@property (weak, nonatomic) IBOutlet UITextField *UserID; @property (weak, nonatomic) IBOutlet UITex ...
- git分支管理之创建与合并分支
在版本回退里,你已经知道,每次提交,Git都把它们串成一条时间线,这条时间线就是一个分支.截止到目前,只有一条时间线,在Git里,这个分支叫主分支,即master分支.HEAD严格来说不是指向提交,而 ...