
scala 中的集合类
集合最重要的继承路线 —— Traversable -> Iterable -> Seq -> LinerSeq -> List
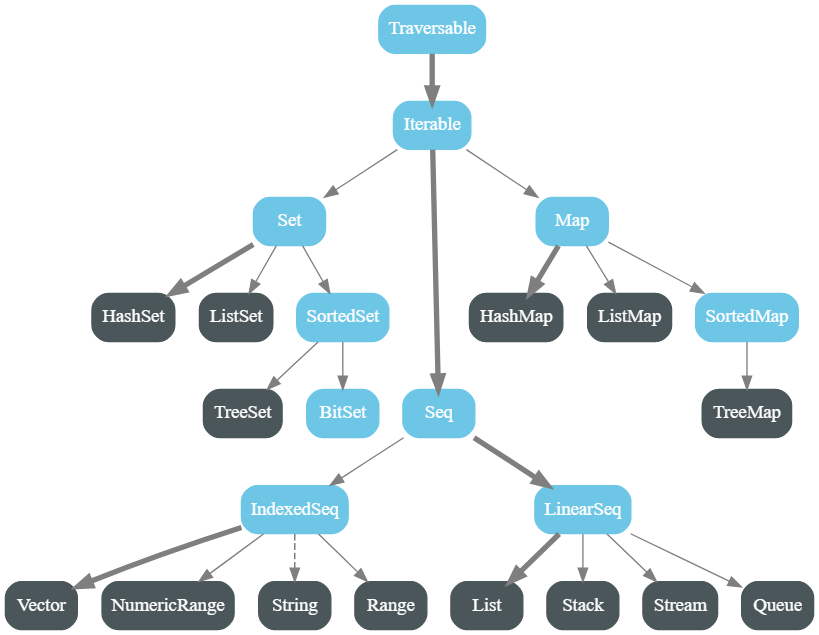
Traversable 中的公有方法:
| 分类 | 方法 |
| 相加操作 | ++ |
| 大小信息 | isEmpty,nonEmpty,size和hasDefiniteSize |
| 元素测试 | exists,forall和count |
| 元素检索 | head,last,headOption,lastOption和find |
| 转换操作 | toArray,toList,toIterable,toSeq,toIndexedSeq,toStream,toSet,和toMap |
| 构建新容器 | map, flatMap, collect, foldLeft,foldRight,/:,:\,reduceLeft |
| 子容器检索(返回子容器) | tail,init,slice,take,drop,takeWhilte,dropWhile,filter,filteNot和withFilter |
| 子容器拆分 | splitAt,span,partition和groupBy |
Iterable 中的公用方法
| 抽象方法 | xs.iterator |
| 其他迭代器 | xs grouped size,xs sliding size |
| 子容器(Subcollection) | xs takeRight n,xs dropRight n |
| 拉链方法(Zippers) | xs zip ys,xs zipAll (ys, x, y),xs.zip WithIndex |
| 比对 | xs sameElements ys |
序列 Seq
Seq trait用于表示序列。所谓序列,指的是一类具有一定长度的可迭代访问的对象。
序列的操作有以下几种,如下表所示:
- 索引和长度的操作 apply、isDefinedAt、length、indices,及lengthCompare。序列的apply操作用于索引访问;因此,Seq[T]类型的序列也是一个以单个Int(索引下标)为参数、返回值类型为T的偏函数。换言之,Seq[T]继承自Partial Function[Int, T]。序列各元素的索引下标从0开始计数,最大索引下标为序列长度减一。序列的length方法是collection的size方法的别名。lengthCompare方法可以比较两个序列的长度,即便其中一个序列长度无限也可以处理。
- 索引检索操作(indexOf、lastIndexOf、indexofSlice、lastIndexOfSlice、indexWhere、lastIndexWhere、segmentLength、prefixLength)用于返回等于给定值或满足某个谓词的元素的索引。
- 加法运算(+:,:+,padTo)用于在序列的前面或者后面添加一个元素并作为新序列返回。
- 更新操作(updated,patch)用于替换原序列的某些元素并作为一个新序列返回。
- 排序操作(sorted, sortWith, sortBy)根据不同的条件对序列元素进行排序。
- 反转操作(reverse, reverseIterator, reverseMap)用于将序列中的元素以相反的顺序排列。
- 比较(startsWith, endsWith, contains, containsSlice, corresponds)用于对两个序列进行比较,或者在序列中查找某个元素。
- 多集操作(intersect, diff, union, distinct)用于对两个序列中的元素进行类似集合的操作,或者删除重复元素。
如果一个序列是可变的,它提供了另一种更新序列中的元素的,但有副作用的update方法,Scala中常有这样的语法,如seq(idx) = elem。它只是seq.update(idx, elem)的简写,所以update 提供了方便的赋值语法。应注意update 和updated之间的差异。update 再原来基础上更改序列中的元素,并且仅适用于可变序列。而updated 适用于所有的序列,它总是返回一个新序列,而不会修改原序列。
Seq 具有两个子特征(subtrait) LinearSeq 和 IndexedSeq。它们不添加任何新的操作,但都提供不同的性能特点:线性序列具有高效的 head 和 tail 操作,而索引序列具有高效的apply, length, 和 (如果可变) update操作。
常用线性序列有 scala.collection.immutable.List和scala.collection.immutable.Stream。常用索引序列有 scala.Array scala.collection.mutable.ArrayBuffer。Vector 类提供一个在索引访问和线性访问之间有趣的折中。它同时具有高效的恒定时间的索引开销,和恒定时间的线性访问开销。正因为如此,对于混合访问模式,vector是一个很好的基础。
缓冲器
Buffers是可变序列一个重要的种类。它们不仅允许更新现有的元素,而且允许元素的插入、移除和在buffer尾部高效地添加新元素。buffer 支持的主要新方法有:用于在尾部添加元素的 += 和 ++=;用于在前方添加元素的+=: 和 ++=: ;用于插入元素的 insert和insertAll;以及用于删除元素的 remove 和 -=。如下表所示。
ListBuffer和ArrayBuffer是常用的buffer实现 。顾名思义,ListBuffer依赖列表(List),支持高效地将它的元素转换成列表。而ArrayBuffer依赖数组(Array),能快速地转换成数组。
映射
当你使用可变容器作为一个 hashmap 的键时,这将是一个潜在的陷阱
scala> import collection.mutable.{HashMap, ArrayBuffer}

import collection.mutable.{HashMap, ArrayBuffer}

scala> val buf = ArrayBuffer(1, 2, 3)

buf: scala.collection.mutable.ArrayBuffer[Int] =

ArrayBuffer(1, 2, 3)

scala> val map = HashMap(buf -> 3)

map: scala.collection.mutable.HashMap[scala.collection。

mutable.ArrayBuffer[Int],Int] = Map((ArrayBuffer(1, 2, 3),3))

scala> map(buf)

res13: Int = 3

scala> buf(0) += 1

scala> map(buf)

java.util.NoSuchElementException: key not found:

ArrayBuffer(2, 2, 3)
在这个例子中,由于数组xs的散列码已经在倒数第二行发生了改变,最后一行的选择操作将很有可能失败。因此,基于散列码的查找函数将会查找另一个位置,而不是xs所存储的位置。
233
https://www.scala-lang.org/files/archive/api/current/scala/collection/immutable/Iterable.html
https://docs.scala-lang.org/overviews/collections/introduction.html
scala 中的集合类的更多相关文章
- Scala中apply的用法
Scala中的 apply 方法有着不同的含义, 对于函数来说该方法意味着调用function本身, 以下说明摘自Programming in Scala, 3rd Edition Every fun ...
- Scala中Iterator允许执行一次
背景 使用spark执行mapPartitionsWithIndex((index,iterator)=>{....}),在执行体中将iterator进行一次迭代后,再次根据iterator执行 ...
- Objective-C中的集合类
下面详细的介绍Objective-C中的集合类以及每个集合类的用法,学过其他面向对象编程语言的小伙伴们看到OC的集合类会有种莫名的亲切感,理解起来问题不大,可以类比Java中的集合类去学习. 在Obj ...
- scala中的面向对象定义类,构造函数,继承
我们知道scala中一切皆为对象,函数也是对象,数字也是对象,它是一个比java还要面向对象的语言. 定义scala的简单类 class Point (val x:Int, val y:Int) 上面 ...
- Scala中的None,Nothing,Null,Nil
在scala中这四个类型名称很类似,作用确实完全不同的. None是一个object,是Option的子类型,定义如下 case object None extends Option[Nothing] ...
- 第52讲:Scala中路径依赖代码实战详解
今天学习了scala中的路径依赖,来看一下实战代码 class Outer{ private val x = 10 class Inner{ private val y = x +10 } ...
- 第51讲:Scala中链式调用风格的实现代码实战及其在Spark编程中的广泛运用
今天学习了下scala中的链式调用风格的实现,在spark编程中,我们经常会看到如下一段代码: sc.textFile("hdfs://......").flatMap(_.spl ...
- scala入门教程:scala中的面向对象定义类,构造函数,继承
我们知道scala中一切皆为对象,函数也是对象,数字也是对象,它是一个比java还要面向对象的语言. 定义scala的简单类 class Point (val x:Int, val y:Int) 上面 ...
- Scala 中object和class的区别
Scala中没有静态类型,但是有有“伴侣对象”,起到类似的作用. Scala中类对象中不可有静态变量和静态方法,但是提供了“伴侣对象”的功能:在和类的同一个文件中定义同名的Object对象:(须在同一 ...
随机推荐
- mysql查询列为空
SELECT * FROM `表名` WHERE ISNULL(列名)
- PHP生成短链接方法
PHP生成短链接方法方法一:新浪提供了长链接转为短链接的API,可以把长链接转为 t.cn/xxx 这种格式的短链接. API: http://api.t.sina.com.cn/short_url/ ...
- 一、Spring之组件注册-@Configuration&@Bean给容器中注册组件
xml配置方式 首先我们创建一个实体类Person public class Person { private String name; private Integer age; private St ...
- 使用WinFrom + CefSharp 开发客户端程序
今天使用CefSharp,加上本地资源文件嵌入了HTML.CSS.JS文件,做为Winform的UI:效果不错,漂亮可控,简简单单,半天时间搞定从开发到上线: 下面记录下相关的备忘: (窗口的效果) ...
- Knockout.js之初印象
最近在学Knockout.js,想要把看到的东西用blog记录下来. Knockout.js是一个MVVM的框架,突然想起之前有人问我哪些是MVVM框架?我回答了angular.js和bootstra ...
- 【转帖】从 Oracle 到 PostgreSQL ,某保险公司迁移实践 技术实践
从 Oracle 到 PostgreSQL ,某保险公司迁移实践 http://www.itpub.net/2019/11/08/4108/ 信泰人寿保险股份有限公司 摘要:去O一直是金融保险行业永恒 ...
- 48 容器(七)——HashMap底层:哈希表结构与哈希算法
哈希表结构 哈希表是由数组+链表组成的,首先有一个数组,数组的每一个位置都用来存储一个链表,链表的基本节点为:[hash值,key值,value值,next],当存入一个键值对时,首先调用hashco ...
- POJ 1661 Help Jimmy(C)动态规划
没刷过 POJ,这题是论坛有人问的,我才看看. 我发现 POJ 注册很奇怪,账号总是登不上去,弄的我还注册两个.Emmm 首次体验很差,还好我不在 POJ 刷题. 题目链接:POJ 1661 Help ...
- IP核——RAM
一.Quartus 1.打开Quartus ii,点击Tools---MegaWizard Plug-In Manager 2.弹出创建页面,选择Creat a new custom megafunc ...
- 【scratch3.0教程】1.3 了解scratch界面内容
第3课 了解Scratch界面内容 1.认识Scratch界面 双击桌面快捷方式,启动Scratch程序.我们来认识一下Scratch界面吧! (1)指令区 Scratch程序一共有运动.外观.声音. ...