
SparkStreaming+kafka Receiver模式
1.图解
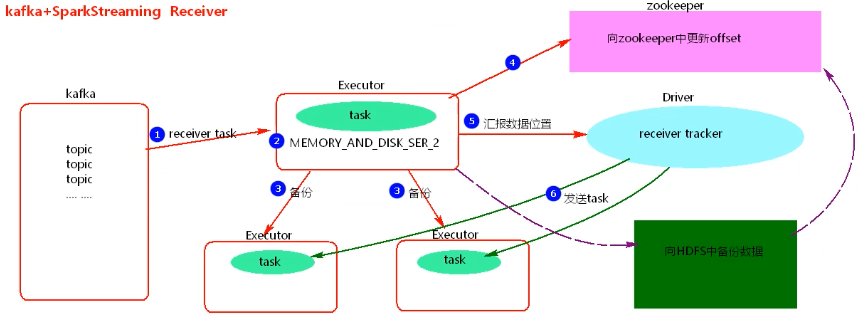
2.过程
1.使用Kafka的High Level Consumer API 实现,消费者不能自己去维护消费者offset,而且kafka也不关心数据是否丢失。
2.当向zookeeper中更新完offset后,Driver如果挂到,Driver下的Executors会被kill掉,会造成数据丢失。
3.开启WAL【Write Ahead Log】预写日志机制,将数据备份到HDFS中一份,再去更新zookeeper中的offset,此时需调整spark存储基本,去掉备份两次【MEMORY_AND_DISK_SER_2中的_2】。开启WAL机制会加大application处理的时间。
3.特点
1.receiver模式依赖zookeeper管理offset。
2.receiver模式的并行度由spark.streaming.blockInterval决定,默认是200ms。
3.receiver模式接收block.batch数据后会封装到RDD中,这里的block对应RDD中的partition。
4.在batchInterval一定的情况下,减少spark.streaming.Interval参数值,会增大DStream中的partition个数,建议spark.streaming.Interval最低不能低于50ms。
4.代码实现
package big.data.analyse.streaming

import org.apache.spark.storage.StorageLevel

import org.apache.spark.streaming.kafka.KafkaUtils

import org.apache.spark.streaming.{Seconds, StreamingContext}

import org.apache.spark.{SparkContext, SparkConf}

/**

  * Created by zhen on 2019/5/11.

  */

object SparkStreamingReceiverKafka {

  def main(args: Array[String]) {

    val conf = new SparkConf()

    conf.setAppName("SparkStreamingReceiverKafka")

    conf.set("spark.streaming.kafka.maxRatePerPartition", "")

    conf.setMaster("local[2]")

    val sc = new SparkContext(conf)

    sc.setLogLevel("WARN")

    val ssc = new StreamingContext(sc, Seconds()) // 创建streamingcontext入口

    val quorum = "master,worker1,worker2"

    val groupId = "zhenGroup"

    val map : Map[String, Int] = Map("zhenTopic" -> ) // topic名称为zhenTopic,每次使用1个线程读取数据

    val dframe = KafkaUtils.createStream(ssc, quorum, groupId, map, StorageLevel.MEMORY_AND_DISK_SER_2)

    dframe.foreachRDD(rdd => { // 操作方式和rdd类似,必须使用action算子才会触发程序执行!

      rdd.foreachPartition(partition =>{

        partition.foreach(println)

      })

    })

  }

}
SparkStreaming+kafka Receiver模式的更多相关文章
- 【Spark篇】---SparkStreaming+Kafka的两种模式receiver模式和Direct模式
一.前述 SparkStreamin是流式问题的解决的代表,一般结合kafka使用,所以本文着重讲解sparkStreaming+kafka两种模式. 二.具体 1.Receiver模式 原理图 ...
- SparkStreaming+Kafka 处理实时WIFI数据
业务背景 技术选型 Kafka Producer SparkStreaming 接收Kafka数据流 基于Receiver接收数据 直连方式读取kafka数据 Direct连接示例 使用Zookeep ...
- SparkStreaming+Kafka整合
SparkStreaming+Kafka整合 1.需求 使用SparkStreaming,并且结合Kafka,获取实时道路交通拥堵情况信息. 2.目的 对监控点平均车速进行监控,可以实时获取交通拥堵情 ...
- [Spark]Spark-streaming通过Receiver方式实时消费Kafka流程(Yarn-cluster)
1.启动zookeeper 2.启动kafka服务(broker) [root@master kafka_2.11-0.10.2.1]# ./bin/kafka-server-start.sh con ...
- 【SparkStreaming学习之四】 SparkStreaming+kafka管理消费offset
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk1.8 scala-2.10.4(依赖jdk1.8) spark ...
- Spark-Streaming kafka count 案例
Streaming 统计来自 kafka 的数据,这里涉及到的比较,kafka 的数据是使用从 flume 获取到的,这里相当于一个小的案例. 1. 启动 kafka Spark-Streaming ...
- Kafka KRaft模式探索
1.概述 Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者在网站中的所有动作流数据.其核心组件包含Producer.Broker.Consumer,以及依赖的Zookeeper集群. ...
- kafka单机模式部署安装,zookeeper启动
在root的用户下 1):前提 安装JDK环境,设置JAVA环境变量 2):下载kafka,命令:wget http://mirrors.shuosc.org/apache/kafka/0.10.2 ...
- java kafka单列模式生产者客户端
1.所需要的依赖 <?xml version="1.0" encoding="UTF-8"?> <project xmlns="ht ...
随机推荐
- apache Request-URI Too Large 处理办法
在Apache的httpd.conf配置文件中(直接加就可以) LimitRequestLine 40940 LimitRequestFieldSize 40940
- hive删除空分区
当hive中分区字段有NULL值时,hive会使用dynamic partition,数据会放到一个特殊的分区,这个分区由参数“hive.exec.default.partition.name”控制, ...
- LeetCode 110. Balanced Binary Tree(判断平衡二叉树)
Given a binary tree, determine if it is height-balanced. For this problem, a height-balanced binary ...
- shell基础知识7-字段分隔符与迭代器
什么是内部字段分隔符 内部字段分隔符(Internal Field Separator,IFS)是shell脚本编程中的一个重要概念.在处理 文本数据时,它的作用可不小. 作为分隔符,IFS有其特殊用 ...
- Unable to create application 异常
这个错误是空指针,但你怎么去找就是找不到为什么会空指针 这时,你要去检查Application 中是否有重写的方法例如这个 @Override protected void attachBaseC ...
- springboot 控制台程序读取配置文件(原创)
首先新建一个springboot项目,此处省略. 1.新建一个application.properties person.name=kevin person.age=6 person.sex=male ...
- 初识Java及所要准备的工作
整个Java学习路线 Java特点: 开源:源代码开放 跨平台:由于各平台有差异型,java由JVM对源代码进行解释执行,一次编译到处运行 Java的学习框架如下: JavaSE包括: 数据库包括: ...
- Hadoop 3.1.2 + Hive 3.1.1
一.安装Hadoop 1.1 版本说明 hadoop:3.1.2hive:3.1.1mysql:5.6.40 1.2 主机映射 添加IP与主机名的映射关系,在/etc/hosts文件里添加如下内容(所 ...
- jQuery.js引入时要在其他js文件之前,否则js中无法识别jQuery的语法
- JVM内存调优原则及几种JVM内存调优方法
转载,如需帮助,请联系wlgchun@163.com https://blog.csdn.net/LeegooWang/article/details/88696195 如何对JVM进行内存调优? ...