
cloudera learning2:HDFS
存入HDFS的文件会按块(block)划分,默认每块128MB。默认1个block还有2个备份。备份增加了数据的可靠性和提高计算效率(数据本地化)。
HDFS部署可选择不支持HA,也可选择支持HA。
NameNode内存中有metadata,metadata里主要记录的信息包括:file location,ownership,permissions,block's name and location。
metadata持久化在fsimage文件中,每次NameNode启动时加载到内存。Block location的信息并不存在fsimage中,而是启动后,dataNode定时发给NameNode.
对metadata进行的操作不仅保留在内存中,同时也会写到edit log文件中。当NameNode关闭后,内存中的metadata会消失,下次启动时,会动过edit log一条条还原所有的修改,这个过程导致NameNode启动非常的慢,后来增加了SecondaryNameNode,NameNode会定期的把fsimage和edit log传给Secondary NameNode. Secondary NameNode合并fsimage和log成为新的fsimg并传回NameNode,这样下次启动的时候,就可以只读fsimage了,大大减少启NameNode启动时间。每次SecondaryNameNode对fsimage的update叫做一次checkpoint。
SecondaryNameNode并不是NameNode的failover Node,只是它的“小秘书”。
SecondaryNameNode只在非HA的模式下存在,应该安装在与NameNode不同的机器上,SecondaryNameNode同样需要NameNode一样多的内存。
HDFS的HA是为了解决NameNode的单点问题。两个NameNode一个active,一个standby。standby负责checkpoint.
DataNode控制block的访问权限并保持与NameNode的通信。
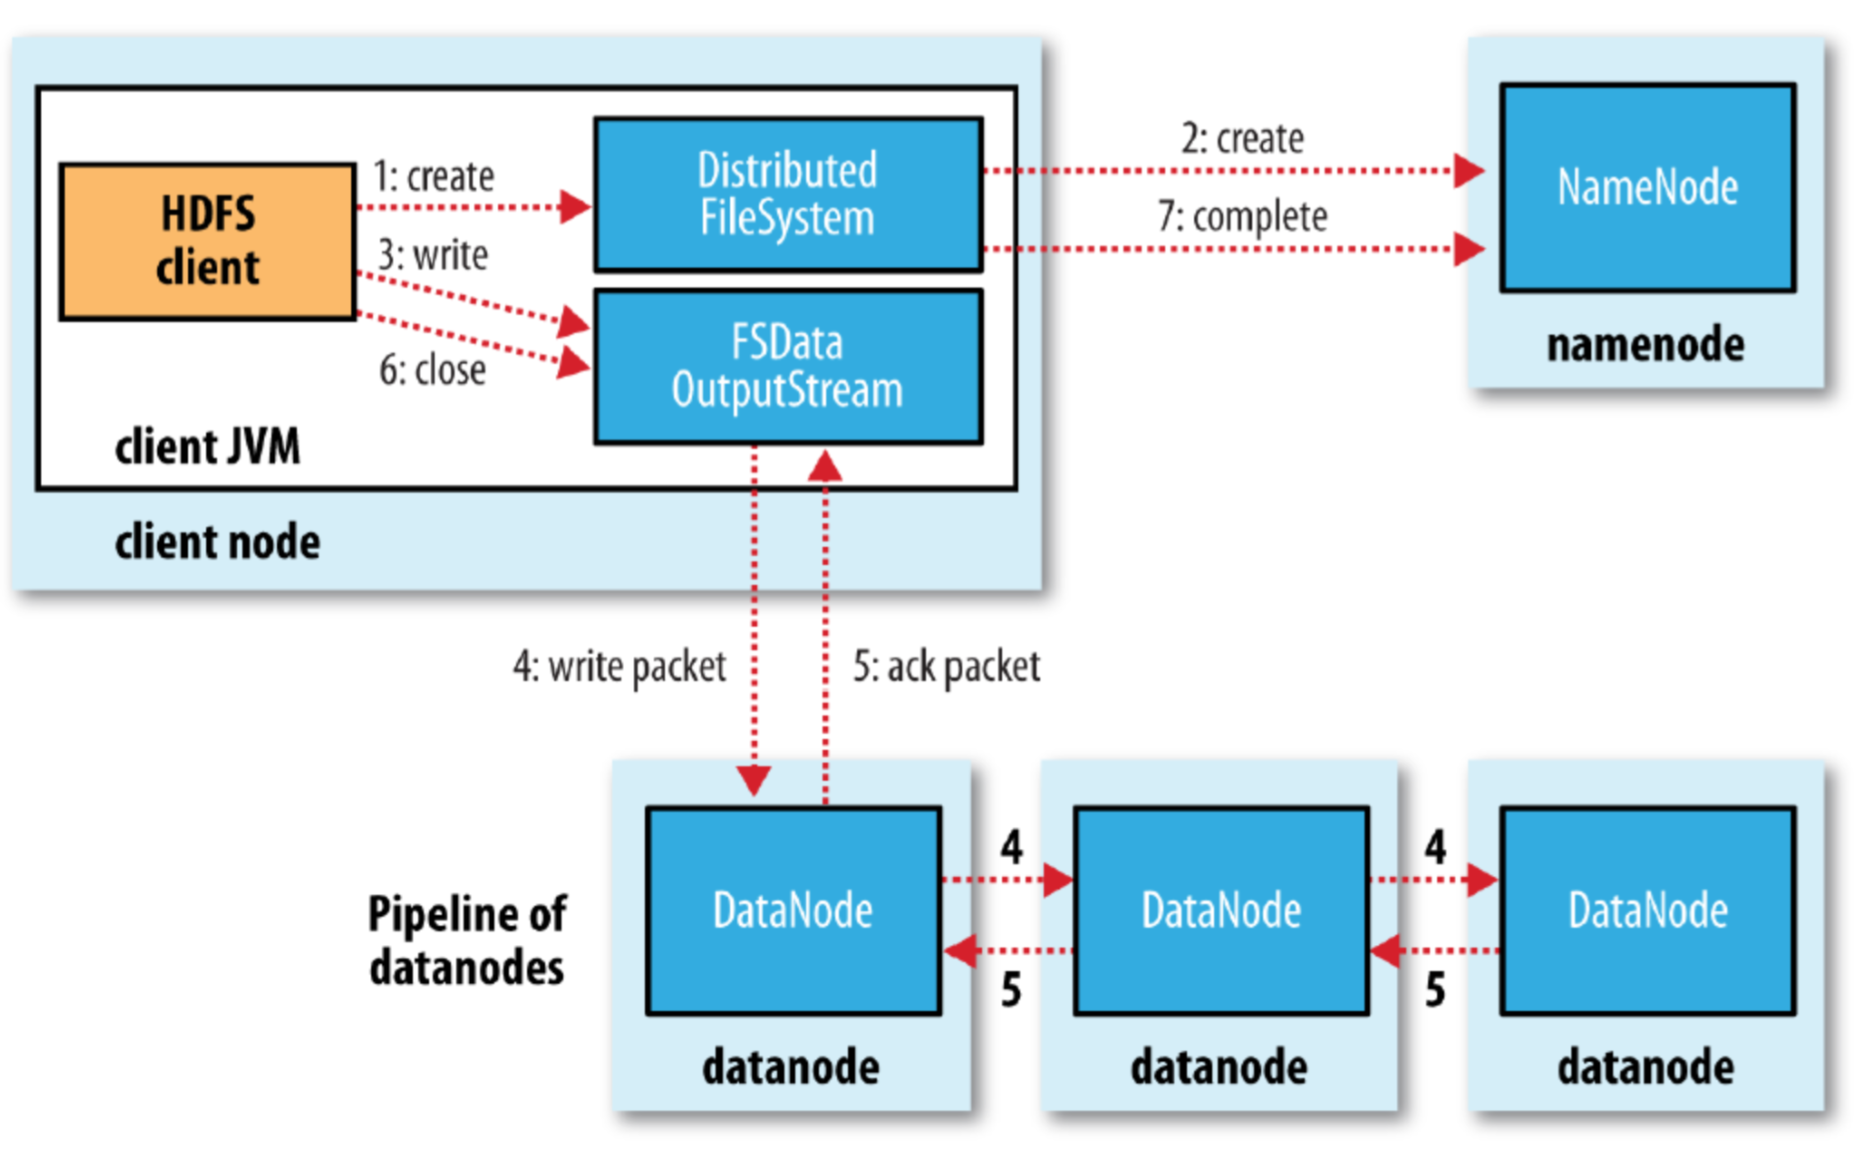
1.client connect to NameNode。
2.NameNode在metadata中为要写入的文件建立一条记录并返回可以写入的blockname和dataNode lists给client。
3.client connect 第一个DataNode,send data。
4.第一个DataNode接收到data后connect第二个DataNode,send data.
5.第二个DataNode又connect第三个dataNode,send data。
6.请求写入结果,并返回给client
7.client向NameNode发送写入完成信息。
在写入的过程中,如果第一个DataNode的pipeline断掉了,会有一个新的pipline建立起来,向第二个dataNode继续写。NameNode会继续找新的dataNode进行备份。
在block被写入时,client会对每一个block计算checksum同时发给dataNode,从而保持数据的完整性。
HDFS读数据流程:

1.client connect to NameNode。
2.Namenode返回要读出的数据所存放的datanode list(list中datanode的排序安照离client又近到远)和开头的几个block的名字。
3.client链接datanode读取数据,如果第一个datanode失去链接,则client去链接list中下一个datanode。
读取的过程中同样执行checksum。
Hadoop是机架感知的,在配好机架信息的前提下,hdfs的备份会存放在不同的机架。
DataNode每隔三秒向NameNode发送一次heartbeat,表示自己是health的。如果一段时间内NameNode没有收到某DataNode发送的heartbeat,则可认定这个DataNode lost,NameNode会把改dataNode上存储的blocks再在系统里进行一次备份,保证每个block的3备份。
Data never travels via a Namedata.
NameNode运行时,所有的metadata都在内存中,默认的NameNode堆大小为1G。1G的内存可以hold住1million的hdfs block。
cloudera learning2:HDFS的更多相关文章
- cloudera hbase集群简单思路
文章copy link:http://cloudera.iteye.com/blog/889468 链接所有者保留所有权! http://www.csdn.net/article/2013-05-10 ...
- hadoop cdh 4.5的安装配置
春节前用的shark,是从github下载的源码,自己编译.shark的master源码仅支持hive 0.9,支持hive 0.11的shark只是个分支,不稳定,官方没有发布release版,在使 ...
- Apache Pig处理数据示例
Apache Pig是一个高级过程语言,可以调用MapReduce查询大规模的半结构化数据集. 样例执行的环境为cloudera的单节点虚拟机 读取结构数据中的指定列 在hdfs上放置一个文件 [cl ...
- Hadoop-Impala学习笔记之入门
CDH quickstart vm包含了单节点的全套hadoop服务生态,可从https://www.cloudera.com/downloads/quickstart_vms/5-13.html下载 ...
- cdh日常维护常见问题及解决方案
为数据节点添加新硬盘 - 挂载硬盘到指定文件夹.如`/dfs_diskb`: - 打开cloudera manager -> hdfs -> 配置 -> DataNode -> ...
- 《ProgrammingHive》阅读笔记-第二章
书本第二章的一些知识点,在cloudera-quickstart-vm-5.8.0-0上进行操作. 配置文件 配置在/etc/hive/conf/hive-site.xml文件里面,采用mysql作为 ...
- Apache Hive处理数据示例
继上一篇文章介绍如何使用Pig处理HDFS上的数据,本文将介绍使用Apache Hive进行数据查询和处理. Apache Hive简介 首先Hive是一款数据仓库软件 使用HiveQL来结构化和查询 ...
- CDH 5.16.1 离线部署 & 通过 CDH 部署 Hadoop 服务
参考 Cloudera Enterprise 5.16.x Installing Cloudera Manager, CDH, and Managed Services Installation Pa ...
- Hello World on Impala
Cloudera Impala 官方教程 <Impala Tutorial>,解说了Impala一些基本操作,但操作步骤前后缺少连贯性,本文节W选<Impala Tutorial&g ...
随机推荐
- spring 的IoC的个人理解
1.ioc IoC的概念介绍 ( a).依赖注入, 分为依赖 和 注入 , 其实依赖是一种耦合方式, 通过spirng在运行时将这种依赖关系完成, 达到解耦目的, 同时达到代码重用, 方便测试,更加 ...
- 最小生成树的Kruskal算法实现
最近在复习数据结构,所以想起了之前做的一个最小生成树算法.用Kruskal算法实现的,结合堆排序可以复习回顾数据结构.现在写出来与大家分享. 最小生成树算法思想:书上说的是在一给定的无向图G = (V ...
- mac 下 用 glfw3 搭建opengl开发环境
mac 下 用 glfw3 搭建opengl开发环境 下载编译 glfw3 Build Setting 里面, Library Search Paths -> 设置好编译 glfw 库的路径 H ...
- 关于mat2gray
最小的是0,最大的是1,那么介于中间的那些值我们怎么处理? 那么事实上我们试了很多样例之后.. 我猜他是..每个步长step_length=1/(max-min+1) 然后每个值就会变成(val-1) ...
- MIT 6.828 JOS学习笔记5. Exercise 1.3
Lab 1 Exercise 3 设置一个断点在地址0x7c00处,这是boot sector被加载的位置.然后让程序继续运行直到这个断点.跟踪/boot/boot.S文件的每一条指令,同时使用boo ...
- foreach的用法
using System; using System.Collections.Generic; using System.Linq; using System.Text; using System.T ...
- 一把鼻涕一把泪 搭建公网ftp服务器
至于为什么要搭建公网ftp服务器,就当我心血来潮吧. ftp开源工具很多,咱用的是filezilla服务器.后来为了方便搭建web服务器,就改成了集成工具xampp.客户端工具也是filezilla ...
- 【BZOJ4008】[HNOI2015]亚瑟王 期望
[BZOJ4008][HNOI2015]亚瑟王 Description 小 K 不慎被 LL 邪教洗脑了,洗脑程度深到他甚至想要从亚瑟王邪教中脱坑. 他决定,在脱坑之前,最后再来打一盘亚瑟王.既然是最 ...
- Java的序列化ID的作用
Java的序列化ID的作用 简单来说,Java的序列化机制是通过在运行时判断类的serialVersionUID来验证版本一致性的.在进行反序列化时,JVM会把传来的字节流中的serialVersio ...
- 免费领取百度云盘2048G永久空间,永久离线下载特权
百度云盘和360云盘之间的竞争可谓争锋相对,前段时间,百度和360就网盘免费都采取了自己的措施,最终,360一锤定音,直接免费送36T,并且如果你超过了36T的容量,还可以自动免费扩容! 可参看文章: ...