
python—RE正则表达式
re正则表达式
正则表达式(或 RE)是一种小型的、高度专业化的编程语言,(在Python中)它内嵌在Python中,并通过 re 模块实现。正则表达式模式被编译成一系列的字节码,然后由用 C 编写的匹配引擎执行。
一、正则表达式的作用
1、给字符串进行模糊匹配,和其它的数据类型没有任何关系
2、对象就是字符串
二、字符匹配(普通字符,元字符)
1.普通字符:数字字符和英文字母和自身匹配
2.元字符:. ^ $ * + ? {} [] () | \
import re
re.方法("规则","匹配的字符串")
. 匹配任意一个字符,除了\n换行符
三、匹配规则

四、使用前需先导入re模块
import re
分别示例:
1、re.findall的使用(配合元字符)
(匹配的规则, 字符串) # 找到所有的匹配元素,返回列表
示例1:. 的作用:匹配任意的意思(一个点代表一个字符,有多个字符,就用多个点代替)
import re

# . :匹配除\n以外的任意符号

print(re.findall("a.+d","abcd"))#匹配的是第一个字母是a,中间是任意字符有1至无穷个,最后一个字母是b
执行结果是:
['abcd']
补充拓展:
1 re.findall("a..x","adsfaeyxsk19") #匹配以a开头,以x结尾的字符
执行结果:
1 ['aeyx']
示例2:^:从字符串开始位置匹配;$:从字符串结尾匹配
# ^:从字符串开始位置匹配

# $:从字符串结尾匹配

import re

print(re.findall("^yuan","yuandashj342jhg234"))#以yuan开始

print(re.findall("yuan$","yuandashj342jhg234yuan"))#以yuan结尾
执行结果是:
['yuan']

['yuan']
示例3:{} 想取多少次,就取多少次
# * + ?  {} :这4个都表达的是重复

print(re.findall("a.*d","abcd"))#匹配的是第一个字母是a,中间是任意字符有0至无穷个,最后一个字母是b

print(re.findall("a.+d","abcshsjd"))#匹配的是第一个字母是a,中间是任意字符有1至无穷个,最后一个字母是b

print(re.findall("a?d","bdkaaaad"))#匹配的a有0至1个

print(re.findall("[0-9]{4}","af5324jh523hgj34gkhg53453"))#匹配的是在[0-9]中取一个数字,取出4个
执行结果是:
['abcd']

['abcshsjd']

['d', 'ad']

['5324', '5345']
补充:
{0,} ==*
1 re.findall("alex{1,}","asdhfalexx")
执行结果:
1 ['alexx']
{1,}==+
1 re.findall("alex{0,}","asdhfalexx")
执行结果:
1 ['alexx']
{0,1}==?
1 re.findall("alex{0,1}","asdhfalexx")
执行结果:
1 ['alex']
{6} 重复6次
1 re.findall("alex{6}","asdhfalexxxxxx")
执行结果:
1 ['alexxxxxx']
{0,6} 重复1,2,3,4,5,6
1 re.findall("alex{0,6}","asdhfalexx")
执行结果:
1 ['alexx']
示例4:字符集 []: 起一个或者的意思
# 字符集 []: 起一个或者的意思

print(re.findall("a[bc]d","hasdabdjhacd"))#匹配的是第一个字母是a,第二个是b或者c,最后一个是d
执行结果是:
['abd', 'acd']
#注意: 在字符集[]内,* ,+和.等元字符都是普通符号,没有任何意义,除了 - ^ \有特殊意义,[^] 就是不是他的都匹配上

示例5:#注意: 在字符集[]内,* ,+和.等元字符都是普通符号,没有任何意义,除了 - ^ \有特殊意义,[^] 就是不是他的都匹配上
# 字符集 []: 起一个或者的意思

print(re.findall("a[bc]d","hasdabdjhacd"))#匹配的是第一个字母是a,第二个是b或者c,最后一个是d

#注意: 在字符集[]内,* ,+和.等元字符都是普通符号,没有任何意义,除了 - ^ \有特殊意义

print(re.findall("[0-9]+","dashj342jhg234"))#-在里面是取范围的意思,表示取数字[0-9]中的一个有1至无穷次

print(re.findall("[a-z]+","dashj342jhg234"))#-在里面是取范围的意思,表示取字母[a-z]中的一个有1至无穷次

print(re.findall("[^\d]+","d2a2fhj87fgj"))#^表示的是“非”的意思,匹配的是,非任何数字的,且出现1至无穷次

print(re.findall("[\^\d]","d2a2fhj87fgj"))#第一个\是转义的意思,表示的是不是“非”的数字的意思

print(re.findall("[a.b]","d2a2.fhj87fgj"))#.在里面就是普通字符
执行结果是:
['abd', 'acd']

['342', '234']

['dashj', 'jhg']

['d', 'a', 'fhj', 'fgj']

['2', '2', '8', '7']

['a', '.']
示例6:(关于贪婪匹配和非贪婪匹配)
#贪婪匹配

print(re.findall("\d+","af5324jh523hgj34gkhg53453"))#匹配的是数字有1至无穷个

# #非贪婪匹配

print(re.findall("\d+?","af5324jh523hgj34gkhg53453"))#匹配的是数字有0-1个
执行结果是:
['5324', '523', '34', '53453']

['5', '3', '2', '4', '5', '2', '3', '3', '4', '5', '3', '4', '5', '3']
示例7:():分组,特点是只要匹配到了就不往下走了
# ():分组,特点是只要匹配到了就不往下走了

print(re.findall("(ad)+","adad"))#匹配的是ad出现1至无穷次

print(re.findall("(ad)+yuan","adyuangfsdui"))#匹配的是ad出现1至无穷次,且后面是yuan

print(re.findall("(?:ad)+yuan","addyuangfsdui"))#?:表示的是取消优先级,因为涉及到分组,优先把分组内容显示出来,匹配的只是分组的内容

print(re.findall("(\d)+yuan","adad678423yuang4234fsdui"))#匹配的是数字有1至无穷个
执行结果是:
['ad']

['ad']

[]

['3']
示例8:| :或
 # |  :或

print(re.findall("www\.(?:oldboy|baidu)\.com","www.oldboy.com"))
执行结果是:
['www.oldboy.com']
示例9:\:转义符号
(1) 后面加一个元字符使其变成普通符号 \. \*(可以将有特殊符号变成普通符号)
(2)将一些普通符号变成特殊符号 比如 \d(表示的是数字)\w(表示的是任意数字和字母,符号不算)
# \:转义符号

# 1 后面加一个元字符使其变成普通符号 \.  \*(可以将有特殊符号变成普通符号)

# 2 将一些普通符号变成特殊符号 比如 \d(表示的是数字)\w(表示的是任意数字和字母,符号不算)

print(re.findall("\d+\.?\d*\*\d+\.?\d*","-2*6+7*45+1.456*3-8/4"))

#\d+\.?\d*表示的是数字有1至无穷个,小数点有0至1个,小数点后面的数字有0至无穷个

#\*是将*号之前的代表0至无穷个变成普通的字符乘号的意思

#\d+\.?\d*表示的是数字有1至无穷个,小数点有0至1个,小数点后面的数字有0至无穷个

print(re.findall("\w","$da@s4 234"))#匹配任意的字母和数字
执行结果是:
['2*6', '7*45', '1.456*3']

['d', 'a', 's', '4', '2', '3', '4']
示例10:
1 re.findall("\S+","hello world") #\S 匹配非空的字符
执行结果:
1 ['hello', 'world']
示例11:
(1)
1 re.findall(r"I\b","I am LIST") re的r =\\ ,就相当转义两次
执行结果:
1 ['I']
(2)
1 re.findall("I\\b","I am LIST") #\\转义字符
执行结果:
1 ['I']
(3)python解释器\\ 两个,re转义\\ 两个,所以是\\\\ 四个
1 re.findall("c\\\\l","abc\lerwt") #同时匹配c和l
执行结果:
1 ['c\\l']
(4)
1 re.findall(r"c\\l","abc\lerwt") #同时匹配c和l
执行结果:
1 ['c\\l']
以上都是re.findall的使用,返回的都是列表的形式
re模块下的常用方法
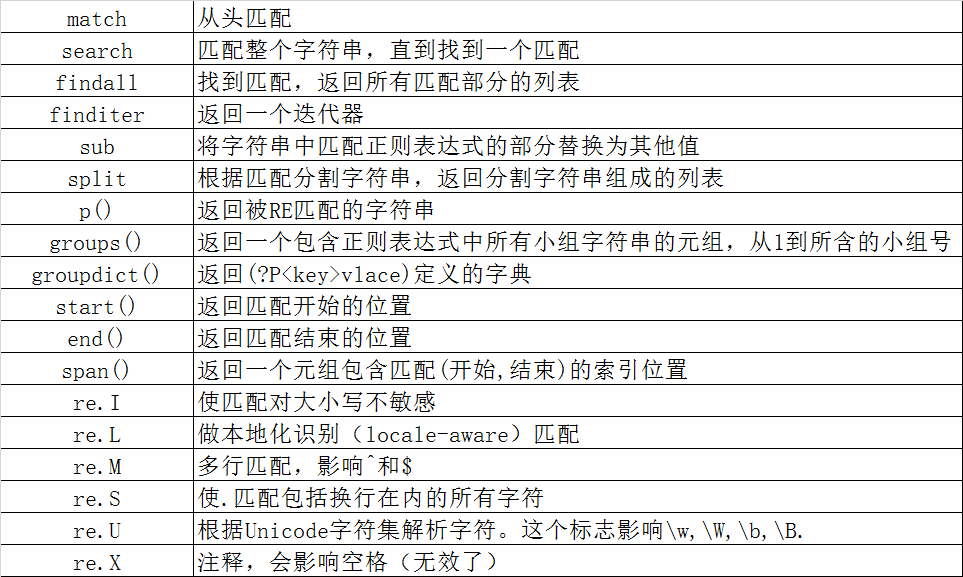
2、re.finditer的使用,返回的是可迭代的
使用方法:re.finditer(“规则”,“字符串”)
finditer(迭代器)当数据非常多的时候,他会把数据存在迭代器中,不会放在内存中,用一条处理一条。
示例:
# re.findall()

import re

s=re.finditer("\d+","ad324das32")#匹配数字有1至无穷个

print(s)#s是迭代器

print(next(s).group())#next一下,取一个值

print(next(s).group())
执行结果是:
<callable_iterator object at 0x00000000021F4048>

324

32
3、search;查找,只匹配第一个结果,找到了就不继续了(search 函数会在字符串内查找模式匹配,只到找到第一个匹配然后返回一个包含匹配信息的对象,该对象可以
通过调用group()方法得到匹配的字符串,如果字符串没有匹配,则返回None。)
示例:
# search;只匹配第一个结果

ret=re.search("\d+","djksf34asd3")

print(ret.group())
执行结果是:
34
4、match:只在字符串开始的位置匹配
示例:
##match:只在字符串开始的位置匹配

ret=re.match("\d+","423djksf34asd3")

print(ret.group())
执行结果是:
423
re.match与re.search的区别
re.match只匹配字符串的开始,如果字符串开始不符合正则表达式,则匹配失败,函数返回None;而re.search匹配整个字符串,直到找到一个匹配。
5、split 分割
示例:
#split 分割

s2=re.split("\d+","fhd3245jskf54skf453sd")

print(s2)

s2=re.split("\d+","fhd3245jskf54skf453sd",2)#2是指分隔的次数

print(s2)

ret3=re.split("l","hello yuan")

print(ret3)
执行结果是:
['fhd', 'jskf', 'skf', 'sd']

['fhd', 'jskf', 'skf453sd']

['he', '', 'o yuan']
6、sub 替换
示例:
# #sub: 替换

#

ret4=re.sub("\d+","A","hello 234jkhh23")#将数字替换成A

print(ret4)

ret4=re.sub("\d+","A","hello 234jkhh23",1)#1表示的是将第一串数字替换成A

print(ret4)
执行结果:
hello AjkhhA

hello Ajkhh23
补充:
subn 第一个匹配元组,第二个匹配次数
示例:
ret=re.subn('\d','A','alvin5yuan6')    #将数字替换成A

print(ret)#打印的第一个是匹配元组,第二个匹配替换的次数是2次

ret=re.subn("\d", "A", "jaskd4234ashdjf5423")  # 第一个匹配元组,第二个匹配次数,8次

print(ret)
执行结果是:
('alvinAyuanA', 2)

('jaskdAAAAashdjfAAAA', 8)
7、re.compile 编译方法
示例:
#compile: 编译方法

c=re.compile("\d+")

ret5=c.findall("hello32world53") #相当于是re.findall("\d+","hello32world53")

print(ret5)
执行结果是:
['32', '53']
五、生产环境常见正则示例:
1、匹配手机号
1 phone_num = '13001000000'

2 a = re.compile(r"^1[\d+]{10}")

3 b = a.match(phone_num)

4 print(b.group())
2、匹配IPv4
1 # 匹配IP地址

2 ip = '192.168.1.1'

3 a = re.compile(r"(((1?[0-9]?[0-9])|(2[0-4][0-9])|(25[0-5]))\.){3}((1?[0-9]?[0-9])|(2[0-4][0-9])|(25[0-5]))$")

4 b = a.search(ip)

5 print(b)
3、匹配E-mail
1 email = '630571017@qq.com'

2 a = re.compile(r"(.*){0,26}@(\w+){0,20}.(\w+){0,8}")

3 b = a.search(email)

4 print(b.group())
python—RE正则表达式的更多相关文章
- [python] 常用正则表达式爬取网页信息及分析HTML标签总结【转】
[python] 常用正则表达式爬取网页信息及分析HTML标签总结 转http://blog.csdn.net/Eastmount/article/details/51082253 标签: pytho ...
- Python 进阶 - 正则表达式
1. 正则表达式基础 1.1. 简单介绍 正则表达式并不是Python的一部分.正则表达式是用于处理字符串的强大工具,拥有自己独特的语法以及一个独立的处理引擎,效率上可能不如str自带的方法,但功能十 ...
- python study - 正则表达式
第 7 章 正则表达式 7.1. 概览 7.2. 个案研究:街道地址 7.3. 个案研究:罗马字母 7.3.1. 校验千位数 7.3.2. 校验百位数 7.4. 使用 {n,m} 语法 7.4.1. ...
- python使用正则表达式文本替换
2D客户端编程从某种意义上来讲就是素材组织,所以,图片素材组织经常需要批量处理,python一定是最佳选择,不管是win/linux/mac都有一个简单的运行环境 举两个应用场景: 如果不是在某个文件 ...
- python的正则表达式 re
python的正则表达式 re 本模块提供了和Perl里的正则表达式类似的功能,不关是正则表达式本身还是被搜索的字符串,都可以是Unicode字符,这点不用担心,python会处理地和Ascii字符一 ...
- Python之正则表达式(re模块)
本节内容 re模块介绍 使用re模块的步骤 re模块简单应用示例 关于匹配对象的说明 说说正则表达式字符串前的r前缀 re模块综合应用实例 正则表达式(Regluar Expressions)又称规则 ...
- Python:正则表达式详解
正则表达式是一个很强大的字符串处理工具,几乎任何关于字符串的操作都可以使用正则表达式来完成,作为一个爬虫工作者,每天和字符串打交道,正则表达式更是不可或缺的技能,正则表达式的在不同的语言中使用方式可能 ...
- 【Python】正则表达式纯代码极简教程
<Python3正则表达式>文字版详细教程链接:https://www.cnblogs.com/leejack/p/9189796.html ''' 内容:Python3正则表达式 日期: ...
- 【Python】正则表达式简单教程
说明:本文主要是根据廖雪峰网站的正则表达式教程学习,并根据需要做了少许修改,此处记录下来以备后续查看. <Python正则表达式纯代码极简教程>链接:https://www.cnblogs ...
- 【转】Python之正则表达式(re模块)
[转]Python之正则表达式(re模块) 本节内容 re模块介绍 使用re模块的步骤 re模块简单应用示例 关于匹配对象的说明 说说正则表达式字符串前的r前缀 re模块综合应用实例 参考文档 提示: ...
随机推荐
- MySQL & export
MySQL & export mysql export table form command line https://cn.bing.com/search?q=mysql%20export% ...
- 【hdu4734】F(x) 数位dp
题目描述 对于一个非负整数 $x=\overline{a_na_{n-1}...a_2a_1}$ ,设 $F(x)=a_n·2^{n-1}+a_{n-1}·2^{n-2}+...+a_2·2^1+ ...
- 【bzoj1030】[JSOI2007]文本生成器 AC自动机+dp
题目描述 JSOI交给队员ZYX一个任务,编制一个称之为“文本生成器”的电脑软件:该软件的使用者是一些低幼人群,他们现在使用的是GW文本生成器v6版.该软件可以随机生成一些文章―――总是生成一篇长度固 ...
- main方法为什么是静态的
main函数其实也是所在类的一个方法,就比如一个类是test,那么该类的main其实就是test.main(String[] args),众所周知如果一个方法不是静态的,则要先实例化该类,比如要这样 ...
- 用select模拟一个socket server
1, 必须在非阻塞模式下,才能实现IO的多路复用,否则一个卡住就都卡住了.(单线程下的多路复用) 先检测自己,现在没有客户端连进来,所以会卡住. # 用select去模拟socket,实现单线程下的多 ...
- 【题解】HNOI2014世界树
脑子不清醒的时候千万别写题.写题写不下去了千万别死扛,重构才是你唯一的出路QAQ 昨天很想快点写道题,思路没有很清晰的时候就写了,结果……今天一怒之下决定重整思路重构代码,其实不过是半个小时的事情…… ...
- 【题解】SHOI2014概率充电器
首先发现答案就是每个节点有电的概率之和.有电的概率牵扯太广不好求,所以转化为求没有电的概率.这题最难的部分在于:一个节点如果有电,可以来自儿子,也可以来自父亲.我们考虑将这两个部分分离开来:建立状态 ...
- 【刷题】BZOJ 4516 [Sdoi2016]生成魔咒
Description 魔咒串由许多魔咒字符组成,魔咒字符可以用数字表示.例如可以将魔咒字符 1.2 拼凑起来形成一个魔咒串 [1,2]. 一个魔咒串 S 的非空字串被称为魔咒串 S 的生成魔咒. 例 ...
- 洛谷 P1311 选择客栈 解题报告
P1311 选择客栈 题目描述 丽江河边有 \(n\) 家很有特色的客栈,客栈按照其位置顺序从 \(1\) 到 \(n\) 编号.每家客栈都按照某一种色调进行装饰(总共 \(k\) 种,用整数 \(0 ...
- BZOJ:2460[BeiJing2011]元素 (异或基+贪心)
2460: [BeiJing2011]元素 Time Limit: 20 Sec Memory Limit: 128 MBSubmit: 2910 Solved: 1535 题目链接:https: ...