
关于PCA降维中遇到的python问题小结
由于论文需要,开始逐渐的学习CNN关于文本抽取的问题,由于语言功底不好,所以在学习中难免会有很多函数不会用的情况..... ̄へ ̄
主要是我自己的原因,但是我更多的把语言当成是一个工具,需要的时候查找就行~~~~但是这也仅限于搬砖的时候,大多数时候如果要自己写代码,这个还是行不通的。
简单的说一下在PCA,第一次接触这个名词还是在学习有关CNN算法时,一篇博客提到的数据输入层中,数据简单处理的几种方法之一,有提到PCA降维,因为论文需要CNN做一些相关的工作,想做一篇综述类文章,所以思路大概是这样:CNN处理文本历史,CNN处理文本的概述,基本方法,常用框架,具体方法,方法优劣确定,未来研究趋势。
在查看相关常用框架的时候,才发现还有很多没有学过,(キ`゚Д゚´)!!,于是乎,抓紧吧~
PCA(Principal Component Analysis)主成分分析法
在数据处理中,经常会遇到特征维度比样本数量多得多的情况,如果拿到实际工程中去跑,效果不一定好。一是因为冗余的特征会带来一些噪音,影响计算的结果;二是因为无关的特征会加大计算量,耗费时间和资源。所以我们通常会对数据重新变换一下,再跑模型。数据变换的目的不仅仅是降维,还可以消除特征之间的相关性,并发现一些潜在的特征变量。
目的:
PCA是一种在尽可能减少信息损失的情况下找到某种方式降低数据的维度的方法。通常来说,我们期望得到的结果,是把原始数据的特征空间(n个d维样本)投影到一个小一点的子空间里去,并尽可能表达的很好(就是说损失信息最少)。常见的应用在于模式识别中,我们可以通过减少特征空间的维度,抽取子空间的数据来最好的表达我们的数据,从而减少参数估计的误差。注意,主成分分析通常会得到协方差矩阵和相关矩阵。这些矩阵可以通过原始数据计算出来。协方差矩阵包含平方和与向量积的和。相关矩阵与协方差矩阵类似,但是第一个变量,也就是第一列,是标准化后的数据。如果变量之间的方差很大,或者变量的量纲不统一,我们必须先标准化再进行主成分分析。(这里引用了一个大哥的文档,写的真的很漂亮,https://www.cnblogs.com/charlotte77/p/5625984.html)
简单介绍一下,详细的可以看这篇博客,关于PCA降维的方法什么的都在里面,我主要在学习这篇的时候关于语言方面有些小障碍,所以能看懂上面,我这也就基本不用看了~
在第一个问题中:
mu_vec1 = np.array([0,0,0])
cov_mat1 = np.array([[1,0,0],[0,1,0],[0,0,1]])

np.random.multivariate_normal(mu_vec1, cov_mat1, 20).T
#def multivariate_normal(mean, cov, size=None, check_valid=None, tol=None)
这段代码中,开始的时候对语法掌握不熟悉,定义部分在注释展示出了,主要的目的是生成随机数组,mean和cov是必须填写的参数,mean为一维数组,cov为协方差矩阵,size为生成随机数组的时候,具体的长度,比如size=20,则第一行元素就一共有20个;check_valid主要是为了检验是否为协方差矩阵,有三种写法:
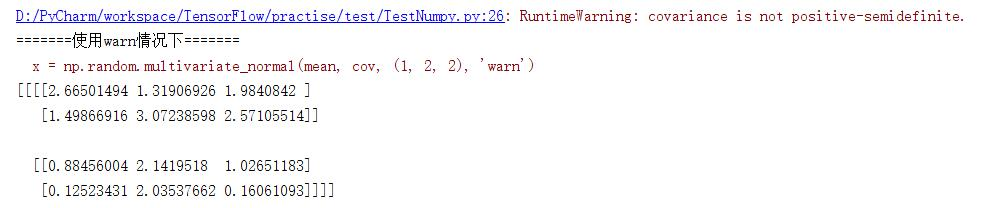
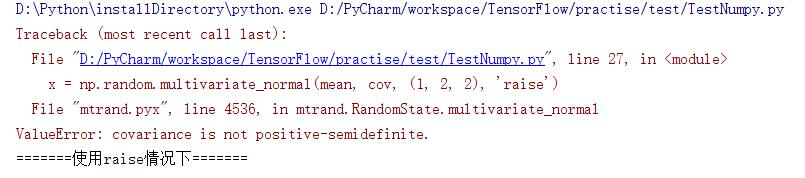
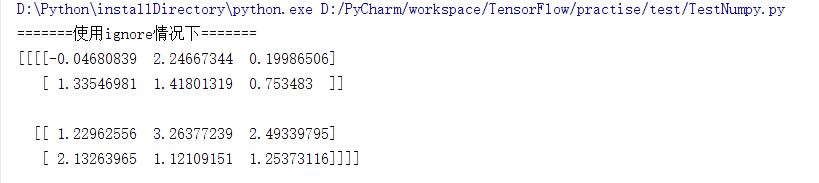
warn,raise以及ignore。当使用warn作为传入的参数时,如果cov不是半正定的程序会输出警告但仍旧会得到结果;当使用raise作为传入的参数时,如果cov不是半正定的程序会报错且不会计算出结果;当使用ignore时忽略这个问题即无论cov是否为半正定的都会计算出结果。3种情况的console打印结果如下:
使用warn时:
使用raise时:
使用ignore时:
tol:检查协方差矩阵奇异值时的公差,float类型。
这个问题算是解决了~下一个:
class1_sample[0,:]和class1_sample[:,0]
X[:,0]是numpy中数组的一种写法,表示对一个二维数组,取该二维数组第一维中的所有数据,第二维中取第0个数据,直观来说,X[:,0]就是取所有行的第0个数据, X[:,1] 就是取所有行的第1个数据。
import numpy as np
X = np.array([[0, 1], [2, 3], [4, 5], [6, 7], [8, 9], [10, 11], [12, 13], [14, 15], [16, 17], [18, 19]])
print(X[:, 0])
为例
X[:, 0]输出则为,[0,2,4,6,8,10,12,14,16,18]
X[:, 1]输出则为,[1,3,5,7,9,11,13,15,17,19]
X[0, :]输出则为,[0,1]
X[1, :]输出则为,[2,3]
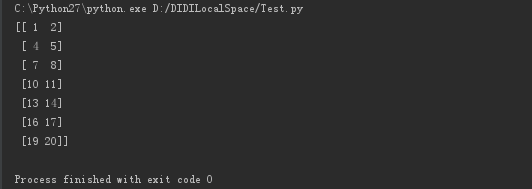
其中还有一个为X[:, m:n],即取所有数据的第m到n-1列数据,含左不含右
例:输出X数组中所有行第1到2列数据
- X = np.array([[0,1,2],[3,4,5],[6,7,8],[9,10,11],[12,13,14],[15,16,17],[18,19,20]])
- print X[:,1:3]
结果为:
第三个:
np.concatenate((class1_sample, class2_sample), axis=1)
其中主要对axis=0和axis=1的问题做一下笔记:
axis=0时:数组的拼接方式为首尾相连接
a = np.array([[1, 2], [3, 4]])
b = np.array([[5, 6]])
c = np.concatenate((a, b), axis=0)
输出为:
array([[1, 2],
[3, 4],
[5, 6]])
axis=1时:数组的拼接方式为在a的每行元素末尾添加b对应行元素。
a = np.array([[1, 2], [3, 4]])
b = np.array([[5, 6]])
c = np.concatenate((a, b), axis=1)
输出为:
array([[1, 2,3],
[4,5, 6]])
关于PCA降维中遇到的python问题小结的更多相关文章
- Python机器学习笔记 使用scikit-learn工具进行PCA降维
之前总结过关于PCA的知识:深入学习主成分分析(PCA)算法原理.这里打算再写一篇笔记,总结一下如何使用scikit-learn工具来进行PCA降维. 在数据处理中,经常会遇到特征维度比样本数量多得多 ...
- PCA降维的原理、方法、以及python实现。
PCA(主成分分析法) 1. PCA(最大化方差定义或者最小化投影误差定义)是一种无监督算法,也就是我们不需要标签也能对数据做降维,这就使得其应用范围更加广泛了.那么PCA的核心思想是什么呢? 例如D ...
- python机器学习使用PCA降维识别手写数字
PCA降维识别手写数字 关注公众号"轻松学编程"了解更多. PCA 用于数据降维,减少运算时间,避免过拟合. PCA(n_components=150,whiten=True) n ...
- 吴裕雄 python 机器学习——主成份分析PCA降维
# -*- coding: utf-8 -*- import numpy as np import matplotlib.pyplot as plt from sklearn import datas ...
- 深入学习主成分分析(PCA)算法原理(Python实现)
一:引入问题 首先看一个表格,下表是某些学生的语文,数学,物理,化学成绩统计: 首先,假设这些科目成绩不相关,也就是说某一科目考多少分与其他科目没有关系,那么如何判断三个学生的优秀程度呢?首先我们一眼 ...
- sklearn pca降维
PCA降维 一.原理 这篇文章总结的不错PCA的数学原理. PCA主成分分析是将原始数据以线性形式映射到维度互不相关的子空间.主要就是寻找方差最大的不相关维度.数据的最大方差给出了数据的最重要信息. ...
- 机器学习算法-PCA降维技术
机器学习算法-PCA降维 一.引言 在实际的数据分析问题中我们遇到的问题通常有较高维数的特征,在进行实际的数据分析的时候,我们并不会将所有的特征都用于算法的训练,而是挑选出我们认为可能对目标有影响的特 ...
- 奇异值分解(SVD)原理与在降维中的应用
奇异值分解(Singular Value Decomposition,以下简称SVD)是在机器学习领域广泛应用的算法,它不光可以用于降维算法中的特征分解,还可以用于推荐系统,以及自然语言处理等领域.是 ...
- [综] PCA降维
http://blog.json.tw/using-matlab-implementing-pca-dimension-reduction 設有m筆資料, 每筆資料皆為n維, 如此可將他們視為一個mx ...
随机推荐
- PHP二维数组,根据多个字段来排序
如果是最最常见的二维数组排序, 大多数情况下也只用到二维: 用php内置函数 array_multisort( ) 是最简单的: <?php 假设, $arr 是一个二维数组, $arg1是取 ...
- WPF dataGrid下的ComboBox的绑定
WPF dataGrid下的ComboBox的绑定 Wpf中dataGrid中的某列是comboBox解决这个问题费了不少时间,不废话了直接上代码 xaml 代码 <DataGridTempla ...
- Mach系统
——杂言:最近升级了把山狮升级到了10.9mavericks,比较抓我注意力的就是新的活动监视器.新的监视器里对统计分类很严,双击某一进程,即可跳出一个详情对话框.其中里面就有记录着Mach相关的信息 ...
- 【Java】Java程序员面试宝典(第三版)第5章----Java程序设计基本概念
1.static静态变量,在次级作用域也可以被修改. 2.k++ + k++.第一个自加实际上只有在与计算+k++时补增.详情P36的题目. 3.Java数据类型从低到高分为(byte short c ...
- svn merge和branch 详解
1.本地Repository的创建 repository的创建很简单,假设我要在D:\TortoiseSVN\TestRepository目录中创建repository,只需右键TestReposit ...
- PCL 不同类型的点云之间进行类型转换
PCL 不同类型的点云之间进行类型转换 可以使用PCL里面现成的函数pcl::copyPointCloud(): #include <pcl/common/impl/io.h> pcl:: ...
- Hive Joins 用法与操作
Hive表连接的语法支持如下: join_table: table_reference JOIN table_factor [join_condition] | table_reference {LE ...
- windows下primer3-py安装
primer3是由怀特黑德生物医学研究所Steve Rozen等人发起的一个自动寡核苷酸分析和设计的开源项目,被广泛应用在分子生物领域.primer3-py是用python语言封装的primer3的A ...
- idea调试SpringMvc, 出现:”javax.servlet.ServletException: java.lang.IllegalStateException: Cannot create a session after the response has been committed"错误的解决方法
调试拦截器出现以下错误: HTTP Status 500 - javax.servlet.ServletException: java.lang.IllegalStateException: Cann ...
- 【转载】Hyperledger学习小结
Hyperledger学习小结 自学Hyperledger Composer也有段时间了,是时候对所学的知识总结一下了.因为没有实际项目参与的话,差不多也就到此为止了.后续可能会去了解一下以太坊的技术 ...