
requests+多进程poll+pymongo实现抓取小说
今天看着有个很吸引人的小说作品信息:一家只在深夜开门营业的书屋,欢迎您的光临。
作为东野奎吾《深夜食堂》漫画的fans,看到这个标题按捺不住我的好奇心........
所以我又抓下来了,总共52章,下面有源码,写的有点乱哦,凑合看看,关键看结果,@~@。。。。
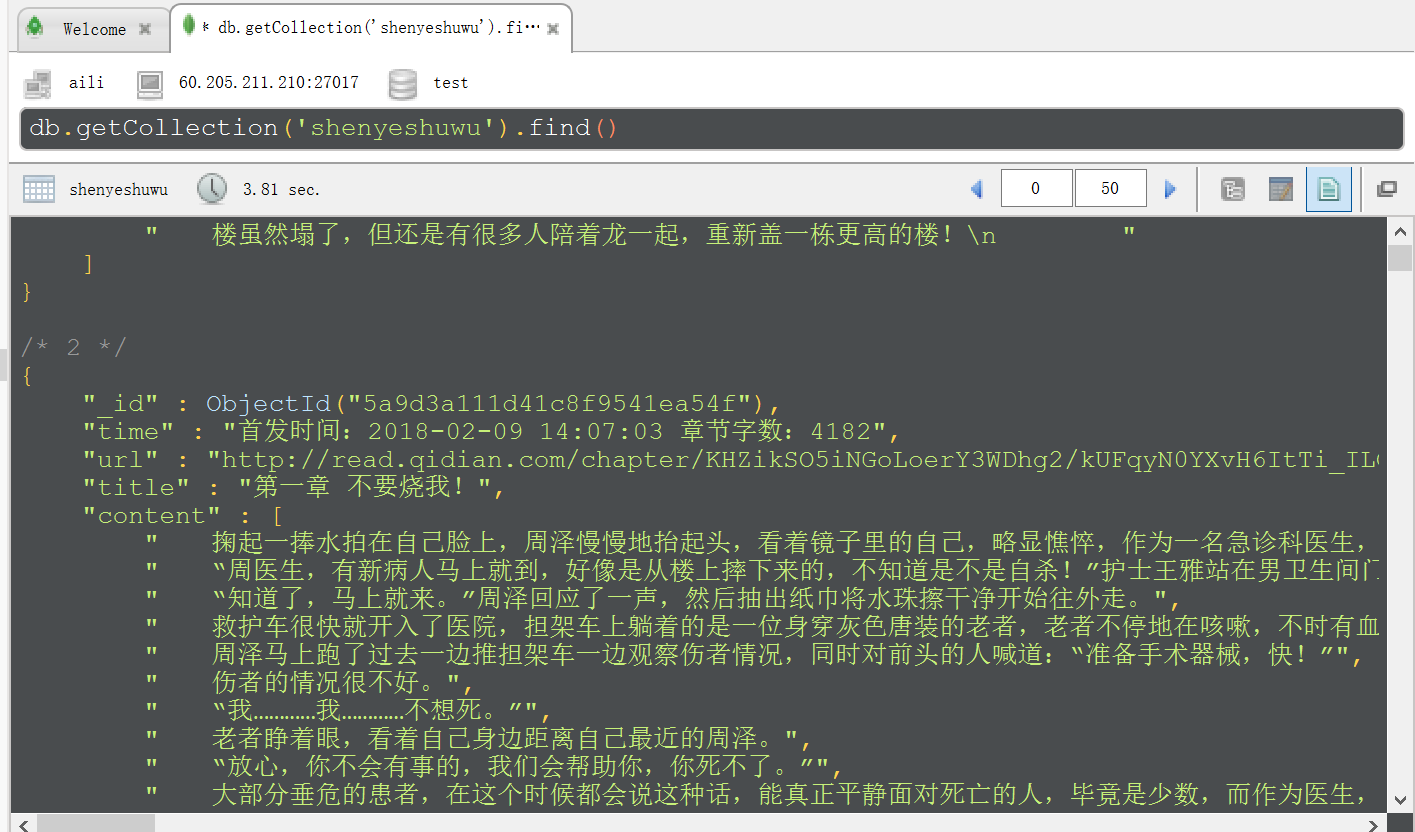
代码写完,几秒钟就抓取下来,比下载效率高不少,小激动~~~~~~
readme>>>环境python2,我的python2还有多长寿命;其他內库依赖见代码体现
# coding:utf-8

from multiprocessing import Pool

from lxml import etree

import requests

import pymongo

def save_mongo(data):

    client = pymongo.MongoClient('60.205.211.210',27017)

    db = client.test

    collection = db.shenyeshuwu

    collection.insert(dict(data))

    print('--------%s---------存储完毕' %data['title'])

def parse_content(url):

    resp = requests.get(url).content

    html = etree.HTML(resp)

    contents = html.xpath('//*[@id="j_chapterBox"]/div[2]/div/div[2]/p/text()|//*[@id="j_chapterBox"]/div[1]/div/div[2]/p/text()')

    return contents

def parse_html(html):

    '''

    [{

    'title':title,

    'url':url,

    'content':content

    }]

    '''

    page = etree.HTML(html)

    article_url_list = page.xpath('//ul[@class="cf"]/li/a')

    for i in article_url_list:

        url = 'http:' + i.xpath('./@href')[0]

        # print(url)

        title = i.xpath('./text()')[0]

        # print(title)

        time = i.xpath('./@title')[0]

        # print(time)

        con = parse_content(url)

        # print(con)

        data = {

            'url': url,

            'title': title,

            'time': time,

            'content': con

        }

        print(data)

        save_mongo(data)

def get_page(url):

    header = {

        'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.186 Safari/537.36'

    }

    resp = requests.get(url,headers=header).content

    parse_html(resp)

def main():

    url = 'https://book.qidian.com/info/1011335417#Catalog'

    # get_page(url)

    # 使用进程池  map(func,iterable)

    pool = Pool(4)

    # pool.map(parse_content,data)

    pool.apply_async(get_page,args=(url,))

    pool.close()

    pool.join()

if __name__ == '__main__':

    main()
如往常,把截图展示下:
requests+多进程poll+pymongo实现抓取小说的更多相关文章
- C# 爬虫 抓取小说
心血来潮,想研究下爬虫,爬点小说. 通过百度选择了个小说网站,随便找了一本小书http://www.23us.so/files/article/html/13/13655/index.html. 1. ...
- C# 爬虫 正则、NSoup、HtmlAgilityPack、Jumony四种方式抓取小说
心血来潮,想爬点小说.通过百度选择了个小说网站,随便找了一本小说http://www.23us.so/files/article/html/13/13655/index.html. 1.分析html规 ...
- Python抓取小说
Python抓取小说 前言 这个脚本命令MAC在抓取小说写,使用Python它有几个码. 代码 # coding=utf-8 import re import urllib2 import chard ...
- scrapy抓取小说
用scrapy建立一个project,名字为Spider scrapy startproject Spider 因为之前一直用的是电脑自带的python版本,所以在安装scrapy时,有很多问题,也没 ...
- python requests 模拟登陆网站,抓取数据
抓取页面数据的时候,有时候我们需要登陆才可以获取页面资源,那么我们需要登陆以后才可以跳转到对应的资源页面,那么我们需要通过模拟登陆,登陆成功以后再次去抓取对应的数据. 首先我们需要通过手动方式来登陆一 ...
- python爬虫之抓取小说(逆天邪神)
2022-03-06 23:05:11 申明:自我娱乐,对自我学习过程的总结. 正文: 环境: 系统:win10, python版本:python3.10.2, 工具:pycharm. 项目目标: 实 ...
- Python 爬虫-抓取小说《盗墓笔记-怒海潜沙》
最近想看盗墓笔记,看了一下网页代码,竟然不是js防爬虫,那就用简单的代码爬下了一节: """ 爬取盗墓笔记小说-七星鲁王宫 """ from ...
- Python 爬虫-抓取小说《鬼吹灯之精绝古城》
想看小说<鬼吹灯之精绝古城>,可是网页版的好多广告,还要一页一页的翻,还无法复制,于是写了个小爬虫,保存到word里慢慢看. 代码如下: """ 爬取< ...
- jsoup使用样式class抓取数据时空格的处理
最近在研究用android和jsoup抓取小说数据,jsoup的使用可以参照http://www.open-open.com/jsoup/;在抓纵横中文网永生这本书的目录内容时碰到了问题, 永生的书简 ...
随机推荐
- docker搭建私服
拉registry镜像 假设在192.168.100.17服务器上搭建私服 docker pull registry docker run -d -v /data/docker/registry:/v ...
- java基础-静态,非静态(构造)代码块,类加载
static block and non-static block(constructor block) [toc] 想来想去,先来一题比较好 public class Foo { public st ...
- 【转】iptables 命令介绍
iptables 防火墙可以用于创建过滤(filter)与NAT规则.所有Linux发行版都能使用iptables,因此理解如何配置iptables将会帮助你更有 效地管理Linux防火墙.如果你是第 ...
- 01-Go命令与基础
什么是Go? Go是一门并发支持.垃圾回收的编译型系统编程语言,旨在创造一门具有在静态编译语言的高性能和动态的高效开之间拥有良好平衡点的一门编程语言. Go的主要特点有哪些? 类型安全和内存安全 以非 ...
- C语言的格式符
转至:http://blog.csdn.net/zhanzheng520/article/details/10434791 一.格式符含义 1.d格式符:按十进制格式输出. %d ...
- 常用的几个PHP加密函数
1.前言 PHP加密方式分为单项散列加密,对称加密,非对称加密这几类. 像常用的MD5.hash.crypt.sha1这种就是单项散列加密,单项散列加密是不可逆的. 像URL编码.base64编码这种 ...
- Java NIO之网络编程
最近在研究Java NIO和netty,曾经一度感觉很吃力,根本原因还是对操作系统.TCP/IP.socket编程的理解不到位. 不禁感叹,还是当初逃的课太多. 假如上天给我一次机会,能够再回到意气风 ...
- 面向切面编程之手动JDK代理方式
需求描述: 抽取dao层开启和提交事物交由代理类一并执行 分析: 假如UserDao接口中有很多方法,例如addUser().deleteUser().updateUser()等等,需要频繁的和数据库 ...
- 在高并发、高负载的情况下,如何给表添加字段并设置DEFAULT值?
在高并发.高负载的情况下,如何给表添加字段并设置DEFAULT值? 在Oracle 12c之前,当Oracle表数据量上亿时,对表执行“ALTER TABLE XXX ADD COLUMN_XX VA ...
- VUE2.0增删改查附编辑添加model(弹框)组件共用
Vue实战篇(增删改查附编辑添加model(弹框)组件共用) 前言 最近一直在学习Vue,发现一份crud不错的源码 预览链接 https://taylorchen709.github.io/vue- ...