
hive数据库的哪些函数操作是否走MR
平时我们用的HIVE 我们都知道 select * from table_name 不走MR 直接走HTTP
hive 0.10.0为了执行效率考虑,简单的查询,就是只是select,不带count,sum,group by这样的,都不走map/reduce,直接读取hdfs文件进行filter过滤。这样做的好处就是不新开mr任务,执行效率要提高不少,但是不好的地方就是用户界面不友好,有时候数据量大还是要等很长时间,但是又没有任何返回。
改这个很简单,在hive-site.xml里面有个配置参数叫
hive.fetch.task.conversion
将这个参数设置为more,简单查询就不走map/reduce了,设置为minimal,就任何简单select都会走map/reduce
造200W数据 格式为
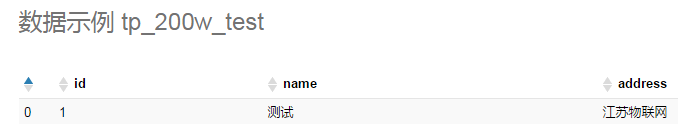
下面验证下like是否走MR
1、等值比较: =
select * from tp_200w_test where name='测试 '-等值条件下 --不走MR
2、模糊比较: LIKE
1)百分号在后面
select * from tp_200w_test where name like '测%' and address like '江苏%' --不走MR
2)百分号在前面
select * from tp_200w_test where name like '%试' --不走MR
3)百分号在2边
select * from tp_200w_test where address like '%物联%' --不走MR
4)百分号加中间
select * from tp_200w_test where address like '%物%联%' --不走MR
3、不等值比较: <>
select * from tp_200w_test where id <>1 --不走MR
4、小于比较:< ,大于比较> 小于等于<= 大于等于>=
select * from tp_200w_test where id <2 --不走MR
select * from tp_200w_test where id >2 --不走MR
select * from tp_200w_test where id >=2 --不走MR
select * from tp_200w_test where id <=2 --不走MR
5、空值判断is null, is not null
select * from tp_200w_test where id is null --不走MR
select * from tp_200w_test where id is not null --不走MR
6、JAVA的LIKE操作: RLIKE
select * from tp_200w_test where id rlike '^f.*r$' --不走MR
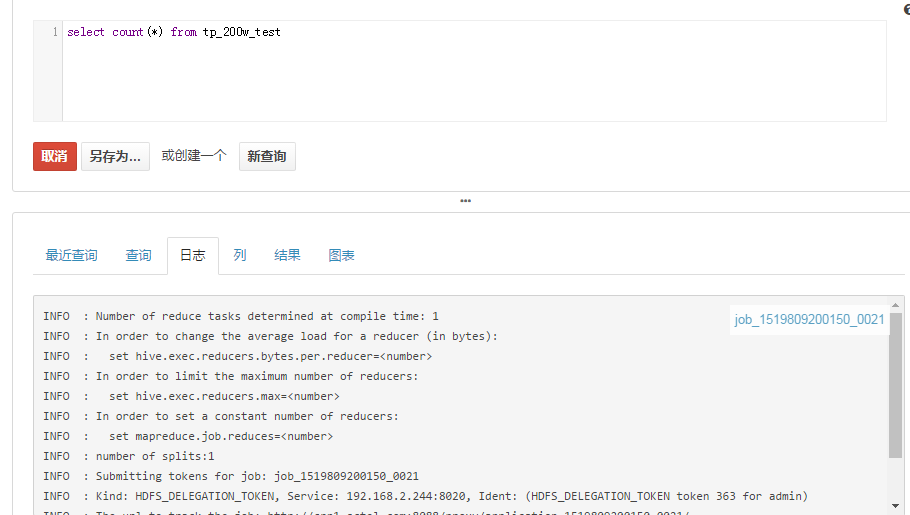
对于集合统计函数
1) count,sum ,min ,avg ,max 函数 都走MR,不在一一写
hive数据库的哪些函数操作是否走MR的更多相关文章
- 【简说Python WEB】视图函数操作数据库
目录 [简说Python WEB]视图函数操作数据库 系统环境:Ubuntu 18.04.1 LTS Python使用的是虚拟环境:virutalenv Python的版本:Python 3.6.9 ...
- 第69节:Java中数据库的多表操作
第69节:Java中数据库的多表操作 前言 学习数据库的多表操作,去电商行业做项目吧!!! 达叔,理工男,简书作者&全栈工程师,感性理性兼备的写作者,个人独立开发者,我相信你也可以!阅读他的文 ...
- [Hive_6] Hive 的内置函数应用
0. 说明 Hive 的内置函数的基本操作 | 时间函数 | String 函数 | 条件语句 | explode | split | substring 1. 基本操作 查看函数 show func ...
- 大数据开发实战:离线大数据处理的主要技术--Hive,概念,SQL,Hive数据库
1.Hive出现背景 Hive是Facebook开发并贡献给Hadoop开源社区的.它是建立在Hadoop体系架构上的一层SQL抽象,使得数据相关人员使用他们最为熟悉的SQL语言就可以进行海量数据的处 ...
- Frida用法之函数操作
Frida接口功能介绍 Frida是个so级别的hook框架,它可以帮助开发.安全人员对指定的进程的so模块进行分析.它主要提供了功能简单的Python接口和功能丰富的JS接口,使得hook函数和 ...
- 使用mapreduce清洗简单日志文件并导入hive数据库
Result文件数据说明: Ip:106.39.41.166,(城市) Date:10/Nov/2016:00:01:02 +0800,(日期) Day:10,(天数) Traffic: 54 ,(流 ...
- 数据清洗:按照进行数据清洗,并将清洗后的数据导入hive数据库中。
虚拟机: hadoop:3.2.0 hive:3.1.2 win10: eclipse 两阶段数据清洗: (1)第一阶段:把需要的信息从原始日志中提取出来 ip: 199.30.25.88 ti ...
- Hive的基本知识与操作
Hive的基本知识与操作 目录 Hive的基本知识与操作 Hive的基本概念 为什么使用Hive? Hive的特点: Hive的优缺点: Hive应用场景 Hive架构 Client Metastor ...
- Swift3.0服务端开发(四) MySQL数据库的连接与操作
本篇博客我们来聊聊MySQL数据库的连接与操作.如果你本地没有MySQL数据库的话,需要你先安装MySQL数据库.在Mac OS中使用brew包管理器进行MySQL的安装是及其方便的.安装MySQL的 ...
随机推荐
- 自制PHP高防防盗链(不是一般的高)(思路)
原理:根据IP,资源ID,时间戳,一次性Access_Token,APPKEY(暴露在前台)和APPSERECT(后台)来生成参数,具体见下面: 浏览器请求页面=>后台引用防盗链代码=>生 ...
- 通过实例介绍持续集成的应用--基于Jenkins
1.测试工程师为什么要掌握持续集成 一个程序员如果想发布一个产品,他需要编码.编译.测试,发布的过程.对于一个企业来说,如果也想发布一个产品的话,同样的也是需要上述的过程,区别在于企业要发布的产品的需 ...
- hibernate之实体@onetomany和@manytoone双向注解(转)
下面是User类: @onetomany @Entity @Table(name="user") public class User implements Serializable ...
- markdown流程图画法小结
markdown流程图画法小结 markdown 画图 流程图 最简单的流程图为例 ```mermaid! graph TD A --> B //在没有(),[].{}等括号的情况之下,图标 ...
- 机器学习之支持向量机(二):SMO算法
注:关于支持向量机系列文章是借鉴大神的神作,加以自己的理解写成的:若对原作者有损请告知,我会及时处理.转载请标明来源. 序: 我在支持向量机系列中主要讲支持向量机的公式推导,第一部分讲到推出拉格朗日对 ...
- JAVA浮点数计算精度损失底层原理与解决方案
浮点数会有精度损失这个在上大学的时候就已经被告知,但是至今完全没有想明白其中的原由,老师讲的时候也是一笔带过的,自己也没有好好琢磨.终于在工作的时候碰到了,于是google了一番. 问题: 对两个do ...
- 老男孩Python全栈开发(92天全)视频教程 自学笔记21
day21课程内容: json: #序列化 把对象(变量)从内存中 编程可存储和可传输的过程 称为序列化import jsondic={'name':'abc','age':18}with open ...
- 老男孩Python全栈开发(92天全)视频教程 自学笔记08
day8课程内容: 文件操作 f=open('小重山','r',encoding='utf8') #以读的方式打开文件 data=f.read() print(data) f.close() # ...
- UVA - 242 线性DP
题意:给定多种邮票的组合,邮票最多只能用S张,这些邮票能组成许多不同面额,问最大连续面额的长度是多少,如果有多个组合输出组合中邮票数量最少的,如果仍有长度一致的,输出邮票从大到小排序后字典序最大的那个 ...
- Java日期操作工具类
/** * 格式化日期显示格式 * * @param sdate * 原始日期格式 s - 表示 "yyyy-mm-dd" 形式的日期的 String 对象 * @param fo ...