
Scala进阶之路-Spark本地模式搭建
Scala进阶之路-Spark本地模式搭建
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
一.Spark简介
1>.Spark的产生背景
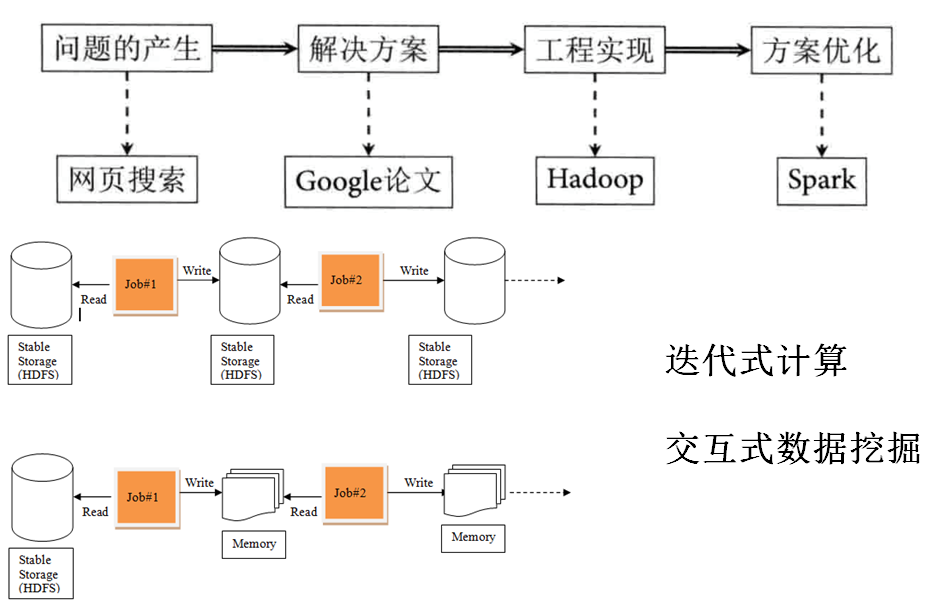
传统式的Hadoop缺点主要有以下两点:
第一.迭代式计算效率低(一个MapReduce依赖上一个MapReduce的结果);
第二.交互式数据挖掘效率低(运行一个HIVE语句效率是极低的,第一天输入的SQL可能等到第二天才能拿到结果)
Spark优化了Hadoop的两个缺点,可以将多个job合并成一个job来执行,也可以将于磁盘的交互迁移到内存进行交互,从而提升了工作效率。
2>.Spark是什么
、软件栈中所有的程序库和高级组件 都可以从下层的改进中获益。

、运行整个软件栈的代价变小了。不需要运行5到10套独立的软件系统了,一个机构只需要运行一套软件系统即可。系统的部署、维护、测试、支持等大大缩减。

、能够构建出无缝整合不同处理模型的应用。

Spark Core:
  实现了 Spark 的基本功能,包含任务调度、内存管理、错误恢复、与存储系统 交互等模块。Spark Core 中还包含了对弹性分布式数据集(resilient distributed dataset,简称RDD)的 API 定义。

Spark SQL:
  是 Spark 用来操作结构化数据的程序包。通过 Spark SQL,我们可以使用 SQL 或者 Apache Hive 版本的 SQL 方言(HQL)来查询数据。Spark SQL 支持多种数据源,比 如 Hive 表、Parquet 以及 JSON 等。

Spark Streaming:
  是 Spark 提供的对实时数据进行流式计算的组件。提供了用来操作数据流的 API,并且与 Spark Core 中的 RDD API 高度对应。

Spark MLlib:
  提供常见的机器学习(ML)功能的程序库。包括分类、回归、聚类、协同过滤等,还提供了模型评估、数据 导入等额外的支持功能。

集群管理器:
  Spark 设计为可以高效地在一个计算节点到数千个计算节点之间伸缩计 算。为了实现这样的要求,同时获得最大灵活性,Spark 支持在各种集群管理器(cluster manager)上运行,包括 Hadoop YARN、Apache Mesos,以及 Spark 自带的一个简易调度 器,叫作独立调度器。

    Spark得到了众多大数据公司的支持,这些公司包括Hortonworks、IBM、Intel、Cloudera、MapR、Pivotal、百度、阿里、腾讯、京东、携程、优酷土豆。当前百度的Spark已应用于凤巢、大搜索、直达号、百度大数据等业务;阿里利用GraphX构建了大规模的图计算和图挖掘系统,实现了很多生产系统的推荐算法;腾讯Spark集群达到8000台的规模,是当前已知的世界上最大的Spark集群。
3>.Spark的安装模式
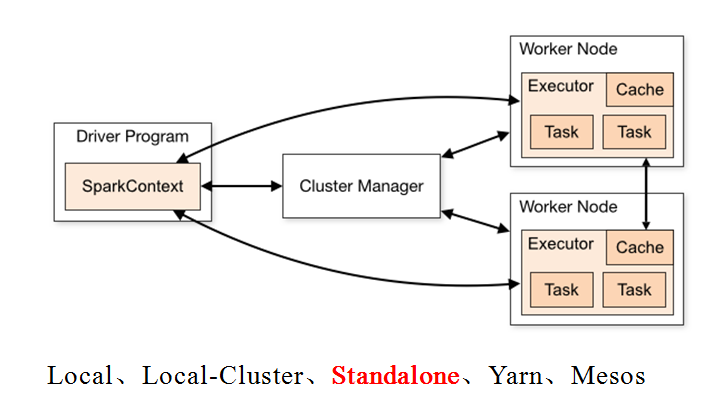
安装模式可分为以下几种:

Local、Local-Cluster、Standalone、Yarn、Mesos

Master节点主要运行集群管理器的中心化部分,所承载的作用是分配Application到Worker节点,维护Worker节点,Driver,Application的状态。

Worker节点负责具体的业务运行。
二.部署Spark本地模式
1>.下载Spark软件
官网下载地址:http://spark.apache.org/downloads.html
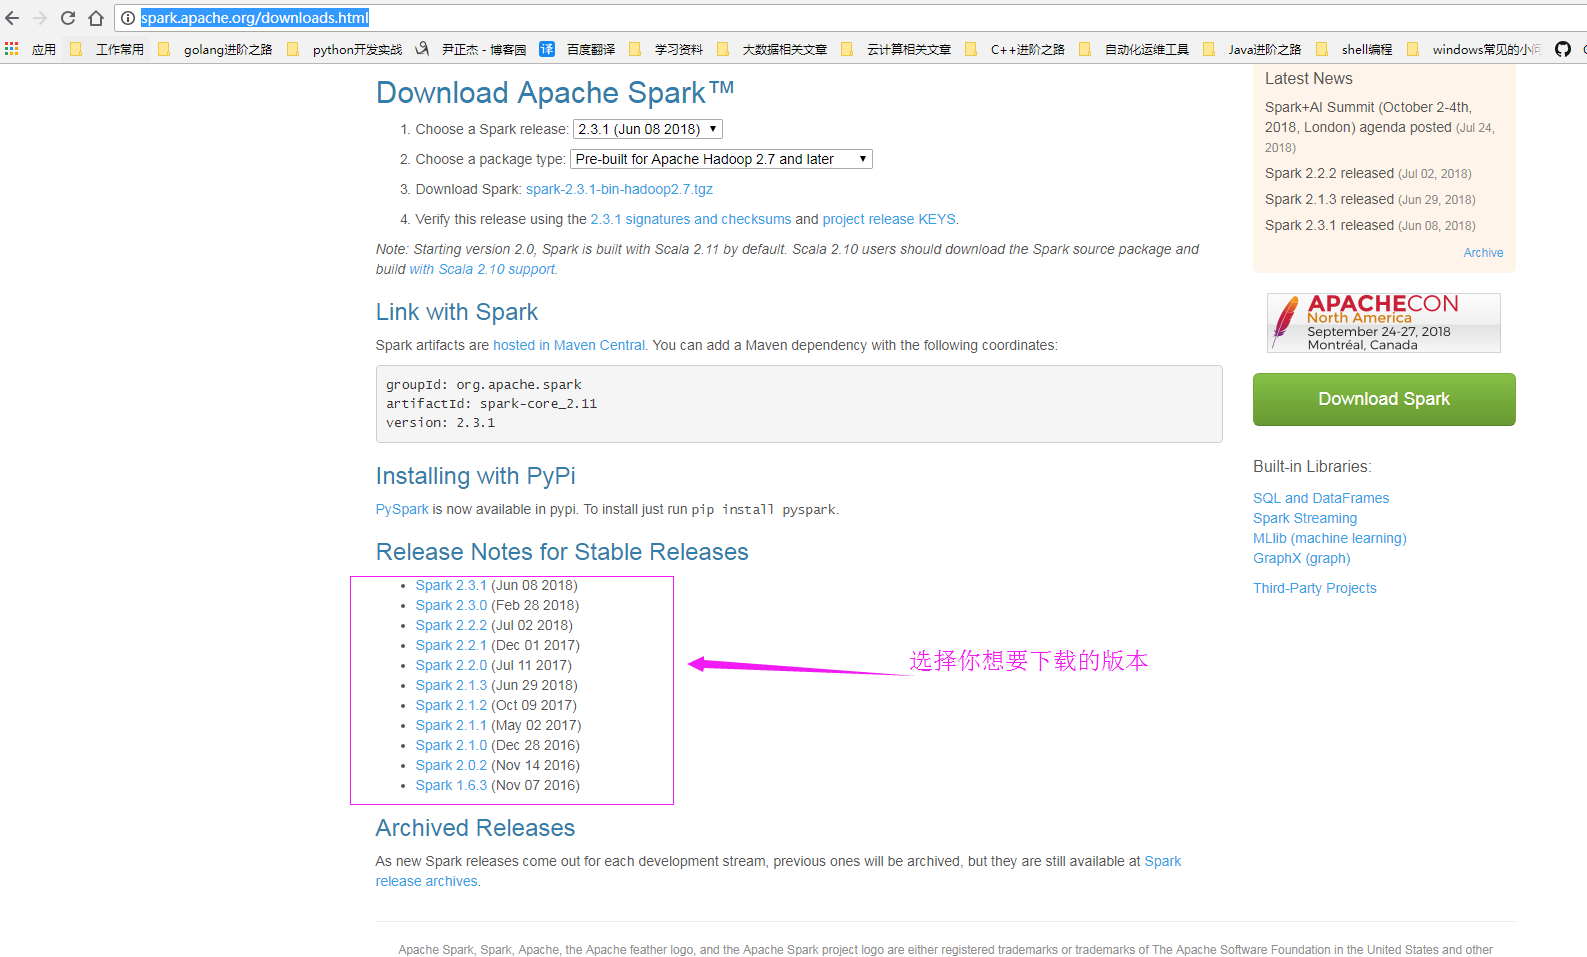
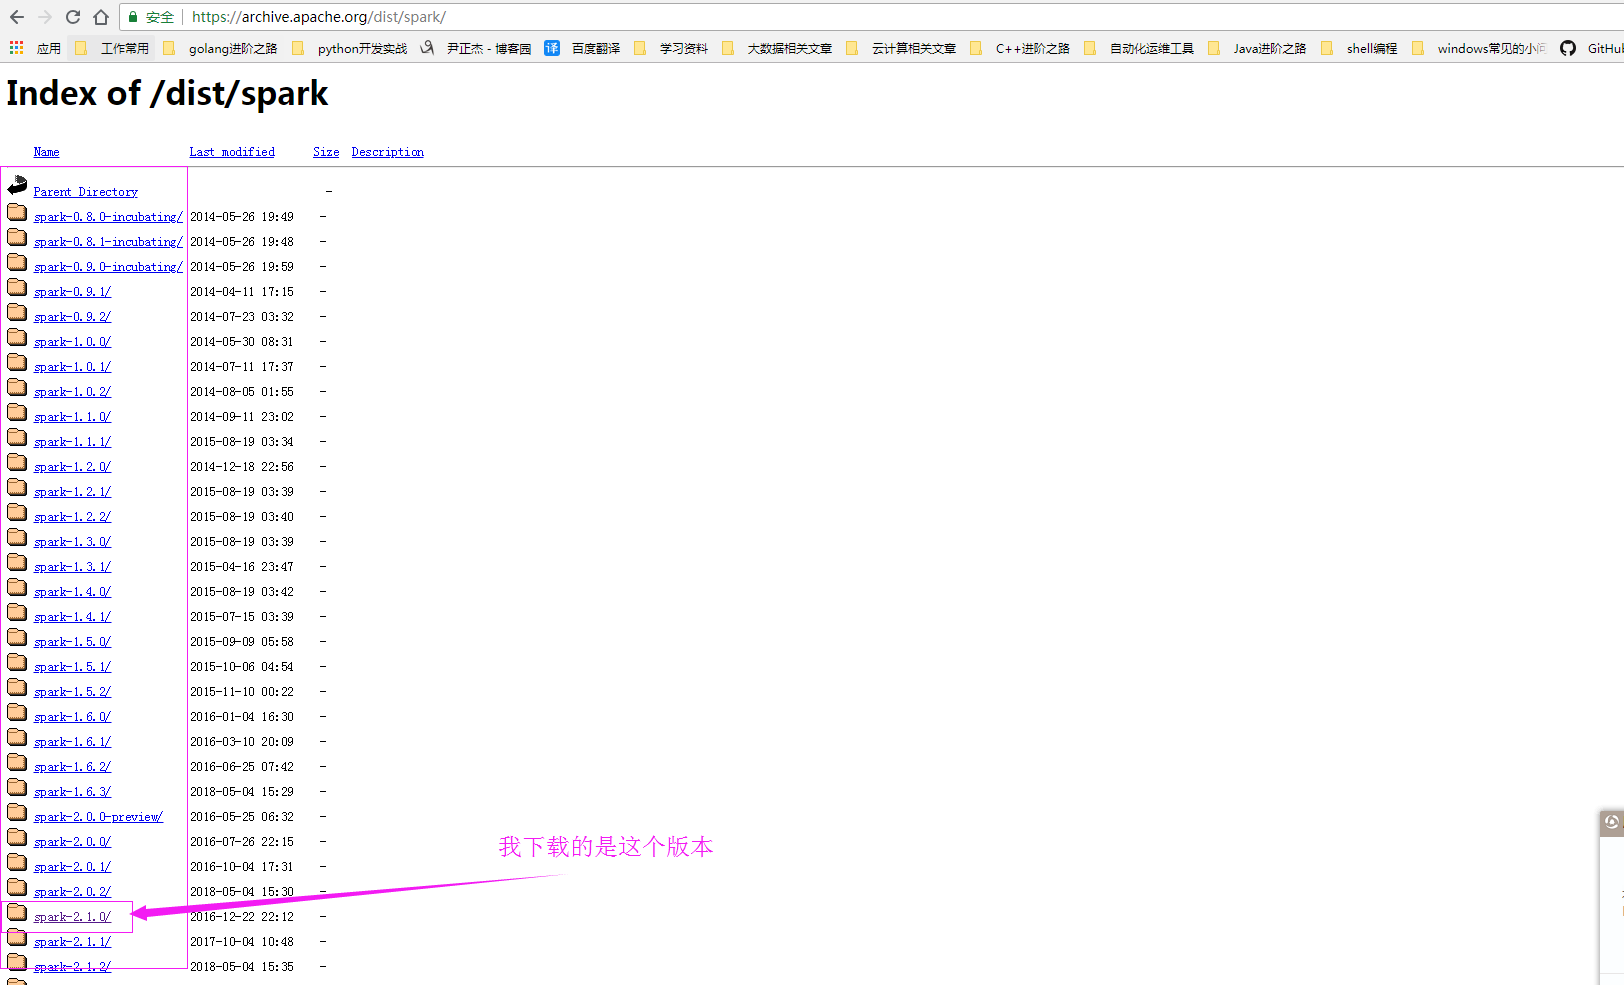
当然点上面的网页只是对该版本的支持,允许我调戏你一下,哈哈,实际上下载位置应该在这里:https://archive.apache.org/dist/spark/ 。
2>.解压下载的Spark并创建软连接
[yinzhengjie@s101 download]$ wget https://archive.apache.org/dist/spark/spark-2.1.0/spark-2.1.0-bin-hadoop2.7.tgz

[yinzhengjie@s101 download]$ ll

total

-rw-r--r--  yinzhengjie yinzhengjie  Jan    spark-2.1.-bin-hadoop2..tgz

[yinzhengjie@s101 download]$

[yinzhengjie@s101 download]$ tar -zxf spark-2.1.-bin-hadoop2..tgz -C /soft/

[yinzhengjie@s101 download]$

[yinzhengjie@s101 download]$ ln -s /soft/spark-2.1.-bin-hadoop2./ /soft/spark

[yinzhengjie@s101 download]$

[yinzhengjie@s101 download]$ ll /soft/ | grep spark

lrwxrwxrwx    yinzhengjie yinzhengjie    Jul  : spark -> /soft/spark-2.1.-bin-hadoop2./

drwxr-xr-x   yinzhengjie yinzhengjie  Dec    spark-2.1.-bin-hadoop2.

[yinzhengjie@s101 download]$
3>.配置环境变量并使环境变量生效
[yinzhengjie@s101 download]$ tail - /etc/profile

#ADD spark Path

export SPARK_HOME=/soft/spark

PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin

[yinzhengjie@s101 download]$

[yinzhengjie@s101 download]$ source /etc/profile

[yinzhengjie@s101 download]$
4>.启动Spark

5>.查看进程是否启动
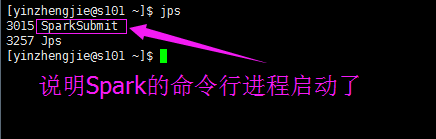
6>.查看WebUI界面

三.Spark初体验-使用Spark实现单词统计
1>.创建测试文件
[yinzhengjie@s101 download]$ cat /home/yinzhengjie/.txt

hello world

yinzhengjie hello word

hello scala

hello java

hello python

hello shell

hello yinzhengjie

hello golang

[yinzhengjie@s101 download]$
2>.实现单词统计
体验Spark

----------------------

    .登录spark

      spark-shell

    .编写scala代码

        //1.加载文本

        val rdd1 = sc.textFile("/home/yinzhengjie/1.txt")

        //2.压扁

        val rdd2 = rdd1.flatMap(line=>{line.split(" ")})

        //3.变换,标1成对

        val rdd3 = rdd2.map(word=>{(word , )})

        //4.按照key进行化简

        val rdd4 = rdd3.reduceByKey((a,b)=> a + b).sortBy(t=> -t._2 )

        //5.输出结果

        rdd4.collect()

    .一行完成

         sc.textFile("/home/yinzhengjie/1.txt").flatMap(_.split(" ")).map((_,)).reduceByKey(_+_).sortBy(t=> -t._2 ).collect()

Scala进阶之路-Spark本地模式搭建的更多相关文章
- Scala进阶之路-Spark独立模式(Standalone)集群部署
Scala进阶之路-Spark独立模式(Standalone)集群部署 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 我们知道Hadoop解决了大数据的存储和计算,存储使用HDFS ...
- Scala进阶之路-Spark底层通信小案例
Scala进阶之路-Spark底层通信小案例 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Spark Master和worker通信过程简介 1>.Worker会向ma ...
- Scala进阶之路-为什么要学习Scala以及开发环境搭建
Scala进阶之路-为什么要学习Scala以及开发环境搭建 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 最近人工智能和大数据那是相当的火呀,人工智能带动了Python的流行,区块 ...
- Scala进阶之路-idea下进行spark编程
Scala进阶之路-idea下进行spark编程 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 1>.创建新模块并添加maven依赖 <?xml version=&qu ...
- Spark进阶之路-Spark HA配置
Spark进阶之路-Spark HA配置 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 集群部署完了,但是有一个很大的问题,那就是Master节点存在单点故障,要解决此问题,就要借 ...
- Scala进阶之路-Scala的基本语法
Scala进阶之路-Scala的基本语法 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.函数式编程初体验Spark-Shell之WordCount var arr=Array( ...
- Scala进阶之路-Scala中的高级类型
Scala进阶之路-Scala中的高级类型 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.类型(Type)与类(Class)的区别 在Java里,一直到jdk1.5之前,我们说 ...
- Scala进阶之路-Scala高级语法之隐式(implicit)详解
Scala进阶之路-Scala高级语法之隐式(implicit)详解 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 我们调用别人的框架,发现少了一些方法,需要添加,但是让别人为你一 ...
- Scala进阶之路-并发编程模型Akka入门篇
Scala进阶之路-并发编程模型Akka入门篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Akka Actor介绍 1>.Akka介绍 写并发程序很难.程序员不得不处 ...
随机推荐
- 转发:C#操作SQL Server数据库
转发自:http://www.cnblogs.com/rainman/archive/2012/03/13/2393975.html 1.概述 2.连接字符串的写法 3.SqlConnection对象 ...
- Leetcode——258.各位相加【水题】
给定一个非负整数 num,反复将各个位上的数字相加,直到结果为一位数. 示例: 输入: 38 输出: 2 解释: 各位相加的过程为:3 + 8 = 11, 1 + 1 = 2. 由于 2 是一位数,所 ...
- mysql外键关联
主键:是唯一标识一条记录,不能有重复的,不允许为空,用来保证数据完整性 外键:是另一表的主键, 外键可以有重复的, 可以是空值,用来和其他表建立联系用的.所以说,如果谈到了外键,一定是至少涉及到两张表 ...
- [2017BUAA软件工程]第0次博客作业
[2017BUAA软件工程]第0次博客作业 结缘计算机 你为什么选择计算机专业?你认为你的条件如何?和这些博主比呢? 计算机是你喜欢的领域吗?是你擅长的领域吗? 我当时报考高考志愿的时候就已经是想好报 ...
- 【Alpha阶段】测试报告
buglist:链接 1.测试找出的BUG 从上线之前黑盒测试结果bug清单: 录入报告的按钮变灰 浏览器浏览时网站崩溃 实验报告显示不出 收藏夹在点击多次后变为 1071生成报告数据不对 个人收藏点 ...
- 自定义组件的 v-model
Vue.component('base-checkbox', { model: { prop: 'checked', event: 'change' }, props: { checked: Bool ...
- [转帖] kubeadm搭建kubernetes集群
http://www.bladewan.com/2018/01/02/kubernetes_install/ 学习中 kubernetes V1.9安装(附离线安装包和离线镜像) 2018-01-0 ...
- ntpdate[31915]: the NTP socket is in use, exiting
[root@master local]# ntpdate cn.pool.ntp.org 10 Oct 13:24:36 ntpdate[31915]: the NTP socket is in us ...
- delphi try except语句 和 try finally语句用法以及区别
try//尝试执行{SomeCode} except//出错的时候执行, Except有特定的错误类型 {SomeCode} end; try//尝试执行{SomeCode} finally//无论如 ...
- BZOJ3028 食物(生成函数)
显然构造出生成函数:则有f(x)=(1+x2+x4+……)·(1+x)·(1+x+x2)·(x+x3+x5+……)·(1+x4+x8+……)·(1+x+x2+x3)·(1+x)·(1+x3+x6+…… ...