
Gradient-Based Learning Applied to Document Recognition 部分阅读
卷积网络
卷积网络用三种结构来确保移位、尺度和旋转不变:局部感知野、权值共享和时间或空间降采样。典型的leNet-5如下图所示:
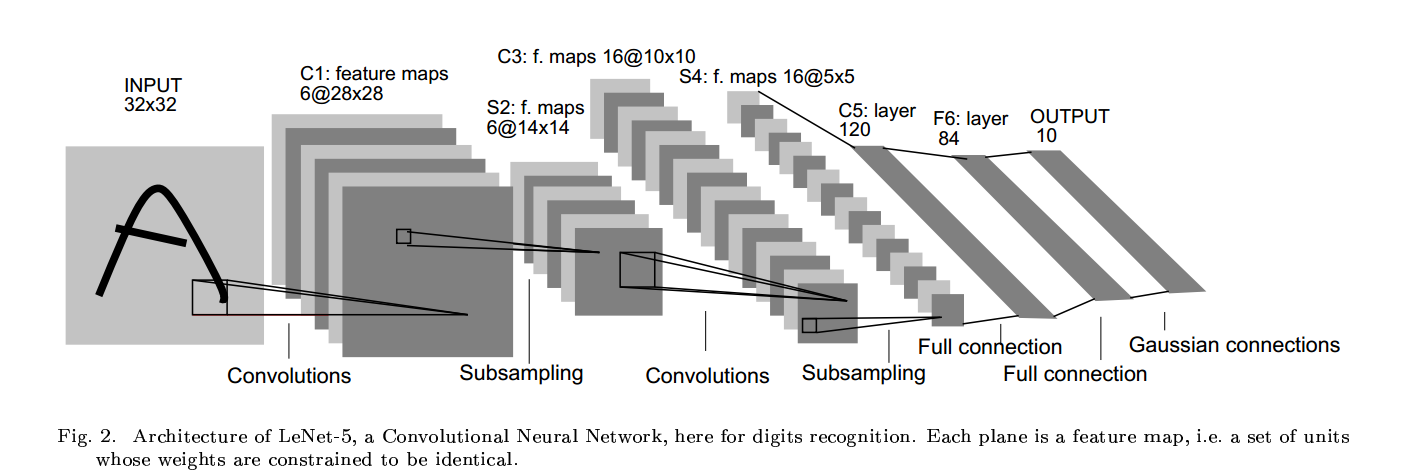
C1中每个特征图的每个单元和输入的25个点相连,这个5*5的区域被称为感知野。特征图的每个单元共享25个权值和一个偏置。其他特征图使用不同的权值(卷积枋),因
此可以得到不同类型的局部特征。卷积层的一个重要思想是,如果图像产生了位移,特征图输出将会产生相同数量的位移。这也是卷积网络位移和形变不变的原理。
特征图检测完毕后,它们的确切位置就不那么重要了,重要的是特征之间的相对位置。特征位置太准确不仅无利于模式识别,还会有害处,因为对不同的字符来说它们的位置是
不同的(所以特征之间的相对位置才是最重要的)。降低位置准确性可以通过下采样来降低分辨率来实现,同是也降低了输出对位移和形变的敏感性。每个单元计算四个输入的平均值(就是采样层),
将下采样的值乘一个训练系数加一个偏置(下采样层连接到sigmod的系数同要需要训练),然后将结果传给激活函数。训练系数和偏置控制了sigmod函数的非线性。如果这个系数很小的话,则每个单元类似于线性模型,下采样层所起的功能仅仅就是模糊输入;如果系数很大,则下采样操作可视为noisy OR或者 noisy AND(取决于偏置的大小)(存疑?)。
leNet-5
leNet-5有七层(不含输入),其中C1有156((5*5+1)*6)个可训练参数,122304(28*28*156)个连接。C2层的一个单元为C1中的2*2所得,输入到激活函数时它们共用一个
系数加一个偏置,所需的训练参数为(1+1)*6=12个,连接参数为(4+1)*6*14*14=5880个(我的理解是只在leNet-5中2*2的感知野值相同)。
C3层有16个特征图,由表格可以看出,每个特征图对S2中的特征图并非是全连接的。共有(25*3+1)*6+(25*4)*9+(25*6+1)=1516个训练参数,连接个数为
1516*10*10=151600个。S4同样为下采样层,有16*(1+1)=32个训练参数,有(2*2+1)*25*16=2000个连接。

C5有120个特征图,同样用5*5的卷积核,与S4层全连接,所以C5的特征是1*1的。之所以C5为卷积层而不是全连接层,是因为当le-Net5的输入增大时,特征图的维度也会大于
1*1。
F6全连接层,有84个单元,与C5全连接,共有(120+1)*84=10164个训练参数。同经经典的神经网络一样,F6乘权重加偏置然后送入到激活函数中。
下面是输出层(好吧,看的不是很明白),参考:http://blog.csdn.net/zouxy09/article/details/8781543
Gradient-Based Learning Applied to Document Recognition 部分阅读的更多相关文章
- 深度学习基础(一)LeNet_Gradient-Based Learning Applied to Document Recognition
作者:Yann LeCun,Leon Botton, Yoshua Bengio,and Patrick Haffner 这篇论文内容较多,这里只对部分内容进行记录: 以下是对论文原文的翻译: 在传统 ...
- 泡泡一分钟:Stabilize an Unsupervised Feature Learning for LiDAR-based Place Recognition
Stabilize an Unsupervised Feature Learning for LiDAR-based Place Recognition Peng Yin, Lingyun Xu, Z ...
- Learning Query and Document Similarities from Click-through Bipartite Graph with Metadata
读了一篇paper,MSRA的Wei Wu的一篇<Learning Query and Document Similarities from Click-through Bipartite Gr ...
- 强化学习之 免模型学习(model-free based learning)
强化学习之 免模型学习(model-free based learning) ------ 蒙特卡罗强化学习 与 时序查分学习 ------ 部分节选自周志华老师的教材<机器学习> 由于现 ...
- Collaborative Spatioitemporal Feature Learning for Video Action Recognition
Collaborative Spatioitemporal Feature Learning for Video Action Recognition 摘要 时空特征提取在视频动作识别中是一个非常重要 ...
- Pros and Cons of Game Based Learning
https://www.gamedesigning.org/learn/game-based-learning/ I remember days gone by at elementary schoo ...
- 论文阅读 | Recurrent Attentional Reinforcement Learning for Multi-label Image Recognition
源地址 arXiv:1712.07465: Recurrent Attentional Reinforcement Learning for Multi-label Image Recognition ...
- 论文阅读:Multi-task Learning for Multi-modal Emotion Recognition and Sentiment Analysis
论文标题:Multi-task Learning for Multi-modal Emotion Recognition and Sentiment Analysis 论文链接:http://arxi ...
- BBN: Bilateral-Branch Network with Cumulative Learning for Long-Tailed Visual Recognition
BBN: Bilateral-Branch Network with Cumulative Learning for Long-Tailed Visual Recognition 目录 BBN: Bi ...
随机推荐
- ER-18
ER #18简要题解 就是推出循环矩阵乘积 然后一次操作后得到的c矩阵第一行第i列就是i的情况(b矩阵下标是a矩阵下标的转置) 两个循环矩阵乘积还是循环矩阵 以此推式子,发现c矩阵的第一行可以用a,b ...
- HDU4625 JZPTREE——第二类斯特林数
复杂度大概O(nk) 一些尝试:1.对每个点推出1,2,3,,,到k次方的值.但是临项递推二项式展开也要考虑到具体每个点的dist 2.相邻k次方递推呢?递推还是不能避免k次方的展开 k次方比较讨厌, ...
- 一个优质的Vue组件库应该遵循什么样的设计原则
一.组件库的价值 就个人而言,拥有一套自己的组件库,可以让你的开发变得更高效,让你在行业里更有价值. 就团队而言,拥有一套团队的组件库,可以让协同开发变得更高效规范,让你的团队在公司更具有影响力. 就 ...
- 手脱EZIP v1.0
一.单步 1.载入PEID查壳 EZIP v1.0 2.载入OD,一上来就是一个大跳转,F8单步一直走 0040D0BE > $ /E9 jmp Notepad.004102DC ; //入口点 ...
- 《Apache HttpClient 4.3开发指南》
转载自:http://blog.csdn.net/chszs/article/details/16854747 作者:chszs,转载需注明.博客主页:http://blog.csdn.net/chs ...
- Vue2.0中的路由配置
Vue2.0较Vue1.0,路由有了较大改变.看一下Vue2.0中的路由如何配置: 步骤一: 在main.js文件中引入相关模块以及组件及实例化vue对象配置选项路由及渲染App组件 默认设置如下: ...
- JS数组---转及补充--
javascript之数组操作 1.数组的创建 var arr=Array();//写的角标数及直接写角标对应的内容简写 var arr=Array("我","爱&quo ...
- JS获取列表索引值
html部分 <ul id="test"> <li>111</li> <li>222</li> <li>33 ...
- javascript中各类的prototype属性
prototype 作用:获取调用对象的对象原型引用 应用:可以为某对象原型添加方法 例: function getMax() { var max = this[0]; for(var x=0; x& ...
- 第一周 ch01 课下测试
1.Amdahl定律说明,我们对系统的某个部分做出重大改进,可以显著获得一个系统的加速比.(B) A .正确 B .错误 解析:Amdahl定律,该定律的主要思想是,当我们对系统的某个部分加速时,其对 ...