
spark原理
SparkContext将应用程序代码分发到各Executors,最后将任务(Task)分配给executors执行
- Application: Appliction都是指用户编写的Spark应用程序,其中包括一个Driver功能的代码和分布在集群中多个节点上运行的Executor代码
- Driver: Spark中的Driver即运行上述Application的main函数并创建SparkContext,创建SparkContext的目的是为了准备Spark应用程序的运行环境,在Spark中有SparkContext负责与ClusterManager通信,进行资源申请、任务的分配和监控等,当Executor部分运行完毕后,Driver同时负责将SparkContext关闭,通常用SparkContext代表Driver
Driver重点:创建和关闭sparkcontext.
- Executor: 某个Application运行在worker节点上的一个进程, 该进程负责运行某些Task, 并且负责将数据存到内存或磁盘上,每个Application都有各自独立的一批Executor, 在Spark on Yarn模式下,其进程名称为CoarseGrainedExecutor Backend。一个CoarseGrainedExecutor Backend有且仅有一个Executor对象, 负责将Task包装成taskRunner,并从线程池中抽取一个空闲线程运行Task, 这个每一个oarseGrainedExecutor Backend能并行运行Task的数量取决与分配给它的cpu个数
excutor重点:某个Application运行在worker节点上的一个进程,该进程负责运行某些Task,运行Task的数量取决与分配给它的cpu个数。
Work为子节点。
Job:根据Job构建基于Stage的DAG
Stage:多个taskset(task集合)
Task:执行的任务的最小单位。
Spark Cluster模式:
- 在YARN-Cluster模式中,当用户向YARN中提交一个应用程序后,YARN将分两个阶段运行该应用程序:
- 第一个阶段是把Spark的Driver(创建sparkcontext,构建环境)作为一个ApplicationMaster在YARN集群中先启动;
- 第二个阶段是由ApplicationMaster创建应用程序,然后为它向ResourceManager申请资源,并启动Executor来运行Task,同时监控它的整个运行过程,直到运行完成
- YARN-cluster的工作流程分为以下几个步骤
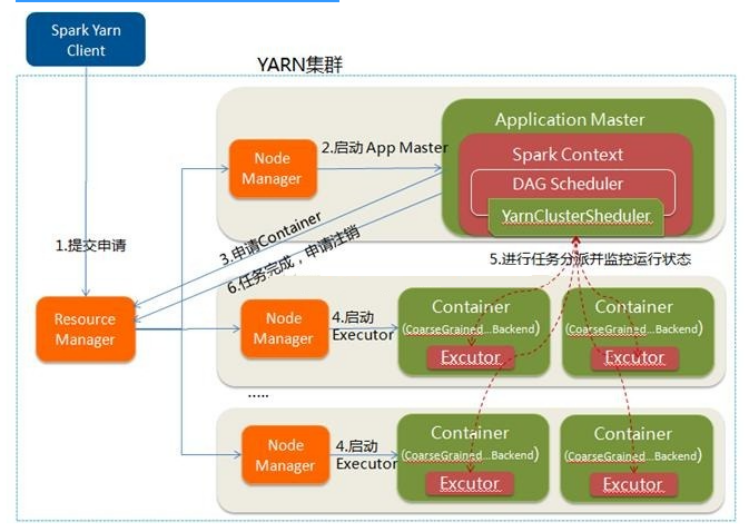
待续
spark原理的更多相关文章
- Spark原理分析目录
1 Spark原理分析 -- RDD的Partitioner原理分析 2 Spark原理分析 -- RDD的shuffle简介 3 Spark原理分析 -- RDD的shuffle框架的实现概要分析 ...
- Spark原理小总结
1.spark是什么? 快速,通用,可扩展的分布式计算引擎 2.弹性分布式数据集RDD RDD(Resilient Distributed Dataset)叫做分布式数据集,是Spark中最基本的数据 ...
- Update(Stage4):Spark原理_运行过程_高级特性
如何判断宽窄依赖: =================================== 6. Spark 底层逻辑 导读 从部署图了解 Spark 部署了什么, 有什么组件运行在集群中 通过对 W ...
- spark原理介绍
1.spark是一个基于内存计算的开源的集群计算系统,目的是让数据分析更加快速.因此运行spark的机器应该尽量的大内存,如96G以上. 2.spark所有操作均基于RDD,操作主要分成2大类:tra ...
- spark原理介绍 分类: B8_SPARK 2015-04-28 12:33 1039人阅读 评论(0) 收藏
1.spark是一个基于内存计算的开源的集群计算系统,目的是让数据分析更加快速.因此运行spark的机器应该尽量的大内存,如96G以上. 2.spark所有操作均基于RDD,操作主要分成2大类:tra ...
- Spark原理概述
原文来自我的个人网站:http://www.itrensheng.com/archives/Spark_basic_knowledge 一. Spark出现的背景 在Spark出现之前,大数据计算引擎 ...
- 《Spark大数据处理》---Spark原理
- 大数据组件原理总结-Hadoop、Hbase、Kafka、Zookeeper、Spark
Hadoop原理 分为HDFS与Yarn两个部分.HDFS有Namenode和Datanode两个部分.每个节点占用一个电脑.Datanode定时向Namenode发送心跳包,心跳包中包含Datano ...
- Spark基本架构及原理
Hadoop 和 Spark 的关系 Spark 运算比 Hadoop 的 MapReduce 框架快的原因是因为 Hadoop 在一次 MapReduce 运算之后,会将数据的运算结果从内存写入到磁 ...
随机推荐
- Java中List的sort排序重写
最近遇到需要使用list中sort排序功能,list中存的是自己写的类,所以需要重写sort函数,一般实现如下: Collections.sort(voList, new Comparator< ...
- springboot+vue前后端分离,nginx代理配置 tomcat 部署war包详细配置
1.做一个小系统,使用了springboot+vue 基础框架参考这哥们的,直接拿过来用,链接https://github.com/smallsnail-wh/interest 前期的开发环境搭建就不 ...
- mysql左连接右连接(查询两张表不同的数据)
有两张表:一张A表he一张B表 left join(左联接) 返回包括左表中的所有记录和右表中联结字段相等的记录 :right join(右联接) 返回包括右表中的所有记录和左表中联结字段相等的记录: ...
- SuRF: Practical Range Query Filtering with Fast Succinct Tries 阅读笔记
SuRF(Succinct Range Filter)是一种快速而紧凑的过滤器,同时支持点查询和范围查询(包括开区间查询.闭区间查询.范围计数),可以在RocksDB中用SuRF来替换Bloom过滤器 ...
- 手动卸载的vs2010
手动卸载的vs2010: 环境:Win7 卸载工具:IobitUninstaller(绿色版)//个人推荐,比较强大好用按照以下顺序:1.Microsoft .NET Framework 4 框架 ...
- 开启mysql-binlog日志操作步骤
步骤1:找到mysql主库的配置文件(注意:不能为从库),lunix系统路径一般为/etc/my.cnf 步骤2:修改配置文件(可以提前备份一下)以开启mysql-binlog功能.添加以下3行: l ...
- openstack使用openvswitch实现vxlan的方法
openstack使用openvswitch实现vxlan,分享给大家,具体如下: openstack环境: 1 版本:ocata 2 系统:ubuntu16.04.2 3 控制节点 1个 + 计算节 ...
- python day10 函数(第二篇)
2019.4.10 S21 day10笔记总结 一.内容回顾 1.面试题相关: 1.py2和py3的区别 2.运算符的计算 :3 or 9 and 8 3.字符串的反转 4.is和==的区别 5.v1 ...
- 求1!+2!+3!+......+n!的和 -----C++-----
#include<iostream> using namespace std; int function(int x) { ; ;i<=x;i++) sum=sum*i; retur ...
- centos7编译安装nginx
一.安装依赖包 yum install gcc gcc-c++ autoconf automake zlib zlib-devel openssl openssl-devel pcre-devel 二 ...