
elastic-job详解(一):数据分片
数据分片的目的在于把一个任务分散到不同的机器上运行,既可以解决单机计算能力上限的问题,也能降低部分任务失败对整体系统的影响。elastic-job并不直接提供数据处理的功能,框架只会将分片项分配至各个运行中的作业服务器(其实是Job实例,部署在一台机器上的多个Job实例也能分片),开发者需要自行处理分片项与真实数据的对应关系。框架也预置了一些分片策略:平均分配算法策略,作业名哈希值奇偶数算法策略,轮转分片策略。同时也提供了自定义分片策略的接口。
分片原理
elastic-job的分片是通过zookeeper来实现的。分片的分片由主节点分配,如下三种情况都会触发主节点上的分片算法执行:
- 新的Job实例加入集群
- 现有的Job实例下线(如果下线的是leader节点,那么先选举然后触发分片算法的执行)
- 主节点选举
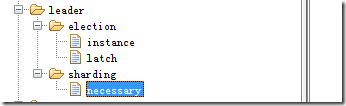
上述三种情况,会让zookeeper上leader节点的sharding节点上多出来一个necessary的临时节点,主节点每次执行Job前,都会去看一下这个节点,如果有则执行分片算法。
分片的执行结果会存储在zookeeper上,如下图,5个分片,每个分片应该由哪个Job实例来运行都已经分配好。分配的过程就是上面触发分片算法之后的操作。分配完成之后,各个Job实例就会在下次执行的时候使用上这个分配结果。
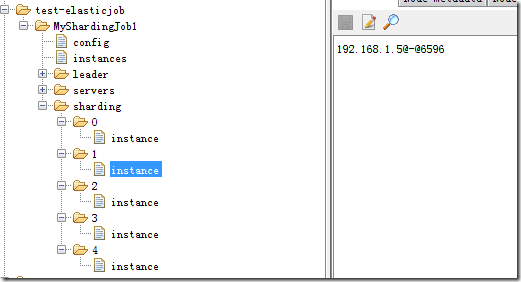
每个job实例任务触发前都会获取本任务在本实例上的分片情况(直接和上图zookeeper上instance节点比对某一个分片是否该有这个Job实例执行),然后封装成shardingContext,传递给调用任务的实际执行方法:
/**

     * 执行作业.

     *

     * @param shardingContext 分片上下文

     */

void execute(ShardingContext shardingContext);
分片算法
所有的分片策略都继承JobShardingStrategy接口。根据当前注册到ZK的实例列表和在客户端配置的分片数量来进行数据分片。最终将每个Job实例应该获得的分片数字返回出去。 方法签名如下:
/**

     * 作业分片.

     *

     * @param jobInstances 所有参与分片的单元列表

     * @param jobName 作业名称

     * @param shardingTotalCount 分片总数

     * @return 分片结果

     */

    Map<JobInstance, List<Integer>> sharding(List<JobInstance> jobInstances, String jobName, int shardingTotalCount);
分片函数的触发,只会在leader选举的时候触发,也就是说只会在刚启动和leader节点离开的时候触发,并且是在leader节点上触发,而其他节点不会触发。
1. 基于平均分配算法的分片策略
基于平均分配算法的分片策略对应的类是:AverageAllocationJobShardingStrategy。它是默认的分片策略。它的分片效果如下:
- 如果有3个Job实例, 分成9片, 则每个Job实例分到的分片是: 1=[0,1,2], 2=[3,4,5], 3=[6,7,8].
- 如果有3个Job实例, 分成8片, 则每个Job实例分到的分片是: 1=[0,1,6], 2=[2,3,7], 3=[4,5].
- 如果有3个Job实例, 分成10片, 则个Job实例分到的分片是: 1=[0,1,2,9], 2=[3,4,5], 3=[6,7,8].
2. 作业名的哈希值奇偶数决定IP升降序算法的分片策略
这个策略的对应的类是:OdevitySortByNameJobShardingStrategy,它内部其实也是使用AverageAllocationJobShardingStrategy实现,只是在传入的节点实例顺序不一样,也就是上面接口参数的List<JobInstance>。AverageAllocationJobShardingStrategy的缺点是一旦分片数小于Job实例数,作业将永远分配至IP地址靠前的Job实例上,导致IP地址靠后的Job实例空闲。而OdevitySortByNameJobShardingStrategy则可以根据作业名称重新分配Job实例负载。如:
- 如果有3个Job实例,分成2片,作业名称的哈希值为奇数,则每个Job实例分到的分片是:1=[0], 2=[1], 3=[]
- 如果有3个Job实例,分成2片,作业名称的哈希值为偶数,则每个Job实例分到的分片是:3=[0], 2=[1], 1=[]
实现比较简单:
long jobNameHash = jobName.hashCode();

if (0 == jobNameHash % 2) {

    Collections.reverse(jobInstances);

}

return averageAllocationJobShardingStrategy.sharding(jobInstances, jobName, shardingTotalCount);
3. 根据作业名的哈希值对Job实例列表进行轮转的分片策略
这个策略的对应的类是:RotateServerByNameJobShardingStrategy,和上面介绍的策略一样,内部同样是用AverageAllocationJobShardingStrategy实现,也是在传入的List<JobInstance>列表顺序上做文章。
4. 自定义分片策略
除了可以使用上述分片策略之外,elastic-job还允许自定义分片策略。我们可以自己实现JobShardingStrategy接口,并且配置到分片方法上去,整个过程比较简单,下面仅仅列出通过配置spring来切换自定义的分片算法的例子:
<job:simple id="MyShardingJob1" class="nick.test.elasticjob.MyShardingJob1" registry-center-ref="regCenter" cron="0/10 * * * * ?" sharding-total-count="5" sharding-item-parameters="0=A,1=B,2=C,3=D,4=E" job-sharding-strategy-class="nick.test.elasticjob.MyJobShardingStrategy"/>
elastic-job详解(一):数据分片的更多相关文章
- 十图详解tensorflow数据读取机制(附代码)转知乎
十图详解tensorflow数据读取机制(附代码) - 何之源的文章 - 知乎 https://zhuanlan.zhihu.com/p/27238630
- hadoop2.7作业提交详解之文件分片
在前面一篇文章中(hadoop2.7之作业提交详解(上))中涉及到文件的分片. JobSubmitter.submitJobInternal方法中调用了int maps = writeSplits(j ...
- 百度大脑UNIT3.0详解之数据生产工具DataKit
在智能对话项目搭建的过程中,高效筛选.处理对话日志并将其转化为新的训练数据,是对话系统效果持续提升的重要环节,也是当前开发者面临的难题之一.为此百度大脑UNIT推出学习反馈闭环机制,提供数据获取.辅助 ...
- 不看就亏了:DELL EqualLogic PS6100详解及数据恢办法
DELL EqualLogic PS6100采用虚拟ISCSI SAN阵列,为远程或分支办公室.部门和中小企业存储部署带来企业级功能.智能化.自动化和可靠性,支持VMware.Solaris.Linu ...
- 详解Tensorflow数据读取有三种方式(next_batch)
转自:https://blog.csdn.net/lujiandong1/article/details/53376802 Tensorflow数据读取有三种方式: Preloaded data: 预 ...
- Mycat 分片规则详解--一致性hash分片
实现方式:基于hash算法的分片中,算法内部是把记录分片到一种叫做"bucket"(hash桶)的内部算法结构中的,然后hash桶与实际的分片节点一一对应,从此实现了分片.路由的功 ...
- Mycat 分片规则详解--单月小时分片
实现方式:单月内按照小时拆分,最小粒度是小时,一天最多可以有24个分片,最少1个分片,下个月从头开始循环 优点:使数据按照小时来进行分时存储,颗粒度比日期(天)分片要小,适用于数据采集类存储分片 缺点 ...
- Mycat 分片规则详解--自然月分片
实现方式:按照月份列分片,每个自然月一个分片 优点:使数据按照每月来进行分时存储 缺点:由于数据是连续的,所以该方案不能有效的利用资源 配置示例: <tableRule name="s ...
- Mycat 分片规则详解--固定 hash 分片
实现方式:该算法类似于十进制的求模运算,但是为二进制的操作,例如,取 id 的二进制低 10 位 与 1111111111 进行 & 运算 优点:这种策略比较灵活,可以均匀分配也可以非均匀分配 ...
- Mycat 分片规则详解--取模分片
实现方式:切分规则根据配置中输入的数值n.此种分片规则将数据分成n份(通常dn节点也为n),从而将数据均匀的分布于各节点上. 优点:这种策略可以很好的分散数据库写的压力.比较适合于单点查询的情景 缺点 ...
随机推荐
- [转] Mongoose初使用总结
连接mongoose mongoose连接数据库有两种方式 第一种: 'use strict'; const mongoose = require('mongoose'); mongoose.conn ...
- maven安装和eclipse集成
maven作为一个项目构建工具,在开发的过程中很受欢迎,可以帮助管理项目中的bao依赖问题,另外它的很多功能都极大的减少了开发的难度,下面来介绍maven的安装及与eclipse的集成. maven的 ...
- java 环境安装
因为现在的java安装需要点击同意许可才能安装,造成了在linux中使用wget命令下载无法正常完整下载,即便下载下来也是不完整的 安装会提示 no such file等一堆提示 我们使用参数如下的命 ...
- Directory 类
Directory 类 该类公开,主要用于创建.移动和枚举通过目录和子目录的静态方法.此类不能被继承. 命名空间: System.IO; 程序集: mscorlib(在 msc ...
- 【BZOJ】3730: 震波
原题链接 题解 查询距离一个点距离在一定范围内的点,直接点分树,前缀和用树状数组维护 答案是当前重心距离不超过k - (x到重心距离)的点的前缀和,减去在x所在子树中,距离重心不超过k - (x到重心 ...
- gitlab之三: gitlab邮件通知的配置
参考 : https://www.cnblogs.com/lovelinux199075/p/9072265.html gitlab 添加新用户后,会自动发送邮件到填写的邮箱. 实验版本: 11. ...
- web列表总结
ztree:web树 下拉列表树: jqxgrid列表(带有多选,单选.搜索.分页.分页多选.还有点击下拉等功能) 还有flexigrid(百度搜索)
- NOI2018Day2T1 屠龙勇士 set 扩展欧几里德 中国剩余定理
原文链接https://www.cnblogs.com/zhouzhendong/p/NOI2018Day2T1.html 题目传送门 - 洛谷P4774 题意 题解 首先我们仔细看一看样例可以发现如 ...
- Python3爬虫知识点总结
1.requests获取响应头的方法 eg:获取响应头信息 import requests res = request.head(url).headers print(res)
- uni-app — 一套前端开发跨平台应用的终极解决方案
uni-app 是一个使用 Vue.js 开发跨平台应用的前端框架,开发者编写一套代码,可编译到iOS.Android.H5.小程序等多个平台. 今天有空就来介绍一下uni-app这个能够跨平台开发, ...