
Scrapy基础(十)———同步机制将Item中的数据写在Mysql
前面讲解到将Item中的所有字段都已经填写完成,那么接下来就是将他们存储到mysql数据库中,
那就用到了pipeline项目管道了;
对项目管道的理解:做一个比喻,爬取好比是开采石油,Item装的都是原油,需要通过一系列的管道
和工艺进行提炼,而这些原油都是通过pipeline进行加工的,才能真正的到我们所能使用的油(数据)
大致思路:
1, 安装MySQLdb和连接数据库的驱动mysqlclient,并创建数据库和相应的表,创建和Item的字段
一样的字段(注意各个字段的类型,长度和默认值);这些操作可通过navicat进行操作
2,自定义pipeline,引入mysqldb库,将Item中的数据写入数据库
3,在settings文件中注册这个管道,并给这个管道一个编号(这个管道在哪条工艺之后进行)
具体代码
 #引入操作数据库模块

 import MySQLdb

 class MysqlPipeline(object):

     '''

     同步机制实现mysql写入操作

     '''

     #定义初始化函数,当类被使用时自动调用这个函数,我们让他初始化时就连接上数据库

     def __init__(self):

         #取个变量名,连接数据库,依次是: host,user,password,dbname

         self.conn = MySQLdb.connect("127.0.0.1","root","root","artical_spider")

         #通过cursor()的方法获取游标

         self.cursor = self.conn.cursor()

     #自定义的管道必须有此方法

     def process_item(self,item,spider):

         #要执行的插入sql语句

         insert_sql = """

             insert into jobbole_artical(title,creat_date,url,url_object_id,

                 front_image_url2,front_image_path,tags,comment_num,

                 fav_num,like_num,content

                 )

             VALUES(%s,%s,%s,%s,%s,%s,%s,%s,%s,%s,%s)

         """

         #执行sql语句,注意后面是元组,将Item中的数据格式化填充到插入语句中

         self.cursor.execute(insert_sql,(item["title"],item["creat_date"],item["url"],

             item["url_object_id"],item["front_image_url2"],item["front_image_path"],

             item["tags"],item["comment_num"],item["fav_num"],item["like_num"],item["content"]))

         #将sql语句提交到数据库执行

         self.conn.commint()
注意:
一:
我们从前设置过
artical_item["front_image_url"] = [front_image_url]
这个Item是一个列表类型,当你写入数据库时候报错,
File "C:\Users\Administrator\Envs\artical_spider\lib\site-packages\MySQLdb\converters.py", line 90, in quote_tuple
return "(%s)" % (','.join(escape_sequence(t, d)))
TypeError: sequence item 0: expected str instance, bytes found
当我们改为str时图片的下载路径又不能正常工作,
所以只能添加一个新的一样的Item,一个设置为列表,供图片下载,一个为写入数据库中做准备
二:
对于数据库各个字段的设置,这里可将一些字段设置为不为空,并且设置一些字段的默认值;
这里讲url_object_id设置成主键,主键不能为空且唯一;在
在写入数据库时,各个字段要和Item字段的顺序相对应
三:
关于python对数据库的操作,本篇参考了这篇博文
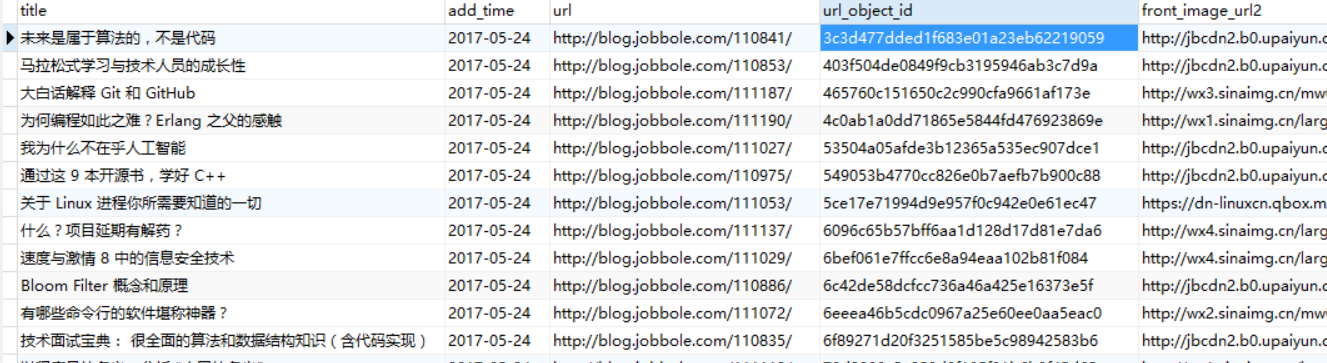
以下是运行结果
'''
Scrapy基础(十)———同步机制将Item中的数据写在Mysql的更多相关文章
- Scrapy基础(十二)————异步导出Item数据到Mysql中
异步导出数据到Mysql中 上次说过从Item中同步写入数据库,因为网络的下载速度和数据库的I/O速度是不一样的所以有可能会发生下载快,但是写入数据库速度慢,造成线程的堵塞:关于堵塞和非堵塞,同步和异 ...
- C#同步SQL Server数据库中的数据--数据库同步工具[同步新数据]
C#同步SQL Server数据库中的数据 1. 先写个sql处理类: using System; using System.Collections.Generic; using System.Dat ...
- 使用Python将Excel中的数据导入到MySQL
使用Python将Excel中的数据导入到MySQL 工具 Python 2.7 xlrd MySQLdb 安装 Python 对于不同的系统安装方式不同,Windows平台有exe安装包,Ubunt ...
- Sql Server中的数据类型和Mysql中的数据类型的对应关系(转)
Sql Server中的数据类型和Mysql中的数据类型的对应关系(转):https://blog.csdn.net/lilong329329/article/details/78899477 一.S ...
- 浅谈利用同步机制解决Java中的线程安全问题
我们知道大多数程序都不会是单线程程序,单线程程序的功能非常有限,我们假设一下所有的程序都是单线程程序,那么会带来怎样的结果呢?假如淘宝是单线程程序,一直都只能一个一个用户去访问,你要在网上买东西还得等 ...
- 机器学习实战基础(十五):sklearn中的数据预处理和特征工程(八)特征选择 之 Filter过滤法(二) 相关性过滤
相关性过滤 方差挑选完毕之后,我们就要考虑下一个问题:相关性了. 我们希望选出与标签相关且有意义的特征,因为这样的特征能够为我们提供大量信息.如果特征与标签无关,那只会白白浪费我们的计算内存,可能还会 ...
- (转)SQLServer_十步优化SQL Server中的数据访问 三
原文地址:http://tech.it168.com/a2009/1125/814/000000814758_all.shtml 第六步:应用高级索引 实施计算列并在这些列上创建索引 你可能曾经写过从 ...
- (转)SQLServer_十步优化SQL Server中的数据访问一
原文地址:http://tech.it168.com/a2009/1125/814/000000814758_all.shtml 第一步:应用正确的索引 我之所以先从索引谈起是因为采用正确的索引会使生 ...
- (转)SQLServer_十步优化SQL Server中的数据访问 二
原文地址:http://tech.it168.com/a2009/1125/814/000000814758_all.shtml 第五步:识别低效TSQL,采用最佳实践重构和应用TSQL 由于每个程序 ...
随机推荐
- MySQL基于ROW格式的数据恢复
大家都知道MySQL Binlog 有三种格式,分别是Statement.Row.Mixd.Statement记录了用户执行的原始SQL,而Row则是记录了行的修改情况,在MySQL 5.6以上的版本 ...
- 论文阅读笔记一:Tutorial on Gabor Filters
时域下的一维Gabor滤波器: 可以将Gabor滤波器看作是两个输出两个相位的滤波器,分别在实数域和虚数域上. 实数域上滤波器为: 虚数域上滤波器为: 傅里叶变换为频域: 上述两个滤波器对频率敏感,为 ...
- Django主线
Django怎么学: 参考地址:https://www.zhihu.com/question/26235428 需要了解的知识点: Django Url请求流程 首要操作 Django的安装 pip3 ...
- Spark的Streaming和Spark的SQL简单入门学习
1.Spark Streaming是什么? a.Spark Streaming是什么? Spark Streaming类似于Apache Storm,用于流式数据的处理.根据其官方文档介绍,Spark ...
- 使用 cacti 监控 windows 服务器硬盘的 I/O 状况
https://blog.csdn.net/m0_37814112/article/details/80742433
- RPC服务超时排查思路
RPC服务超时排查思路- 1.查看服务提供者日志相关信息进行排查- 2.查看消费者的超时时间设置是否合理- 3.查看服务提供者业务逻辑是否有DB操作,有的话看是否有慢SQL- 4.查看服务提供者业务逻 ...
- [转] js中的事件委托或是事件代理详解
起因: 1.这是前端面试的经典题型,要去找工作的小伙伴看看还是有帮助的: 2.其实我一直都没弄明白,写这个一是为了备忘,二是给其他的知其然不知其所以然的小伙伴们以参考: 概述: 那什么叫事件委托呢?它 ...
- 3998: [TJOI2015]弦论
题解: 每个点的size值就是这个从根-它出现的次数 如果相同只算一次就全部赋值为1就可以了 代码: #include <bits/stdc++.h> #define ll long lo ...
- Nginx配置多个基于域名的虚拟主机+实验环境搭建+测试
标签:Linux 域名 Nginx 原创作品,允许转载,转载时请务必以超链接形式标明文章 原始出处 .作者信息和本声明.否则将追究法律责任.http://xpleaf.blog.51cto.com/9 ...
- python全栈开发day64-模板-变量和(.)的使用,filters和自定义filter
一.上周内容回顾 day64 内容回顾: 1. 所有的django命令 1. 安装 pip install django==1.11.14 pip install -i 源 django==1.11. ...