
Hadoop案例(十)WordCount
WordCount案例
需求1:统计一堆文件中单词出现的个数(WordCount案例)
0)需求:在一堆给定的文本文件中统计输出每一个单词出现的总次数
1)数据准备:Hello.txt
hello world

dog fish

hadoop

spark

hello world

dog fish

hadoop

spark

hello world

dog fish

hadoop

spark
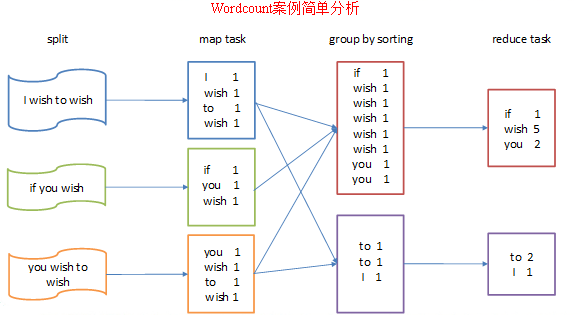
2)分析
按照mapreduce编程规范,分别编写Mapper,Reducer,Driver。

3)编写程序
(1)定义一个mapper类
package com.xyg.wordcount;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

/**

 * KEYIN:默认情况下,是mr框架所读到的一行文本的起始偏移量,Long;

 * 在hadoop中有自己的更精简的序列化接口,所以不直接用Long,而是用LongWritable

 * VALUEIN:默认情况下,是mr框架所读到的一行文本内容,String;此处用Text

 * KEYOUT:是用户自定义逻辑处理完成之后输出数据中的key,在此处是单词,String;此处用Text

 * VALUEOUT,是用户自定义逻辑处理完成之后输出数据中的value,在此处是单词次数,Integer,此处用IntWritable

 * @author Administrator

 */

public class WordcountMapper extends Mapper<LongWritable, Text, Text, IntWritable>{

    /**

     * map阶段的业务逻辑就写在自定义的map()方法中

     * maptask会对每一行输入数据调用一次我们自定义的map()方法

     */

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        // 1 将maptask传给我们的文本内容先转换成String

        String line = value.toString();

        // 2 根据空格将这一行切分成单词

        String[] words = line.split(" ");

        // 3 将单词输出为<单词,1>

        for(String word:words){

            // 将单词作为key,将次数1作为value,以便于后续的数据分发,可以根据单词分发,以便于相同单词会到相同的reducetask中

            context.write(new Text(word), new IntWritable());

        }

    }

}
(2)定义一个reducer类
package com.xyg.wordcount;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

/**

 * KEYIN , VALUEIN 对应mapper输出的KEYOUT, VALUEOUT类型

 * KEYOUT,VALUEOUT 对应自定义reduce逻辑处理结果的输出数据类型 KEYOUT是单词 VALUEOUT是总次数

 */

public class WordcountReducer extends Reducer<Text, IntWritable, Text, IntWritable> {

    /**

     * key,是一组相同单词kv对的key

     */

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

        int count = ;

        // 1 汇总各个key的个数

        for(IntWritable value:values){

            count +=value.get();

        }

        // 2输出该key的总次数

        context.write(key, new IntWritable(count));

    }

}
(3)定义一个主类,用来描述job并提交job
package com.xyg.wordcount;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

/**

 * 相当于一个yarn集群的客户端,

 * 需要在此封装我们的mr程序相关运行参数,指定jar包

 * 最后提交给yarn

 * @author Administrator

 */

public class WordcountDriver {

    public static void main(String[] args) throws Exception {

        // 1 获取配置信息,或者job对象实例

        Configuration configuration = new Configuration();

        // 8 配置提交到yarn上运行,windows和Linux变量不一致

//        configuration.set("mapreduce.framework.name", "yarn");

//        configuration.set("yarn.resourcemanager.hostname", "node22");

        Job job = Job.getInstance(configuration);

        // 6 指定本程序的jar包所在的本地路径

//        job.setJar("/home/admin/wc.jar");

        job.setJarByClass(WordcountDriver.class);

        // 2 指定本业务job要使用的mapper/Reducer业务类

        job.setMapperClass(WordcountMapper.class);

        job.setReducerClass(WordcountReducer.class);

        // 3 指定mapper输出数据的kv类型

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(IntWritable.class);

        // 4 指定最终输出的数据的kv类型

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        // 5 指定job的输入原始文件所在目录

        FileInputFormat.setInputPaths(job, new Path(args[]));

        FileOutputFormat.setOutputPath(job, new Path(args[]));

        // 7 将job中配置的相关参数,以及job所用的java类所在的jar包, 提交给yarn去运行

//        job.submit();

        boolean result = job.waitForCompletion(true);

        System.exit(result?:);

    }

}
4)集群上测试
(1)将程序打成jar包,然后拷贝到hadoop集群中。
(2)启动hadoop集群
(3)执行wordcount程序
[admin@node21 module]$ hadoop jar wc.jar com.xyg.wordcount.WordcountDriver /user/admin/input /user/admin/output
5)本地测试
(1)在windows环境上配置HADOOP_HOME环境变量。
(2)在eclipse上运行程序
(3)注意:如果eclipse打印不出日志,在控制台上只显示
1.log4j:WARN No appenders could be found for logger (org.apache.hadoop.util.Shell).

2.log4j:WARN Please initialize the log4j system properly.

3.log4j:WARN See http://logging.apache.org/log4j/1.2/faq.html#noconfig for more info.
需要在项目的src目录下,新建一个文件,命名为“log4j.properties”,在文件中填入
log4j.rootLogger=INFO, stdout

log4j.appender.stdout=org.apache.log4j.ConsoleAppender

log4j.appender.stdout.layout=org.apache.log4j.PatternLayout

log4j.appender.stdout.layout.ConversionPattern=%d %p [%c] - %m%n

log4j.appender.logfile=org.apache.log4j.FileAppender

log4j.appender.logfile.File=target/spring.log

log4j.appender.logfile.layout=org.apache.log4j.PatternLayout

log4j.appender.logfile.layout.ConversionPattern=%d %p [%c] - %m%n
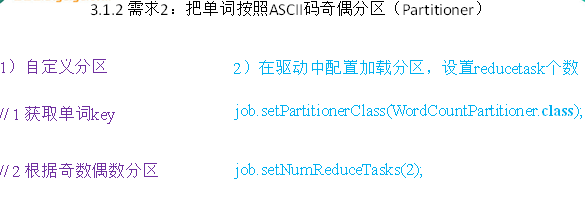
需求2:把单词按照ASCII码奇偶分区(Partitioner)
0)分析
1)自定义分区
package com.xyg.mapreduce.wordcount;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Partitioner;

public class WordCountPartitioner extends Partitioner<Text, IntWritable>{

    @Override

    public int getPartition(Text key, IntWritable value, int numPartitions) {

        // 1 获取单词key

        String firWord = key.toString().substring(, );

        char[] charArray = firWord.toCharArray();

        int result = charArray[];

        // int result  = key.toString().charAt(0);

        // 2 根据奇数偶数分区

        if (result %  == ) {

            return ;

        }else {

            return ;

        }

    }

}
2)在驱动中配置加载分区,设置reducetask个数
job.setPartitionerClass(WordCountPartitioner.class);

job.setNumReduceTasks(2);
需求3:对每一个maptask的输出局部汇总(Combiner)
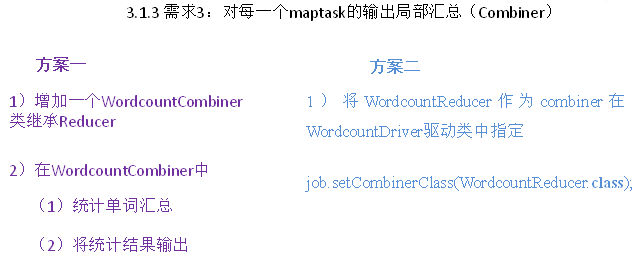
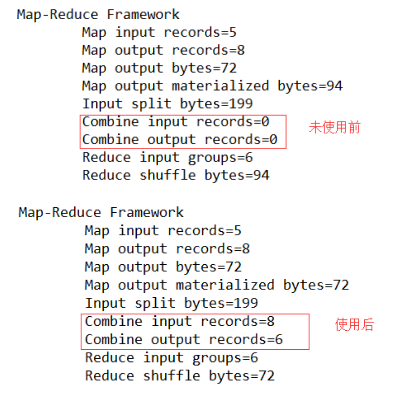
0)需求:统计过程中对每一个maptask的输出进行局部汇总,以减小网络传输量即采用Combiner功能。
1)数据准备:hello,txt
方案一
1)增加一个WordcountCombiner类继承Reducer
package com.xyg.mr.combiner;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

public class WordcountCombiner extends Reducer<Text, IntWritable, Text, IntWritable>{

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

        int count = ;

        for(IntWritable v :values){

            count += v.get();

        }

        context.write(key, new IntWritable(count));

    }

}
2)在WordcountDriver驱动类中指定combiner
//9 指定需要使用combiner,以及用哪个类作为combiner的逻辑

job.setCombinerClass(WordcountCombiner.class);
方案二
1)将WordcountReducer作为combiner在WordcountDriver驱动类中指定
//9 指定需要使用combiner,以及用哪个类作为combiner的逻辑

job.setCombinerClass(WordcountReducer.class);
运行程序
需求4:大量小文件的切片优化(CombineTextInputFormat)
0)需求:将输入的大量小文件合并成一个切片统一处理。
1)输入数据:准备5个小文件
2)实现过程
(1)不做任何处理,运行需求1中的wordcount程序,观察切片个数为5

(2)在WordcountDriver中增加如下代码,运行程序,并观察运行的切片个数为1
// 如果不设置InputFormat,它默认用的是TextInputFormat.class

job.setInputFormatClass(CombineTextInputFormat.class);

CombineTextInputFormat.setMaxInputSplitSize(job, 4194304);// 4m

CombineTextInputFormat.setMinInputSplitSize(job, 2097152);// 2m

Hadoop案例(十)WordCount的更多相关文章
- hadoop安装与WordCount例子
1.JDK安装 下载网址: http://www.oracle.com/technetwork/java/javase/downloads/jdk-6u29-download-513648.html ...
- Hadoop(十五)MapReduce程序实例
一.统计好友对数(去重) 1.1.数据准备 joe, jon joe , kia joe, bob joe ,ali kia, joe kia ,jim kia, dee dee ,kia dee, ...
- Hadoop3 在eclipse中访问hadoop并运行WordCount实例
前言: 毕业两年了,之前的工作一直没有接触过大数据的东西,对hadoop等比较陌生,所以最近开始学习了.对于我这样第一次学的人,过程还是充满了很多疑惑和不解的,不过我采取的策略是还是先让环 ...
- Hadoop示例程序WordCount详解及实例(转)
1.图解MapReduce 2.简历过程: Input: Hello World Bye World Hello Hadoop Bye Hadoop Bye Hadoop Hello Hadoop M ...
- Hadoop入门程序WordCount的执行过程
首先编写WordCount.java源文件,分别通过map和reduce方法统计文本中每个单词出现的次数,然后按照字母的顺序排列输出, Map过程首先是多个map并行提取多个句子里面的单词然后分别列出 ...
- Hadoop入门经典:WordCount
转:http://blog.csdn.net/jediael_lu/article/details/38705371 以下程序在hadoop1.2.1上测试成功. 本例先将源代码呈现,然后详细说明执行 ...
- Hadoop示例程序WordCount编译运行
首先确保Hadoop已正确安装及运行. 将WordCount.java拷贝出来 $ cp ./src/examples/org/apache/hadoop/examples/WordCount.jav ...
- 运行第一个Hadoop程序,WordCount
系统: Ubuntu14.04 Hadoop版本: 2.7.2 参照http://www.cnblogs.com/taichu/p/5264185.html中的分享,来学习运行第一个hadoop程序. ...
- Hadoop入门实例——WordCount统计单词
首先要说明的是运行Hadoop需要jdk1.6或以上版本,如果你还没有搭建好Hadoop集群,请参考我的另一篇文章: Linux环境搭建Hadoop伪分布模式 马上进入正题. 1.启动Hadoop集群 ...
随机推荐
- P2207 Photo
P2207 Photo 题目描述 Framer Jhon 打算给他的N头奶牛照相,( 2 <= N <= 1 000 000 000) . 他们排成一条线,并且依次取1~N作为编号. 每一 ...
- Spring Boot 使用properties如何多环境配置
当我们使用properties文件作为Spring Boot的配置文件而不是yaml文件时,怎样实现多环境使用不同的配置信息呢? 在Spring Boot中,多环境配置的文件名需要满足 ...
- 【数据库-MySql】清空所有表格的所有数据
方式一. drop procedure if exists del_all_tb; delimiter $$ create procedure del_all_tb(db char(20)) begi ...
- CF&&CC百套计划1 Codeforces Round #449 A. Nephren gives a riddle
http://codeforces.com/contest/896/problem/A 第i个字符串嵌套第i-1个字符串 求第n个字符串的第k个字母 dfs #include<map> # ...
- 七、新时间日期 API
一.使用 LocalDate. LocalTime. LocalDateTime LocalDate. LocalTime. LocalDateTime 类的实例是不可变的对象,分别表示使用 ISO- ...
- centos无法通过ssh连接的解决
系统环境是centos7,虚拟机环境下的.在使用ssh工具连接虚拟机的时候发现连接不上,用的是root 先检查openssh-server是否安装: yum list installed | grep ...
- iframe元素的学习(笔记)
什么是iframe:iframe元素即内联框架,iframe是内联的并且承前启后,对于外围的页面,iframe是一个普通的元素,对于iframe里面的内容,又是一个五脏俱全的页面.重下面的写法可以看出 ...
- 如何给自己的PHP项目制作安装程序
最近很是激动啊,现在的自己还是和当初刚刚学习程序的时候一样,虽然现在回头一看自己写过的程序,都非常的小孩子和漏洞百出,也没有太多的考虑效率和安全,但是还是每次写出了新的程序或系统,都是抱着一种马上拿着 ...
- IIS 无法显示网页问题
今天服务器上的项目突然无法访问,之前也碰到过,都是重启服务器解决的,因为重启IIS无效,另外检查发现w3wp.exe进程正常,其他端口及相关的都没什么问题,最后无奈只能想到用重启来解决了,今天又出现这 ...
- [php]mysql操作流程
这种是比较老的一种mysql连接方法 1.连接数据库 $this->con = mysql_connect($this->host, $this->user, $this->p ...