
Spark程序本地运行
Spark程序本地运行
本次安装是在JDK安装完成的基础上进行的! SPARK版本和hadoop版本必须对应!!!
spark是基于hadoop运算的,两者有依赖关系,见下图:
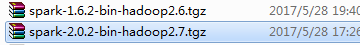
前言:
1.环境变量配置:
1.1 打开“控制面板”选项

1.2.找到“系统”选项卡
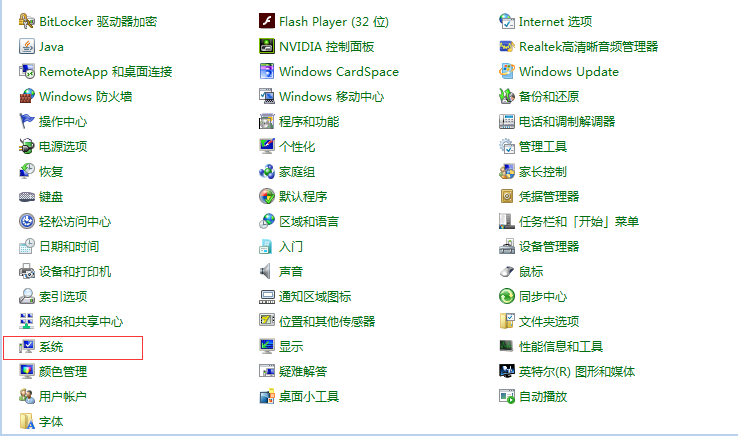
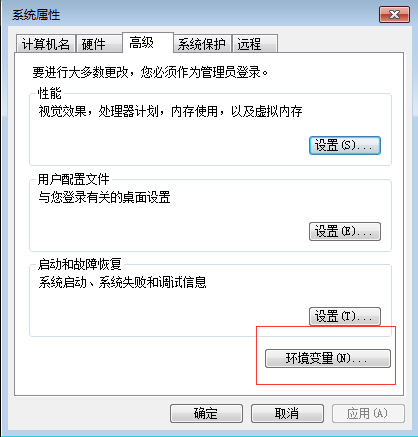
1.3.点击“高级系统设置”

1.4.点击“环境变量”
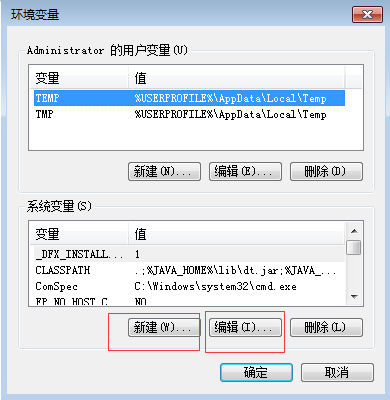
2.新建和编辑环境变量
1.下载hadoop-2.6.0.tar.gz文件,并解压在本地
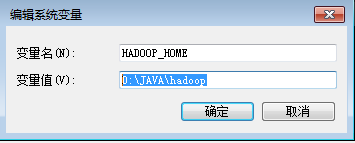
1.1 新建环境变量上配置
HADOOP_HOME

D:\JAVA\hadoop
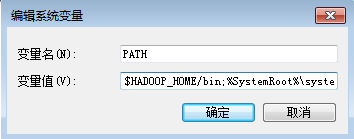
1.2 修改PATH路径
$HADOOP_HOME/bin;
2.下载scala-2.10.6.zip文件,并解压在本地
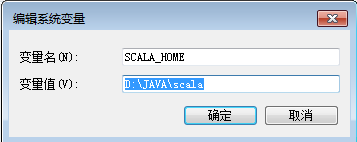
2.1 新建环境变量上配置
SCALA_HOME
D:\JAVA\scala
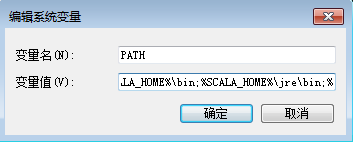
2.2 修改PATH路径
%SCALA_HOME%\bin;%SCALA_HOME%\jre\bin;
3.下载spark-1.6.2-bin-hadoop2.6.tgz文件,并解压在本地
3.1 新建环境变量上配置
SPARK_HOME
D:\JAVA\spark_home\bin
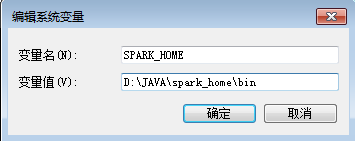
3.2 修改PATH路径
PATH

$SPARK_HOME/bin;
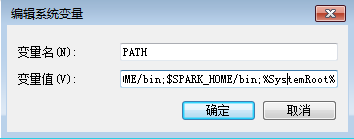
4.下载scala-IDE.zip文件,并解压在本地
新建一个工程,修改library:
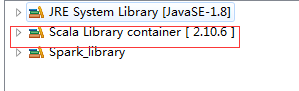
Scala library一定要是:2.10.X
新建一个自己的library:添加一个Jar文件(${spark_home}/lib)
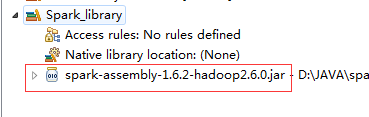
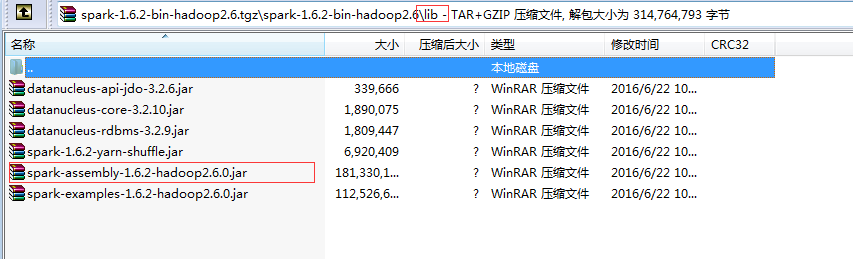
下跟Word Count代码

package com

import org.apache.spark.SparkConf

import org.apache.spark.api.java.JavaSparkContext

import org.apache.spark.SparkContext

/**

 * 统计字符出现次数

 */

object WordCount {

  def main(args: Array[String]): Unit = {

         System.setProperty("hadoop.home.dir", "D:\\JAVA\\hadoop");

         val sc = new SparkContext("local", "My App")

         val line = sc.textFile("/srv/1.txt")

         line.map((_, 1)).reduceByKey(_+_).collect().foreach(println)

         sc.stop()

    println(111111)

  }

}
hadoop下载点击这里
spark下载点击这里
scala安装包,scala IDE下载点击这里
Spark程序本地运行的更多相关文章
- spark 程序 windows 运行报错
1 java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries. at ...
- spark window本地运行wordcount错误
在运行本地运行spark或者hadoop代码时可能会遇到一下三种问题 1.Exception in thread "main" java.lang.UnsatisfiedLin ...
- 在local模式下的spark程序打包到集群上运行
一.前期准备 前期的环境准备,在Linux系统下要有Hadoop系统,spark伪分布式或者分布式,具体的教程可以查阅我的这两篇博客: Hadoop2.0伪分布式平台环境搭建 Spark2.4.0伪分 ...
- scala IDE for Eclipse开发Spark程序
1.开发环境准备 scala IDE for Eclipse:版本(4.6.1) 官网下载:http://scala-ide.org/download/sdk.html 百度云盘下载:链接:http: ...
- 初识Spark程序
执行第一个spark程序 普通模式提交任务: bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master spark ...
- [Spark]如何设置使得spark程序不输出 INFO级别的内容
Spark程序在运行的时候,总是输出很多INFO级别内容 查看了网上的一些文章,进行了试验. 发现在 /etc/spark/conf 目录下,有一个 log4j.properties.template ...
- spark之scala程序开发(本地运行模式):单词出现次数统计
准备工作: 将运行Scala-Eclipse的机器节点(CloudDeskTop)内存调整至4G,因为需要在该节点上跑本地(local)Spark程序,本地Spark程序会启动Worker进程耗用大量 ...
- 如何在本地使用scala或python运行Spark程序
如何在本地使用scala或python运行Spark程序 包含两个部分: 本地scala语言编写程序,并编译打包成jar,在本地运行. 本地使用python语言编写程序,直接调用spark的接口, ...
- Spark认识&环境搭建&运行第一个Spark程序
摘要:Spark作为新一代大数据计算引擎,因为内存计算的特性,具有比hadoop更快的计算速度.这里总结下对Spark的认识.虚拟机Spark安装.Spark开发环境搭建及编写第一个scala程序.运 ...
随机推荐
- Trystrtofloat
TryStrToFloat为 ‘+1’和‘-1’和 ‘.1’是可以装换成功的
- Android-WebViewUtils-工具类
WebViewUtils-工具类是专门处理,Android API 中的WebView使用,公共方法抽取定义: package common.library.utils; import android ...
- Checkpoint--实现步骤
Checkpoint 实现步骤: 1.将CheckPoint标记写入日志(标记中包含当前数据库中活动的事务信息),并将Log Block写入持久化存储 2.将Buffer Pool中所有的脏页写入磁盘 ...
- WebAPI开发中的定时处理
https://blog.csdn.net/lordwish/article/details/77931897
- nodejs vinyl-fs 处理文件时输入问题
使用 nodejs vinyl-fs 复制文件时输出路径不对,还是会有原来的相对路径,原因是用了反斜杠“\”,正斜杠“/”没问题 测试过程 node版本: v9.3.0 系统:win10 步骤: 得到 ...
- 构建NetCore应用框架之实战篇(五):BitAdminCore框架1.0登录功能设计实现及源码
本篇承接上篇内容,如果你不小心点击进来,建议从第一篇开始完整阅读,文章内容继承性连贯性. 构建NetCore应用框架之实战篇系列 一.设计原则 1.继承前面框架架构思维,设计以可读性作为首要目标. 2 ...
- 自定义两个控件,一个是显示图标和文字的矩形,一个是带边框的label(但是不是label)
记录遇到的两个坑 坑1. 一开始我继承button 来实现下面的控件1,后面发现button没有双击事件.就改成继承UserControl了.重新编译,导致设计时的控件文本全部被清空,因为UserCo ...
- C# Po3协议读取邮件内容遇到的问题
背景:最近在做一个小工具,读取PO3协议邮件服务器的指定人员的邮件,东西做出来了,弄了一个While死循环,20秒执行一次, 结果运行了3天,周一来IT人员找上门来了,你的电脑什么情况,怎么一个小时下 ...
- ueditor图片上传插件的使用
在项目里使用到ueditor图片上传插件,以前图片上传都是直接使用js代码直接上传图片,比较麻烦,而且效率也比较低,而ueditor这款插件完美的解决了这个问题,这个是百度开发的一款富文本编辑器,在这 ...
- Json/XML序列化和反序列化
1.json序列化和反序列化 序列化是将对象状态转换为可保持或传输的格式的过程; 反序列化,它将流转换为对象; 1)Json.Net 推荐使用Json.Net类库,需要引入的命名空间; 序列化:Jso ...