
python之爬取练习
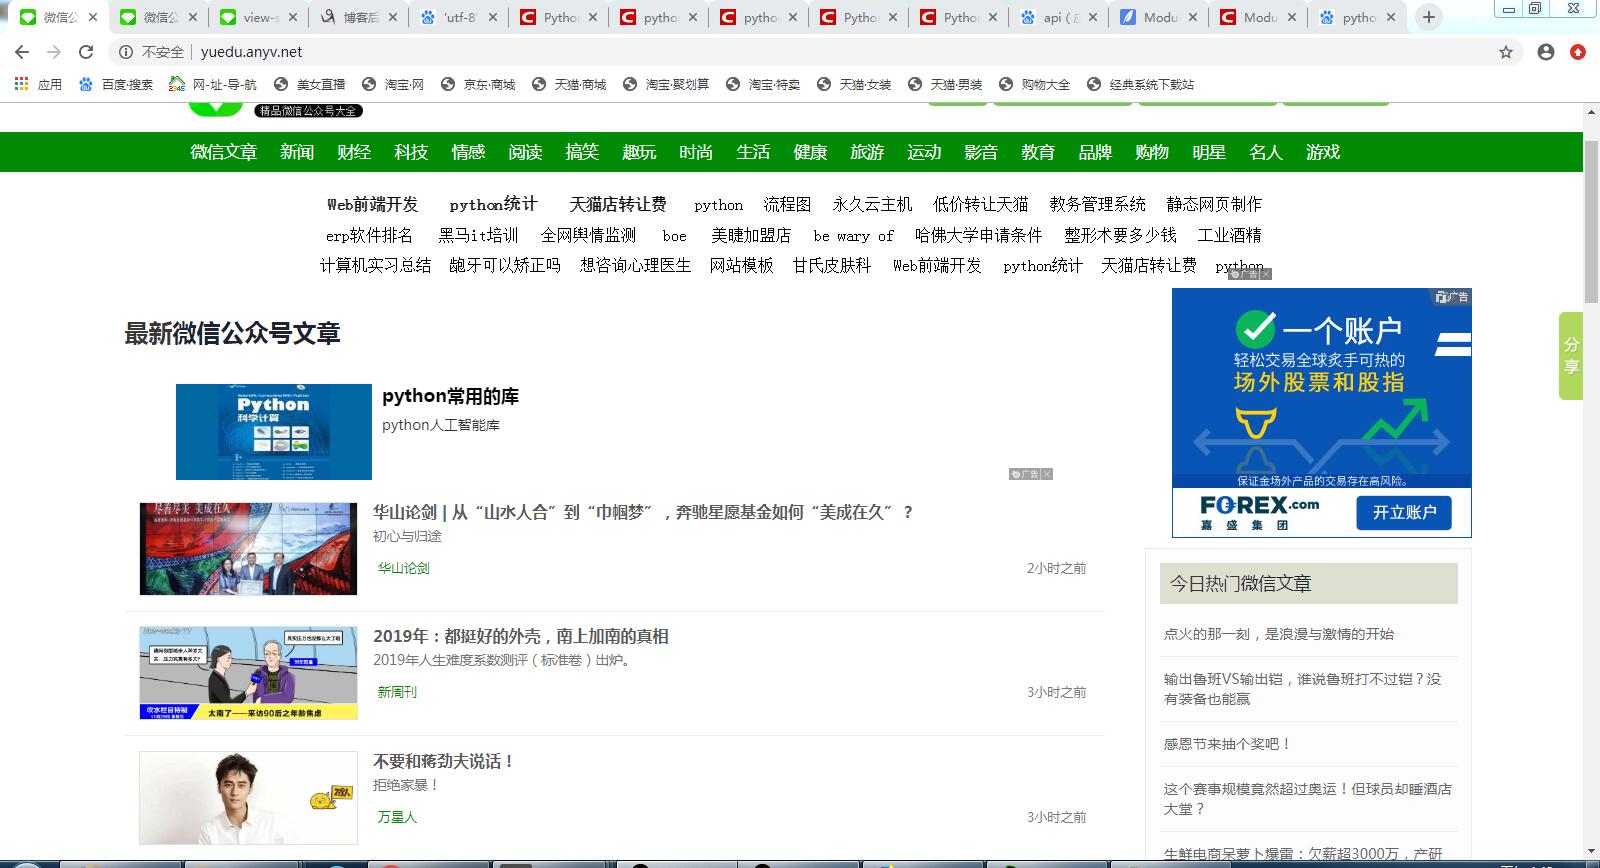
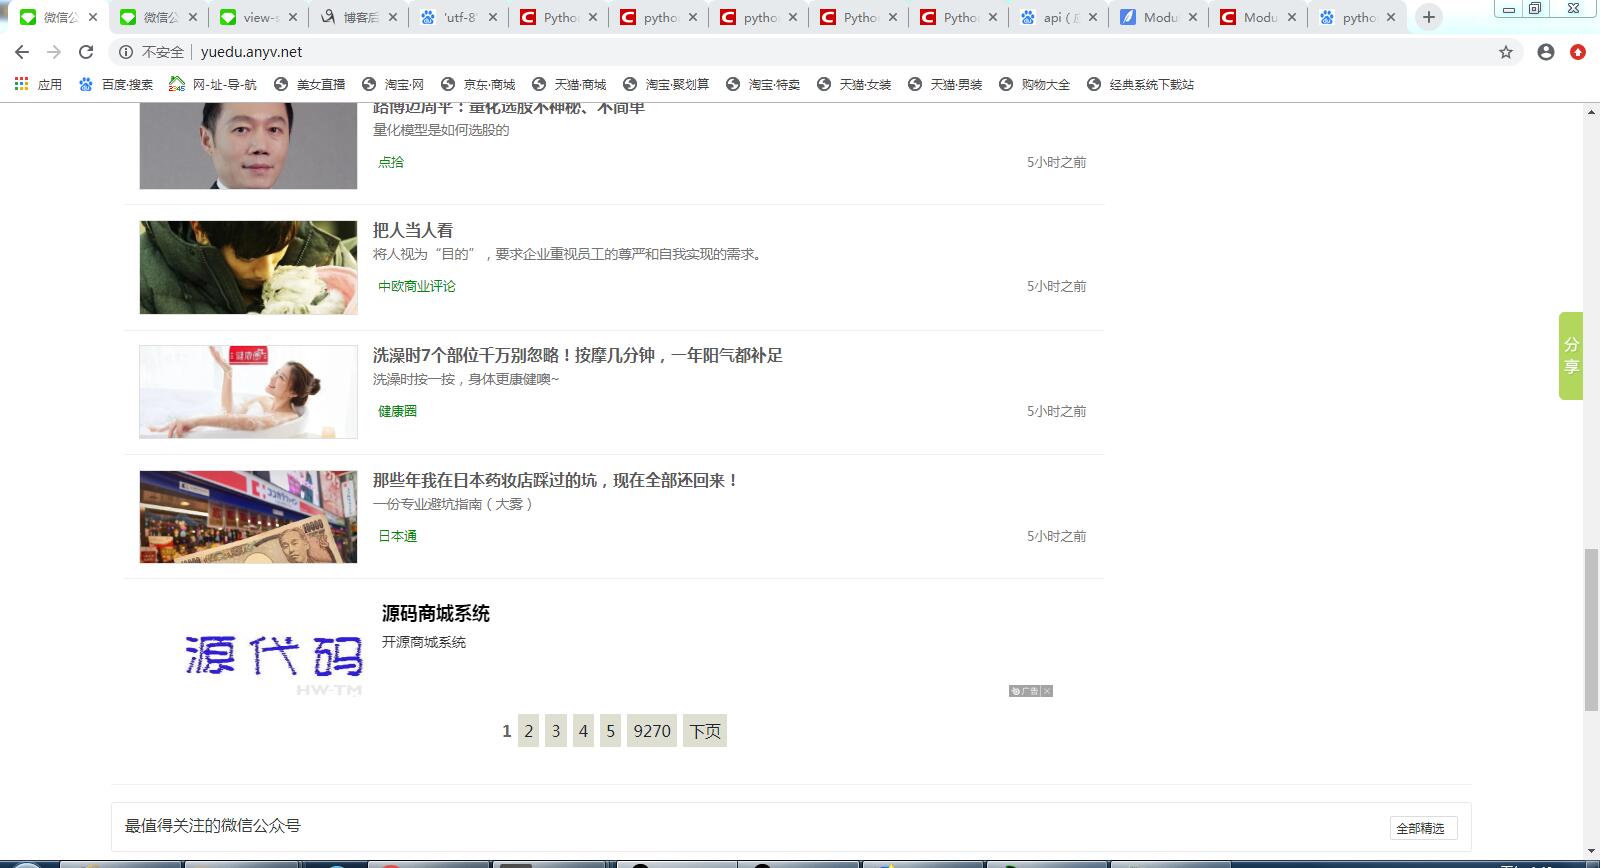
练习要求爬取http://yuedu.anyv.net/网址的最大页码数和文章标题和链接
网址页面截图:
代码截图:
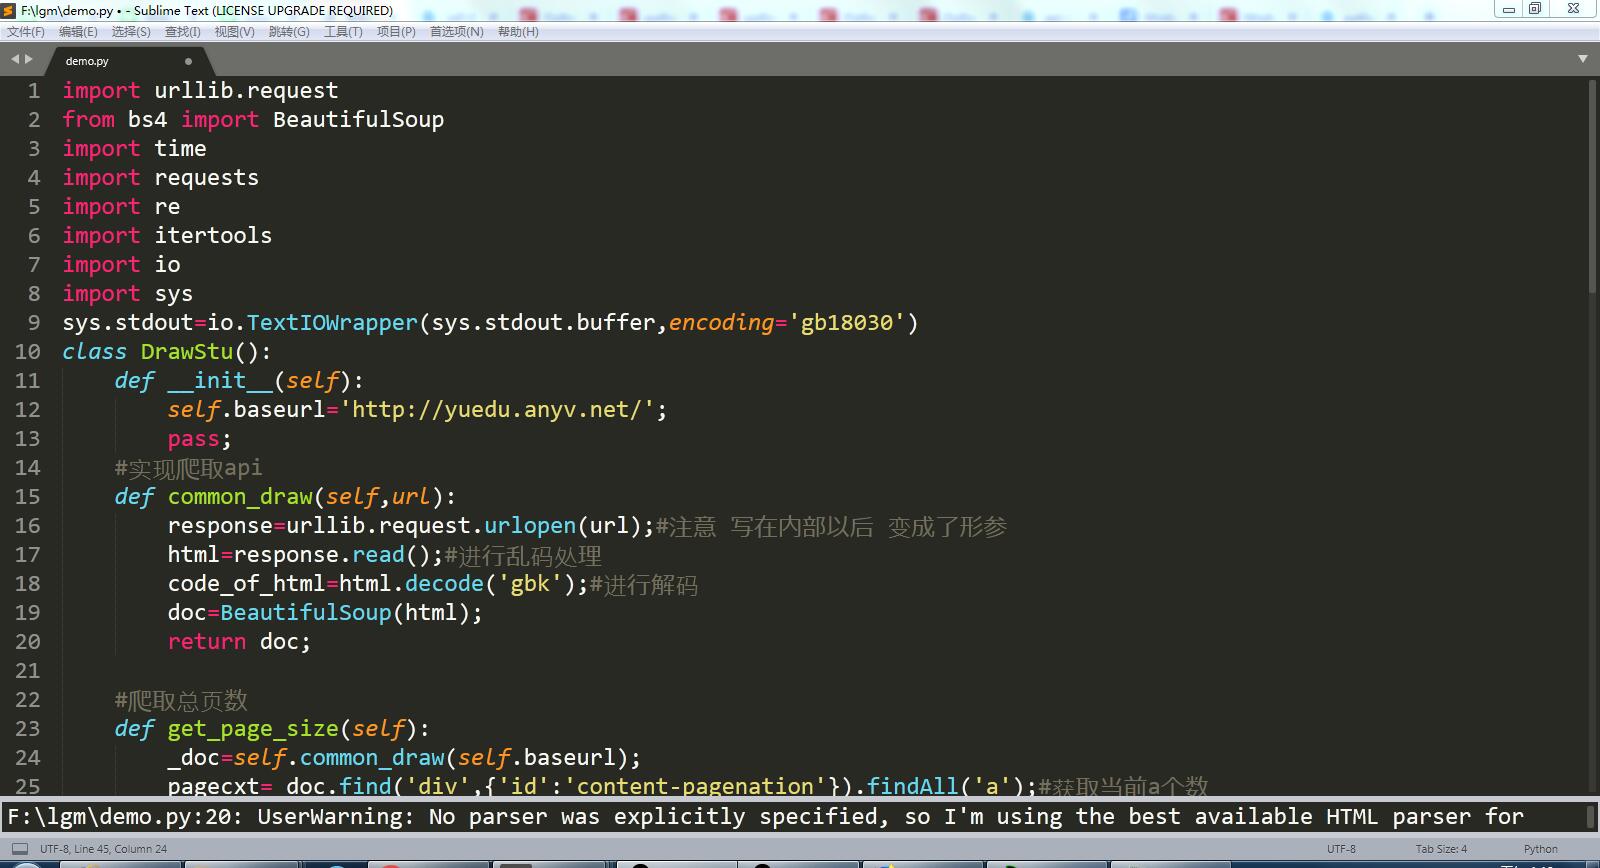
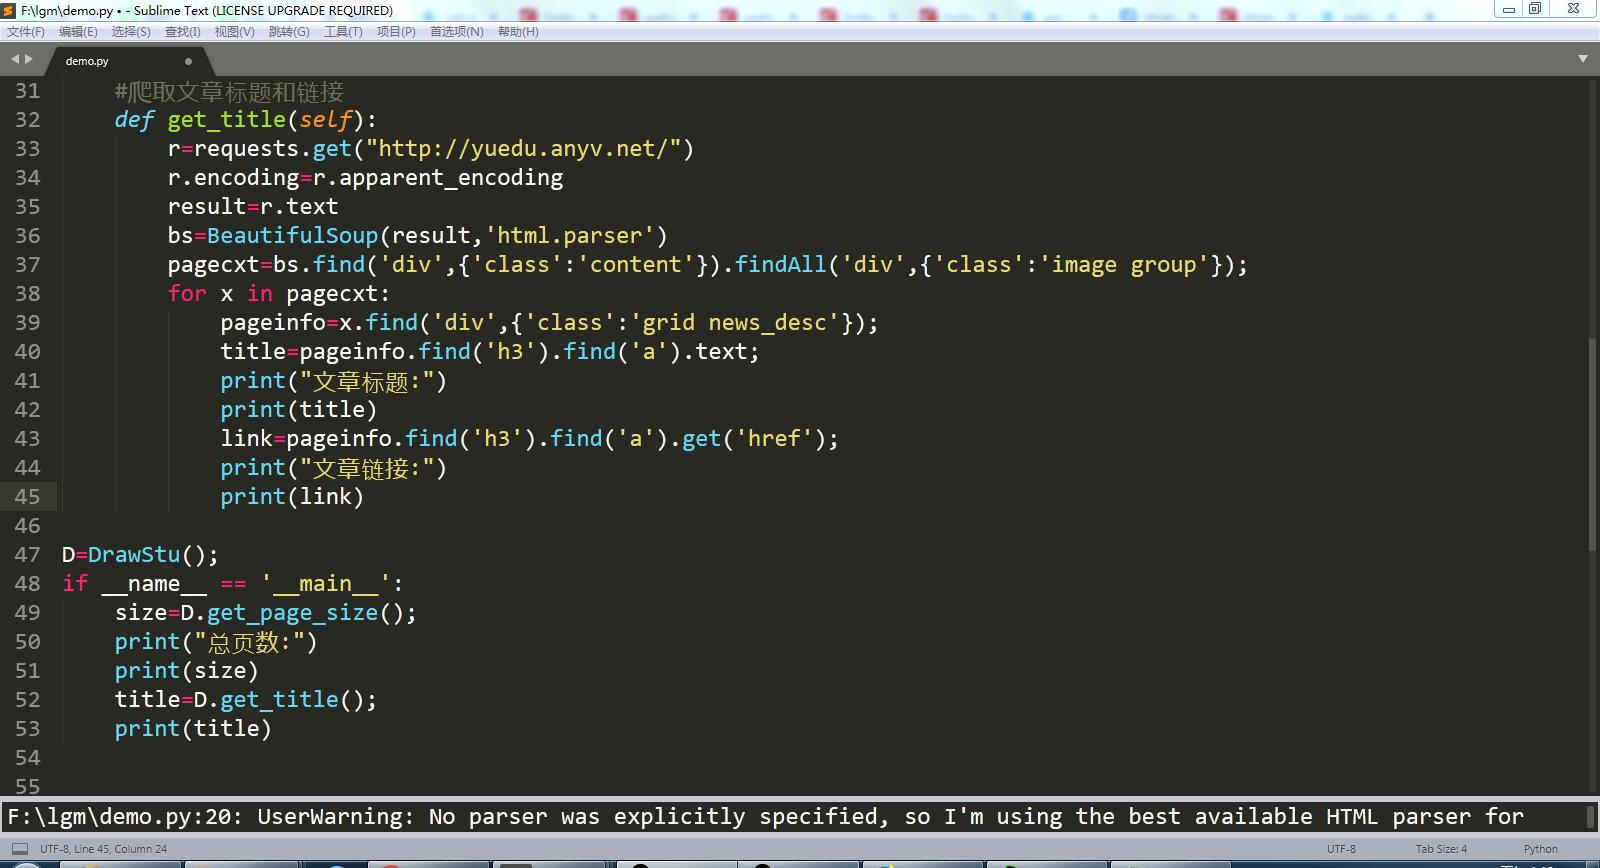
完整代码:
根据网页显示页码的方式,爬取的所有页码中倒数第二个页码是最大页码。
import urllib.request

from bs4 import BeautifulSoup

import time

import requests

import re

import itertools

import io

import sys

sys.stdout=io.TextIOWrapper(sys.stdout.buffer,encoding='gb18030')

class DrawStu():

    def __init__(self):

        self.baseurl='http://yuedu.anyv.net/';

        pass;

    #实现爬取api

    def common_draw(self,url):

        response=urllib.request.urlopen(url);#注意 写在内部以后 变成了形参

        html=response.read();#进行乱码处理

        code_of_html=html.decode('gbk');#进行解码

        doc=BeautifulSoup(html);

        return doc;

    #爬取总页数

    def get_page_size(self):

        _doc=self.common_draw(self.baseurl);

        pagecxt=_doc.find('div',{'id':'content-pagenation'}).findAll('a');#获取当前a个数

        size=len(pagecxt);

        maxsize=pagecxt[size-].text;#获取倒数第二个进行获取里面值就是最大值

        maxsize=int(maxsize)

        return maxsize;

    #爬取文章标题和链接

    def get_title(self):

        r=requests.get("http://yuedu.anyv.net/")

        r.encoding=r.apparent_encoding

        result=r.text

        bs=BeautifulSoup(result,'html.parser')

        pagecxt=bs.find('div',{'class':'content'}).findAll('div',{'class':'image group'});

        for x in pagecxt:

            pageinfo=x.find('div',{'class':'grid news_desc'});

            title=pageinfo.find('h3').find('a').text;

            print("文章标题:")

            print(title)

            link=pageinfo.find('h3').find('a').get('href');

            print("文章链接:")

            print(link)

D=DrawStu();

if __name__ == '__main__':

    size=D.get_page_size();

    print("总页数:")

    print(size)

    title=D.get_title();

    print(title)
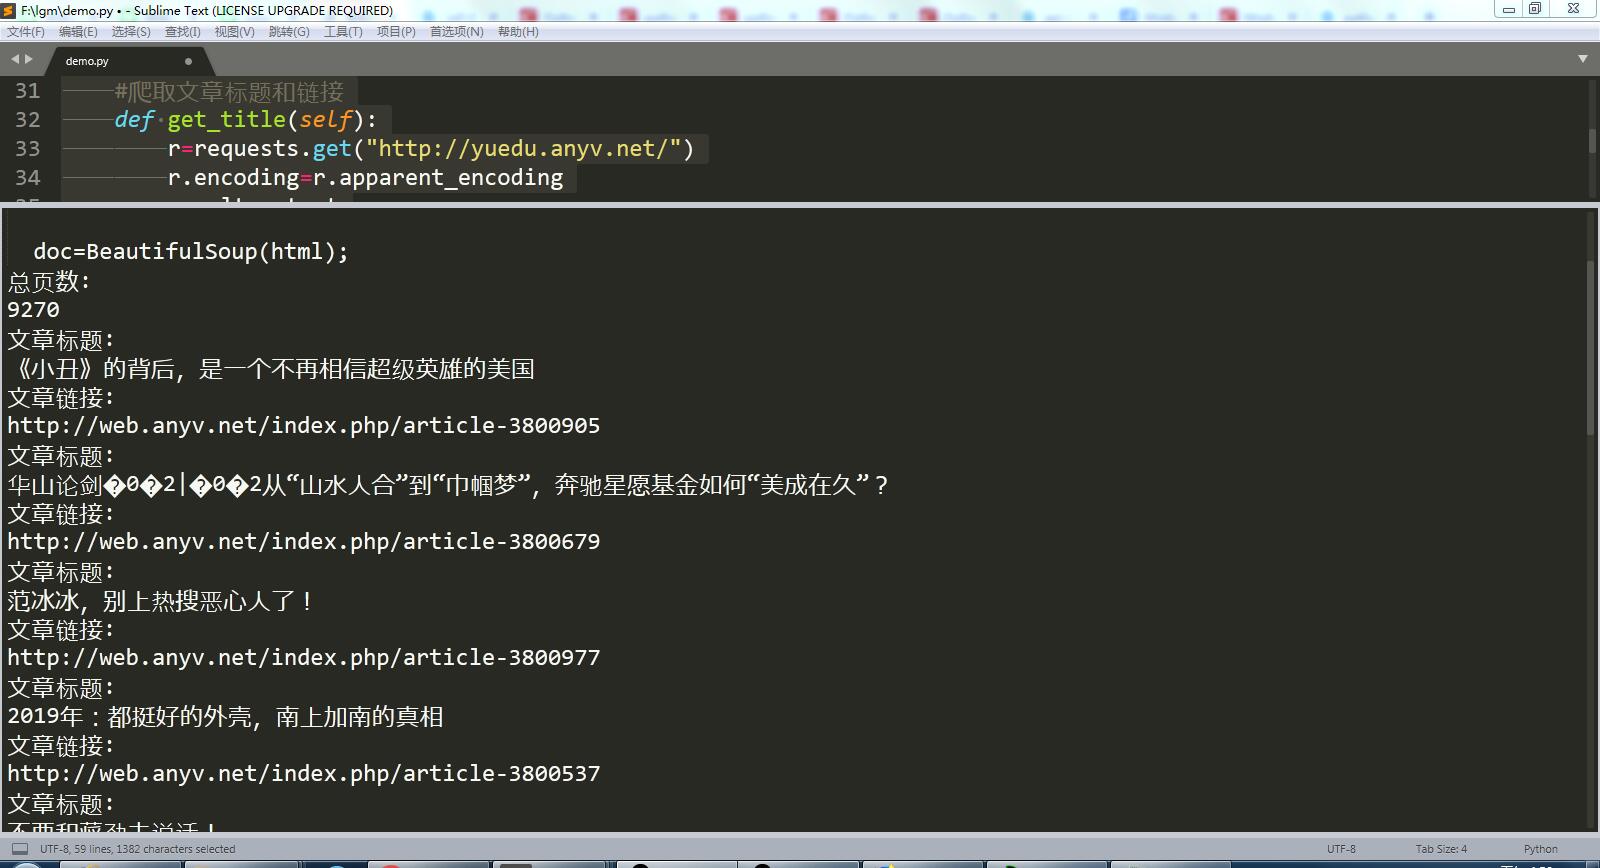
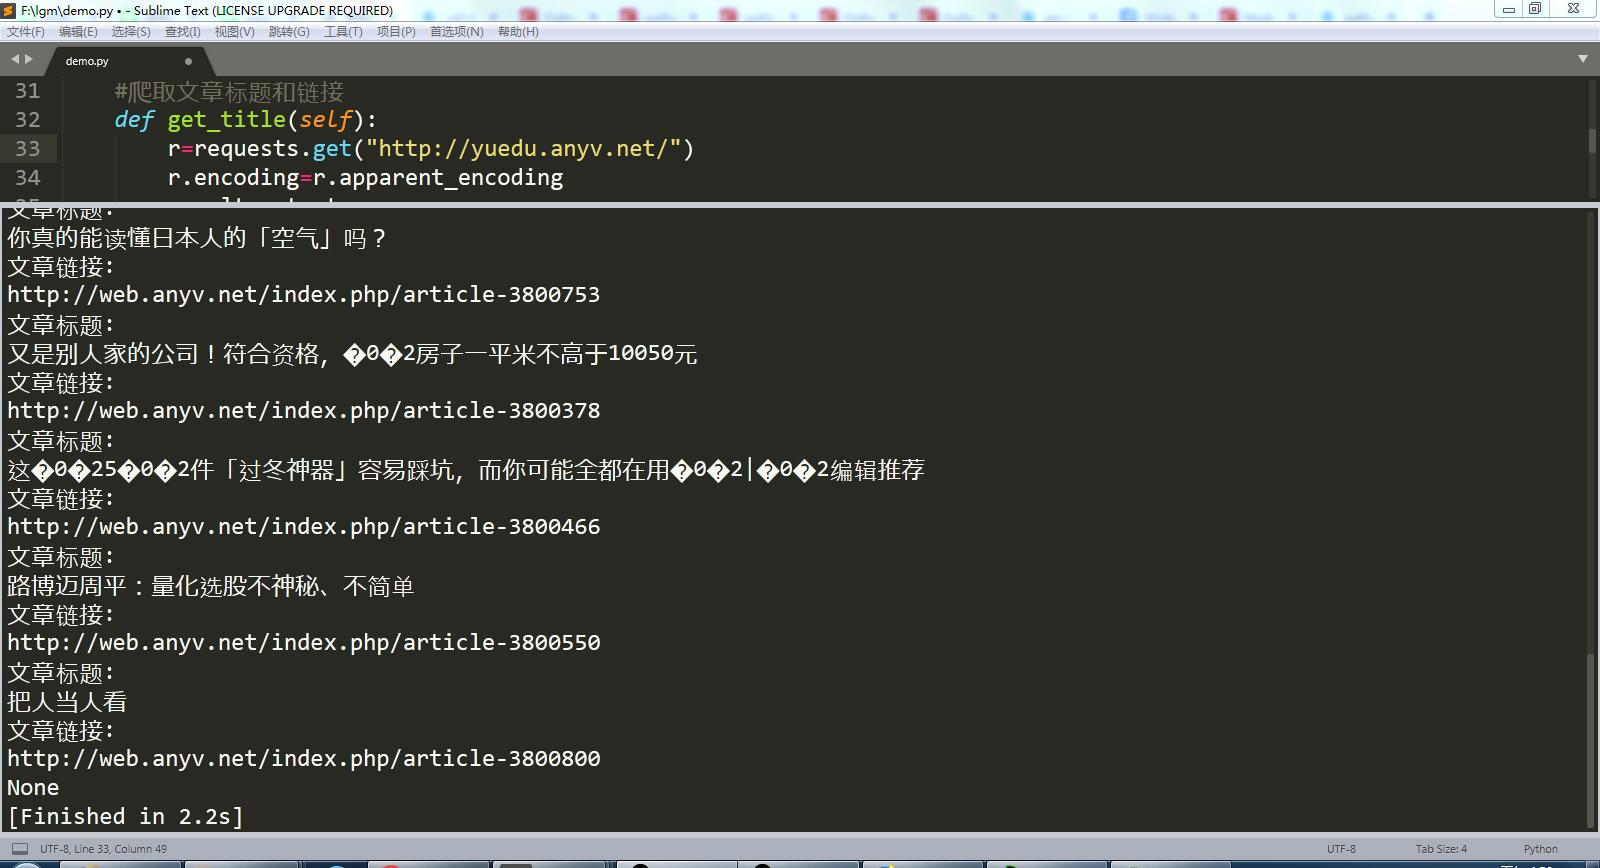
运行结果截图:
python之爬取练习的更多相关文章
- 大神:python怎么爬取js的页面
大神:python怎么爬取js的页面 可以试试抓包看看它请求了哪些东西, 很多时候可以绕过网页直接请求后面的API 实在不行就上 selenium (selenium大法好) selenium和pha ...
- python连续爬取多个网页的图片分别保存到不同的文件夹
python连续爬取多个网页的图片分别保存到不同的文件夹 作者:vpoet mail:vpoet_sir@163.com #coding:utf-8 import urllib import ur ...
- python定时器爬取豆瓣音乐Top榜歌名
python定时器爬取豆瓣音乐Top榜歌名 作者:vpoet mail:vpoet_sir@163.com 注:这些小demo都是前段时间为了学python写的,现在贴出来纯粹是为了和大家分享一下 # ...
- python大规模爬取京东
python大规模爬取京东 主要工具 scrapy BeautifulSoup requests 分析步骤 打开京东首页,输入裤子将会看到页面跳转到了这里,这就是我们要分析的起点 我们可以看到这个页面 ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- Python+Selenium爬取动态加载页面(2)
注: 上一篇<Python+Selenium爬取动态加载页面(1)>讲了基本地如何获取动态页面的数据,这里再讲一个稍微复杂一点的数据获取全国水雨情网.数据的获取过程跟人手动获取过程类似,所 ...
- Python+Selenium爬取动态加载页面(1)
注: 最近有一小任务,需要收集水质和水雨信息,找了两个网站:国家地表水水质自动监测实时数据发布系统和全国水雨情网.由于这两个网站的数据都是动态加载出来的,所以我用了Selenium来完成我的数据获取. ...
- python 3 爬取百度图片
python 3 爬取百度图片 学习了:https://blog.csdn.net/X_JS612/article/details/78149627
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
随机推荐
- Python的输入输出的应用
输入输出主要掌握print()和input()两个函数的应用. #print函数用于控制台输出 print('I love Python.','So I want to learn it.','I b ...
- JS基础语法---基本包装类型
基本包装类型 普通变量不能直接调用属性或者方法 对象可以直接调用属性和方法 基本包装类型: 本身是基本类型, 但是在执行代码的过程中, 如果这种类型的变量调用了属性或者是方法, 那么这种类型就 ...
- find 常用命令
系统中总会不断产生一些文件,比如日志文件,不一定会用到也不会自动删除,这时候就需要手动删除,当然也可以转存到其他目录下.不好找的时候可以用find模糊查找,加个job定时任务自动执行定期删除文件1.添 ...
- Lua 5.1 学习笔记
1 简介 2 语法 2.1 语法约定 2.1.1 保留关键字 2.1.2 操作符 2.1.3 字符串定义 2.2 值与类型 2.2.1 强制转换 2.3 变量 2.3.1 索引 2.3.2 环境表 2 ...
- 通过BGP实现流量劫持
BGP BGP全称是Border Gateway Protocol,翻译成中文是边界网关协议,用于全球各个AS之间的路由.它的地位是毋庸置疑的,如果没有它就没有全球的因特网.因为全球各个AS都等价的维 ...
- 一篇和Redis有关的锁和事务的文章
部分参考链接 Transaction StackExchange.Redis Transaction hashest 正文 Redis 是一种基于内存的单线程数据库.意味着所有的命令是一个接一个的执行 ...
- 【学习笔记】C/C++
1. C语言中的 scanf() 函数 该函数包含在头文件 <stdio.h> 或者 <cstdio> (在C++中使用时) 函数的返回值指的是 所输入的数据与格式字符串匹配的 ...
- opencv在VS2017上的环境搭建
最近开始做一个图像识别的小项目,需要安装opencv,VS里报的错迷的一批,网上教程好多,找了好长时间,终于找的两个解决了问题,在这儿记录一下. 安装很简单,在opencv官网(https://ope ...
- SpringBoot+JWT+Shiro+MybatisPlus实现Restful快速开发后端脚手架
一.背景 前后端分离已经成为互联网项目开发标准,它会为以后的大型分布式架构打下基础.SpringBoot使编码配置部署都变得简单,越来越多的互联网公司已经选择SpringBoot作为微服务的入门级微框 ...
- 云数据库MongoDB版清理oplog日志和compact命令详解
1.问题描述: 今天看到公司mongodb的oplog有点大,看到云数据库MongoDB版日志清理策略. MongoDB数据库在长期频繁地删除/写入数据或批量删除了大量数据,将产生很多物理空间碎片. ...