
Numpy实现机器学习交叉验证的数据划分
Numpy实现K折交叉验证的数据划分
本实例使用Numpy的数组切片语法,实现了K折交叉验证的数据划分
背景:K折交叉验证
为什么需要这个?
在机器学习中,因为如下原因,使用K折交叉验证能更好评估模型效果:
- 样本量不充足,划分了训练集和测试集后,训练数据更少;
- 训练集和测试集的不同划分,可能会导致不同的模型性能结果;
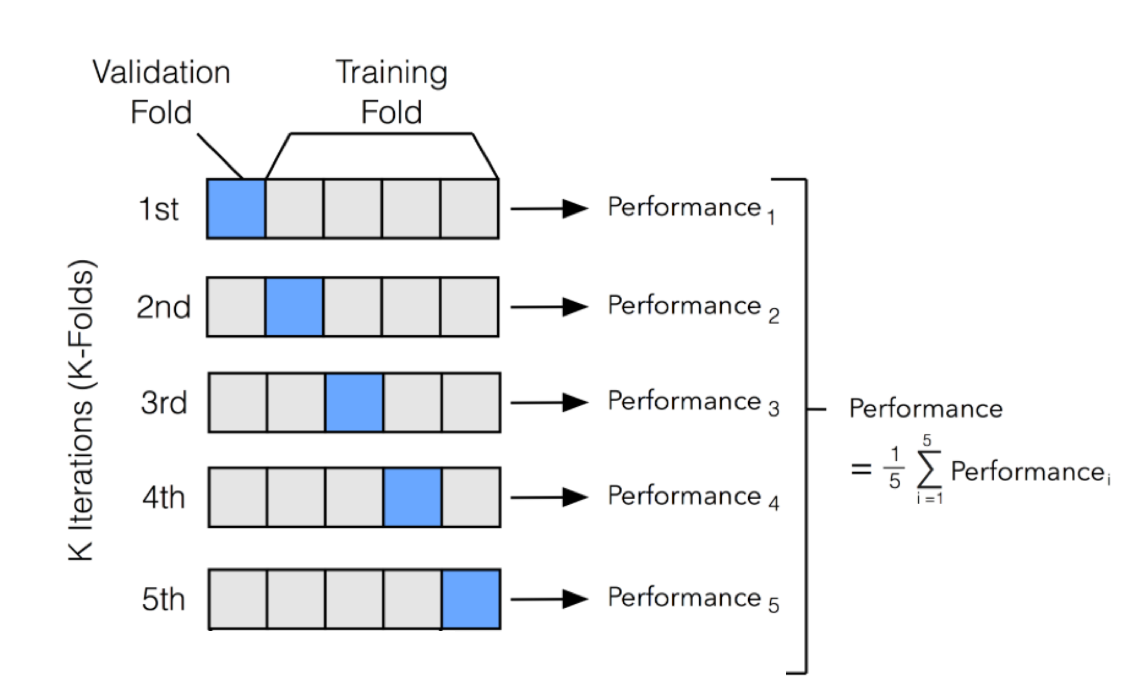
K折验证是什么
K折验证(K-fold validtion)将数据划分为大小相同的K个分区。
对每个分区i,在剩余的K-1个分区上训练模型,然后在分区i上评估模型。
最终分数等于K个分数的平均值,使用平均值来消除训练集和测试集的划分影响;
1. 模拟构造样本集合
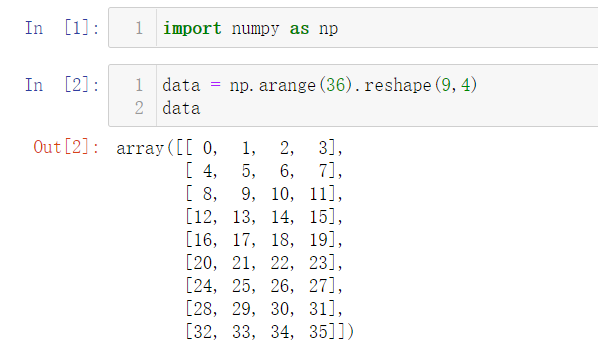
用样本的角度解释下data数组:
- 这是一个二维矩阵,行代表每个样本,列代表每个特征
- 这里有9个样本,每个样本有4个特征
这是scikit-learn模型训练输入的标准格式
2. 使用Numpy实现K次划分
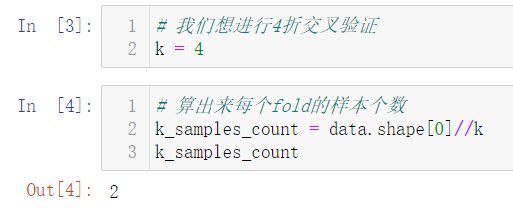
for fold in range(k):

    validation_begin = k_samples_count*fold

    validation_end = k_samples_count*(fold+1)

    validation_data = data[validation_begin:validation_end]

    # np.vstack,沿着垂直的方向堆叠数组

    train_data = np.vstack([

        data[:validation_begin],

        data[validation_end:]

    ])

    print()

    print(f"#####第{fold}折#####")

    print("验证集:\n", validation_data)

    print("训练集:\n", train_data)
结果:
#####第0折#####

验证集:

 [[0 1 2 3]

 [4 5 6 7]]

训练集:

 [[ 8  9 10 11]

 [12 13 14 15]

 [16 17 18 19]

 [20 21 22 23]

 [24 25 26 27]

 [28 29 30 31]

 [32 33 34 35]]

#####第1折#####

验证集:

 [[ 8  9 10 11]

 [12 13 14 15]]

训练集:

 [[ 0  1  2  3]

 [ 4  5  6  7]

 [16 17 18 19]

 [20 21 22 23]

 [24 25 26 27]

 [28 29 30 31]

 [32 33 34 35]]

#####第2折#####

验证集:

 [[16 17 18 19]

 [20 21 22 23]]

训练集:

 [[ 0  1  2  3]

 [ 4  5  6  7]

 [ 8  9 10 11]

 [12 13 14 15]

 [24 25 26 27]

 [28 29 30 31]

 [32 33 34 35]]

#####第3折#####

验证集:

 [[24 25 26 27]

 [28 29 30 31]]

训练集:

 [[ 0  1  2  3]

 [ 4  5  6  7]

 [ 8  9 10 11]

 [12 13 14 15]

 [16 17 18 19]

 [20 21 22 23]

 [32 33 34 35]]
如果使用scikit-learn,已经有封装好的实现:
from sklearn.model_selection import cross_val_score
Numpy实现机器学习交叉验证的数据划分的更多相关文章
- 机器学习——交叉验证,GridSearchCV,岭回归
0.交叉验证 交叉验证的基本思想是把在某种意义下将原始数据(dataset)进行分组,一部分做为训练集(train set),另一部分做为验证集(validation set or test set) ...
- 机器学习 - 案例 - 样本不均衡数据分析 - 信用卡诈骗 ( 标准化处理, 数据不均处理, 交叉验证, 评估, Recall值, 混淆矩阵, 阈值 )
案例背景 银行评判用户的信用考量规避信用卡诈骗 ▒ 数据 数据共有 31 个特征, 为了安全起见数据已经向了模糊化处理无法读出真实信息目标 其中数据中的 class 特征标识为是否正常用户 (0 代表 ...
- 机器学习中的train valid test以及交叉验证
转自 https://www.cnblogs.com/rainsoul/p/6373385.html 在以前的网络训练中,有关于验证集一直比较疑惑,在一些机器学习的教程中,都会提到,将数据集分为三部分 ...
- 机器学习基础:(Python)训练集测试集分割与交叉验证
在上一篇关于Python中的线性回归的文章之后,我想再写一篇关于训练测试分割和交叉验证的文章.在数据科学和数据分析领域中,这两个概念经常被用作防止或最小化过度拟合的工具.我会解释当使用统计模型时,通常 ...
- 斯坦福大学公开课机器学习:advice for applying machine learning | model selection and training/validation/test sets(模型选择以及训练集、交叉验证集和测试集的概念)
怎样选用正确的特征构造学习算法或者如何选择学习算法中的正则化参数lambda?这些问题我们称之为模型选择问题. 在对于这一问题的讨论中,我们不仅将数据分为:训练集和测试集,而是将数据分为三个数据组:也 ...
- Spark机器学习——模型选择与参数调优之交叉验证
spark 模型选择与超参调优 机器学习可以简单的归纳为 通过数据训练y = f(x) 的过程,因此定义完训练模型之后,就需要考虑如何选择最终我们认为最优的模型. 如何选择最优的模型,就是本篇的主要内 ...
- Spark2.0机器学习系列之2:基于Pipeline、交叉验证、ParamMap的模型选择和超参数调优
Spark中的CrossValidation Spark中采用是k折交叉验证 (k-fold cross validation).举个例子,例如10折交叉验证(10-fold cross valida ...
- 机器学习--K折交叉验证和非负矩阵分解
1.交叉验证 交叉验证(Cross validation),交叉验证用于防止模型过于复杂而引起的过拟合.有时亦称循环估计, 是一种统计学上将数据样本切割成较小子集的实用方法. 于是可以先在一个子集上做 ...
- 机器学习 数据量不足问题----1 做好特征工程 2 不要用太多的特征 3 做好交叉验证 使用线性svm
来自:https://www.zhihu.com/question/35649122 其实这里所说的数据量不足,可以换一种方式去理解:在维度高的情况下,数据相对少.举一个特例,比如只有一维,和1万个数 ...
随机推荐
- 在linux上oracle服务启动停止详细
转至:https://www.cnblogs.com/baihuitestsoftware/articles/6365431.html 在CentOS 6.3下安装完Oracle 10g R2,重开机 ...
- _IO_2_1_stdin_ 任意写及对 _IO_2_1_stdout_ 任意读的补充
之前写过一篇 IO_FILE--leak 任意读,但是在学习的时候偷懒了,没有深入去看,这次碰到 winmt 师傅出的题,就傻眼了,故再写一篇博客来记录一下. 例题 ctfshow Incomplet ...
- 【论文考古】量化SGD QSGD: Communication-Efficient SGD via Gradient Quantization and Encoding
D. Alistarh, D. Grubic, J. Li, R. Tomioka, and M. Vojnovic, "QSGD: Communication-Efficient SGD ...
- VirtualBox虚拟机--安装新系统
问题概述:在VirtualBox虚拟机中使用ISO镜像文件安装新系统. 继在本机系统上学习Python把系统搞坏掉以后,总结教训试新东西还是先在虚拟机上练手. 找同事拷了一个win10系统的ISO镜像 ...
- ElasticSearch常用查询命令-kibana中使用
目录 初学ES 只创建索引(表) 1. 创建 2.创建好后查看索引结构 添加文档(数据) 查看文档(数据) 修改文档数据(数据update) put方式修改 post方式修改 删除文档&索引 ...
- 04 变量 变量作用域 常量final 变量的命名规范
变量 变量是什么:就是可以变化的量! Java是一种强类型语言,每个变量都必须声明其类型. Java变量是程序中最基本的存储单元,其要素包括变量名,变量类型和作用域. 注意事项: 每个变量都有类型,类 ...
- 在/etc/docker/下 创建daemon.json重新加载后docker无法启动问题 /etc/docker/daemon.json编辑不了 找不到
可能产生这个问题的原因至少有以下几个: 编辑daemon.json步骤不对:想要创建并编辑daemon.json,应该是先启动docker服务,此时系统自动产生/etc/docker目录,此时cat生 ...
- Linux kernel serial_ir_init_module()释放后重利用漏洞
受影响系统:Linux kernel < 5.1.6描述:-------------------------------------------------------------------- ...
- 嵌入式无操作系统下管理内存和队列(类UCOS II思想)
例子:存储日志,最多存128条,每条最大1MB. 内存方面 因为嵌入式不适合用动态内存,会产生碎片.这里我们用 u8 data[LOG_SIZE];开辟固定128MB的内存区,再对其分为128个1MB ...
- web服务器-nginx负载均衡
web服务器-nginx负载均衡 一 负载均衡的作用 负载均衡: 分摊到多个操作单元上进行执行,和它的英文名称很匹配.就是我们需要一个调度者,保证所有后端服务器都将性能充分发挥,从而保持服务器集群的整 ...