
Apache Hudi 如何加速传统的批处理模式?
1. 现状说明
1.1 数据湖摄取和计算过程 - 处理更新
在我们的用例中1-10% 是对历史记录的更新。当记录更新时,我们需要从之前的 updated_date 分区中删除之前的条目,并将条目添加到最新的分区中,在没有删除和更新功能的情况下,我们必须重新读取整个历史表分区 -> 去重数据 -> 用新的去重数据覆盖整个表分区
1.2 当前批处理过程中的挑战
这个过程有效,但也有其自身的缺陷:
- 时间和成本——每天都需要覆盖整个历史表
- 数据版本控制——没有开箱即用的数据和清单版本控制(回滚、并发读取和写入、时间点查询、时间旅行以及相关功能不存在)
- 写入放大——日常历史数据覆盖场景中的外部(或自我管理)数据版本控制增加了写入放大,从而占用更多的 S3 存储
借助Apache Hudi,我们希望在将数据摄取到数据湖中的同时,找到更好的重复数据删除和数据版本控制优化解决方案。
2. Hudi 数据湖 — 查询模式
当我们开始在我们的数据湖上实现 Apache Hudi 的旅程时,我们根据表的主要用户的查询模式将表分为 2 类。
- 面向ETL :这是指我们从各种生产系统摄取到数据湖中的大多数原始/基本快照表。 如果这些表被 ETL 作业广泛使用,那么我们将每日数据分区保持在 updated_date,这样下游作业可以简单地读取最新的 updated_at 分区并(重新)处理数据。
- 面向分析师:通常包括维度表和业务分析师查询的大部分计算 OLAP,分析师通常需要查看基于事务(或事件)created_date 的数据,而不太关心 updated_date。
这是一个示例电子商务订单数据流,从摄取到数据湖到创建 OLAP,最后到业务分析师查询它
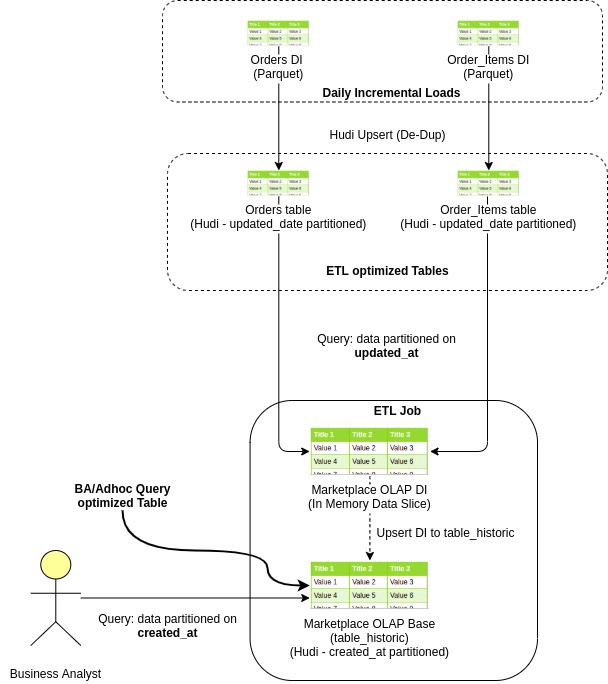
由于两种类型的表的日期分区列不同,我们采用不同的策略来解决这两个用例。
2.1 面向分析师的表/OLAP(按 created_date 分区)
在 Hudi 中,我们需要指定分区列和主键列,以便 Hudi 可以为我们处理更新和删除。
以下是我们如何处理面向分析师的表中的更新和删除的逻辑:
- 读取上游数据的 D-n 个 updated_date 分区。
- 应用数据转换。 现在这个数据将只有新的插入和很少的更新记录。
- 发出 hudi upsert 操作,将处理后的数据 upsert 到目标 Hudi 表。
由于主键和 created_date 对于退出和传入记录保持相同,Hudi 通过使用来自传入记录 created_date 和 primary_key 列的此信息获取现有记录的分区和分区文件路径。
2.2 面向ETL(按更新日期分区)
当我们开始使用 Hudi 时,在阅读了许多博客和文档之后,在 created_date 上对面向 ETL 的表进行分区似乎是合乎逻辑的。
此外 Hudi 提供增量消费功能,允许我们在 created_date 上对表进行分区,并仅获取在 D-1 或 D-n 上插入(插入或更新)的那些记录。
1. “created_date”分区的挑战
这种方法在理论上效果很好,但在改造传统的日常批处理过程中的增量消费时,它带来了其他一系列挑战:
Hudi 维护了在不同时刻在表上执行的所有操作的时间表,这些提交包含有关作为 upsert 的一部分插入或重写的部分文件的信息,我们将此 Hudi 表称为 Commit Timeline。
这里要注意的重要信息是增量查询基于提交时间线,而不依赖于数据记录中存在的实际更新/创建日期信息。
- 冷启动:当我们将现有的上游表迁移到 Hudi 时,D-1 Hudi 增量查询将获取完整的表,而不仅仅是 D-1 更新。发生这种情况是因为在开始时,整个表是通过在 D-1 提交时间线内发生的单个初始提交或多个提交创建的,并且缺少真正的增量提交信息。
- 历史数据重新摄取:在每个常规增量 D-1 拉取中,我们期望仅在 D-1 上更新的记录作为输出。但是在重新摄取历史数据的情况下,会再次出现类似于前面描述的冷启动问题的问题,并且下游作业也会出现 OOM。
作为面向 ETL 的作业的解决方法,我们尝试将数据分区保持在 updated_date 本身,然而这种方法也有其自身的挑战。
2. “updated_date”分区的挑战
我们知道 Hudi 表的本地索引,Hudi 依靠索引来获取存储在数据分区本地目录中的 Row-to-Part_file 映射。因此,如果我们的表在 updated_date 进行分区,Hudi 无法跨分区自动删除重复记录。
Hudi 的全局索引策略要求我们保留一个内部或外部索引来维护跨分区的数据去重。对于大数据量,每天大约 2 亿条记录,这种方法要么运行缓慢,要么因 OOM 而失败。
因此,为了解决更新日期分区的数据重复挑战,我们提出了一种全新的重复数据删除策略,该策略也具有很高的性能。
3. “新”重复数据删除策略
- 查找更新 - 从每日增量负载中,仅过滤掉更新(1-10% 的 DI 数据)(其中 updated_date> created_date)(快速,仅映射操作)
- 找到过时更新 - 将这些“更新”与下游 Hudi 基表广播连接。 由于我们只获取更新的记录(仅占每日增量的 1-10%),因此可以实现高性能的广播连接。 这为我们提供了与更新记录相对应的基础 Hudi 表中的所有现有记录
- 删除过时更新——在基本 Hudi 表路径上的这些“过时更新”上发出 Hudi 删除命令
- 插入 - 在基本 hudi 表路径上的完整每日增量负载上发出 hudi insert 命令
进一步优化用 true 填充陈旧更新中的 _hoodie_is_deleted 列,并将其与每日增量负载结合。 通过基本 hudi 表路径发出此数据的 upsert 命令。 它将在单个操作(和单个提交)中执行插入和删除。
4. Apache Hudi 的优势
- 时间和成本——Hudi 在重复数据删除时不会覆盖整个表。 它只是重写接收更新的部分文件。 因此较小的 upsert 工作
- 数据版本控制——Hudi 保留表版本(提交历史),因此提供实时查询(时间旅行)和表版本回滚功能。
- 写入放大——由于只有部分文件被更改并保留用于数据清单版本控制,我们不需要保留完整数据的版本。 因此整体写入放大是最小的。
作为数据版本控制的另一个好处,它解决了并发读取和写入问题,因为数据版本控制使并发读取器可以读取数据文件的版本控制副本,并且当并发写入器用新数据覆盖同一分区时不会抛出 FileNotFoundException 文件。
Apache Hudi 如何加速传统的批处理模式?的更多相关文章
- Robinhood基于Apache Hudi的下一代数据湖实践
1. 摘要 Robinhood 的使命是使所有人的金融民主化. Robinhood 内部不同级别的持续数据分析和数据驱动决策是实现这一使命的基础. 我们有各种数据源--OLTP 数据库.事件流和各种第 ...
- Apache Hudi助力nClouds加速数据交付
1. 概述 在nClouds上,当客户的业务决策取决于对近实时数据的访问时,客户通常会向我们寻求有关数据和分析平台的解决方案.但随着每天创建和收集的数据量都在增加,这使得使用传统技术进行数据分析成为一 ...
- 详解 Apache Hudi Schema Evolution(模式演进)
Schema Evolution(模式演进)允许用户轻松更改 Hudi 表的当前模式,以适应随时间变化的数据. 从 0.11.0 版本开始,支持 Spark SQL(spark3.1.x 和 spar ...
- 官宣!ASF官方正式宣布Apache Hudi成为顶级项目
马萨诸塞州韦克菲尔德(Wakefield,MA)- 2020年6月 - Apache软件基金会(ASF).350多个开源项目和全职开发人员.管理人员和孵化器宣布:Apache Hudi正式成为Apac ...
- 通过Apache Hudi和Alluxio建设高性能数据湖
T3出行的杨华和张永旭描述了他们数据湖架构的发展.该架构使用了众多开源技术,包括Apache Hudi和Alluxio.在本文中,您将看到我们如何使用Hudi和Alluxio将数据摄取时间缩短一半.此 ...
- Apache Hudi 设计与架构最强解读
感谢 Apache Hudi contributor:王祥虎 翻译&供稿. 欢迎关注微信公众号:ApacheHudi 本文将介绍Apache Hudi的基本概念.设计以及总体基础架构. 1.简 ...
- Apache Hudi 0.6.0版本重磅发布
1. 下载信息 源码:Apache Hudi 0.6.0 Source Release (asc, sha512) 二进制Jar包:nexus 2. 迁移指南 如果您从0.5.3以前的版本迁移至0.6 ...
- 基于Apache Hudi构建数据湖的典型应用场景介绍
1. 传统数据湖存在的问题与挑战 传统数据湖解决方案中,常用Hive来构建T+1级别的数据仓库,通过HDFS存储实现海量数据的存储与水平扩容,通过Hive实现元数据的管理以及数据操作的SQL化.虽然能 ...
- 超级重磅!Apache Hudi多模索引对查询优化高达30倍
与许多其他事务数据系统一样,索引一直是 Apache Hudi 不可或缺的一部分,并且与普通表格式抽象不同. 在这篇博客中,我们讨论了我们如何重新构想索引并在 Apache Hudi 0.11.0 版 ...
随机推荐
- Java基础 (下)
泛型 Java 泛型了解么?什么是类型擦除?介绍一下常用的通配符? Java 泛型(generics) 是 JDK 5 中引入的一个新特性, 泛型提供了编译时类型安全检测机制,该机制允许程序员在编译时 ...
- springboot服务引入外部jar包在windows运行正常,在linux环境上无法加载到引入jar包的类
一.问题描述 最近开发了一个springboot程序,需要依赖第三方jar包,这个jar包无法直接通过pom远程仓库下载,需要从自己本地引入,于是配置pom文件如下:将本地jar包引入工程,syste ...
- vue使用svg,animate事件绑定无效问题及解决方法
由于使用svg制作圆形进度条,但是进度展示的太生硬,没有过渡圆滑的效果,所以使用 animate(在svg元素里可以查到) 元素标签,但 这样使用了,还是没有效果,我前端使用的 vue ,所以通过 @ ...
- 为什么在重写 equals 方法的时候需要重写 hashCode 方法?
因为有强制的规范指定需要同时重写 hashcode 与 equal 是方法,许多容器类, 如 HashMap.HashSet 都依赖于 hashcode 与 equals 的规定.
- 本地存储和cookies之间的区别是什么?
cookies本地存储客户端/服务器端既可以从客户端也可以从服务器端访问数据.每个请求都会发送cookie数据到服务器.只能在本地浏览器端访问数据.服务器无法访问本地存储,除非特意通过POST或GET ...
- Citus 分布式 PostgreSQL 集群 - SQL Reference(查询处理)
一个 Citus 集群由一个 coordinator 实例和多个 worker 实例组成. 数据在 worker 上进行分片和复制,而 coordinator 存储有关这些分片的元数据.向集群发出的所 ...
- CPU架构:CPU架构详细介绍
1 概述 CPU架构是CPU商给CPU产品定的一个规范,主要目的是为了区分不同类型的CPU.目前市场上的CPU分类主要分有两大阵营,一个是intel.AMD为首的复杂指令集CPU,另一个是以IBM.A ...
- LQR (线性二次型调节器)的直观推导及简单应用
转自:https://blog.csdn.net/heyijia0327/article/details/39270597 本文主要介绍LQR的直观推导,说明LQR目标函数J选择的直观含义以及简单介绍 ...
- webpack+vue-cli+ElementUI+vue-resource 前端开发
线上商城项目(电脑0环境)1.安装node.js (参考http://www.runoob.com/nodejs/nodejs-install-setup.html): 2.安装 webpack (全 ...
- 一块小饼干(Cookie)的故事-上篇
cookie 如果非要用汉语理解的话应该是 一段小型文本文件,由网景的创始人之一的卢 蒙特利在93年发明. 上篇是熟悉一下注册的大致流程,下篇熟悉登录流程以及真正的Cookie 实现基本的注册功能 我 ...