
Hive的初识
Hive是构建于Hadoop上的数据仓库基础框架,它提供了以下功能:
- 可通过SQL轻松的访问数据,从而实现数据仓库的任务。如提取/转换/加载,报告和数据分析。
- 对各种数据格式施加结构。
- 访问存储在HDFS或是其他数据存储系统上文件。
- 可使用MapReduce或是Spark作为执行层。
- 通过Hive LLAP,YARN和Slider进行亚秒级查询检索。
Hive架构与基本组成
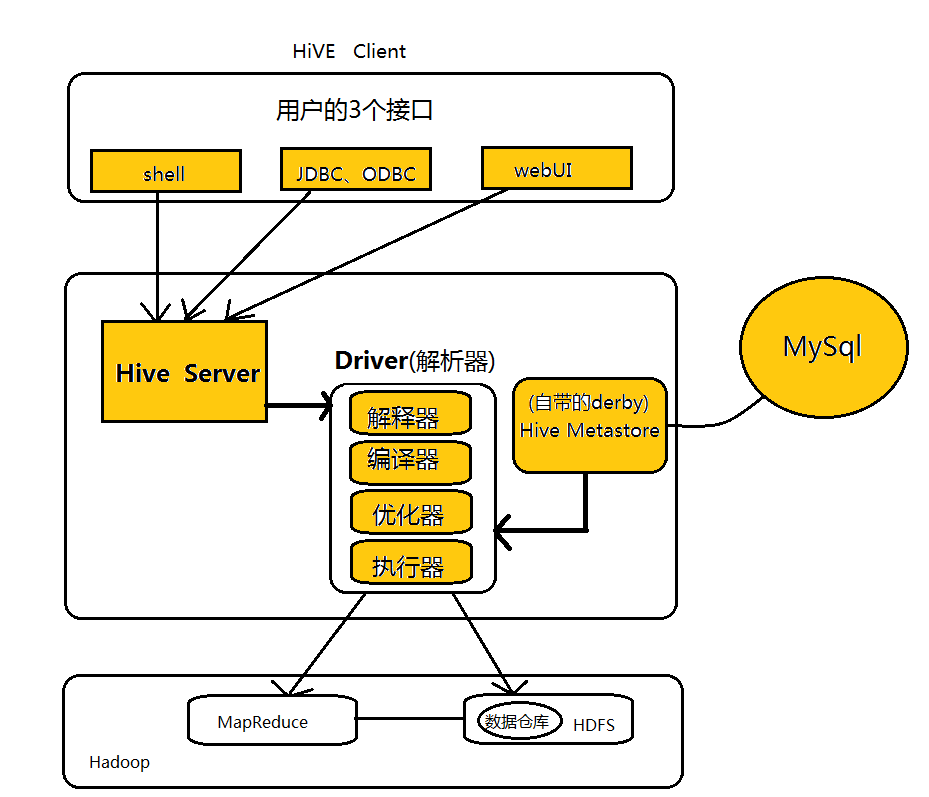
Hive的体系结构可以分为以下几部分:
- Hive对外提供的接口主要包括CLI,WebUI和基于JDBC/ODBC协议的数据库接口。其中最常用的是CLI。
- Hive将元数据存储在数据库中,如MySQL,Derby。Hive中的元数据包括表的名字、表的列和分区及其属性、表的数据所在目录等。
- 解析器、编辑器、优化器和执行器完成HQL查询语句从词法分析、语法分析、编译、优化以及查询计划的生成。生成的查询技术存储在HDFS中,并在随后由MapReduce调用执行。
- Hive的数据存储在HDFS中,大部分的查询计算都有MapReduce完成。
Hive的metastore的三种模式:
- 内嵌模式:元数据保持在内嵌的Derby模式,只允许一个会话连接。hive默认的启动模式,一般用于单元测试,这种模式有个缺点:hive server重启后所有的元数据都会丢失,而且在同一时间只能有一个进程连接使用数据库(单会话)
- 本地独立模式:在本地安装MySQL,并把元数据放到MySQL中
- 远程模式:将元数据放置在远程的MySQL数据库中。需在服务器端启动MetastoreServer,客户端利用Thrift协议通过MetaStoreServer访问元数据库。
Hive中数据模型:
- 内外表比较
- Hive中的表跟数据库中的表概念类似,每个表在Hive中都有一个对应的存储目录。内部表默认存在HDFS的/user/hive/warehouse下(该路径由hive-site.xml文件中的${hive.metastore.warehouse.dir}指定,所有的表数据(外表除外)都保存在该目录中)。
- 内外表的相同之处:都需要指定元数据,都支持分区。
- 内外表不同之处:实际的数据存储地点不同。
- 内部表实际的数据存储在数据仓库目录中(默认是集群/user/hive/warehouse下),删除表时,表中的数据和元数据都将会被同时删除。
- 外部表的实际数据存储在创建语句location指定的HDFS路径中,不会移动到数据库目录中,如果删除一个外部表,仅会删除元数据而表中的数据不会被删除。一般在先有数据后要分析的时候选用外部表,因为可以创建一个外部表指向数据。
- 分区(Partition):每个表可以有一个或是多个分区键,用于确定数据的存储方式。Hive表中一个分区对应表下的一个目录,所有分区数据都存储在对应的子目录中。
- 桶:对指定列进行哈希计算时,根据哈希值切分数据,每一个桶对应一个文件。
Hive的初识的更多相关文章
- Hive[1] 初识 及 安装
本文前提是Hadoop & Java & mysql 数据库,已经安装配置好,并且 环境变量均已经配置到位 声明:本笔记参照 学习<Hive 编程指南>而来,如果有错误 ...
- [转帖]Hive学习之路 (一)Hive初识
Hive学习之路 (一)Hive初识 https://www.cnblogs.com/qingyunzong/p/8707885.html 讨论QQ:1586558083 目录 Hive 简介 什么是 ...
- 初识Hadoop、Hive
2016.10.13 20:28 很久没有写随笔了,自打小宝出生后就没有写过新的文章.数次来到博客园,想开始新的学习历程,总是被各种琐事中断.一方面确实是最近的项目工作比较忙,各个集群频繁地上线加多版 ...
- 初识hive
由facebook 开源用以帮用户解决海量数据etl,构建于hadoop的 数据仓库. 使用hql作为查询接口 使用hdfs作为底层存储 使用mr作为执行层 1.为什么使用hive? 1 ...
- [Hadoop大数据]——Hive初识
Hive出现的背景 Hadoop提供了大数据的通用解决方案,比如存储提供了Hdfs,计算提供了MapReduce思想.但是想要写出MapReduce算法还是比较繁琐的,对于开发者来说,需要了解底层的h ...
- Hive学习之路 (一)Hive初识
Hive 简介 什么是Hive 1.Hive 由 Facebook 实现并开源 2.是基于 Hadoop 的一个数据仓库工具 3.可以将结构化的数据映射为一张数据库表 4.并提供 HQL(Hive S ...
- Hive(一)Hive初识
一 Hive 简介 什么是Hive 1.Hive 由 Facebook 实现并开源 2.是基于 Hadoop 的一个数据仓库工具 3.可以将结构化的数据映射为一张数据库表 4.并提供 HQL(Hive ...
- Apache Hive (一)Hive初识
转自:https://www.cnblogs.com/qingyunzong/p/8707885.html Hive 简介 什么是Hive 1.Hive 由 Facebook 实现并开源 2.是基于 ...
- Hive初识(四)
Hive本质上是一个数据仓库,但不存储数据(只存储元数据(metadata),Hive中的元数据包括表的名字,表的列和分区及分区及其属性,表的属性(是否为外部表等),表的数据所在目录等),用户可以借助 ...
随机推荐
- angular6 safe url pipe
safe-url.pipe.ts import { Pipe, PipeTransform } from '@angular/core'; import { DomSanitizer } from ' ...
- jsp的page、request、session、application四个作用域的作用
1.page作用域也是最小的作用域,它只能在当前页面中使用. 2.request作用域主要是发送请求,但只能在两个页面之间发送一次请求. 3.session作用域是一个会话,也就是一个浏览器,意思是说 ...
- React 的组件与 this.props对象
1.组件 React 允许将代码封装成组件,然后像插入普通 HTML 标签一样,在网页中插入这个组件.React.createClass 的方法就是用于生成一个组件类. 2.this.props对象 ...
- YML文件中ipv6地址输入格式
关于YML文件格式可以百度,这里只说ipv6:yml文件是注重格式的不能用tab键代替空格 ipv4 :10.1.202.9 ipv6: 2001:202::6e4:f32b:c19c:4760 端口 ...
- 面向对象之反射 与__str__等内置函数
一 反射 1.面向对象中的反射:通过字符串的形式操作对象的相关属性,python中一切事物都是属性(都可以使用反射) 四个可以实现自省<反射>的函数:hasattr / getattr ...
- stackExchange.redis 实现模糊匹配批量查询
如果使用redis的频次较高,那么业务中经常会出现需要根据关键字进行批量查询,所以总结一下StackExchange中使用批量查询的方法(如果数据量很大,那么在redis中模糊查询很耗时,请慎用!) ...
- Linq 27个常用操作符说明
1.Where 操作符用于限定输入集合中的元素,将符合条件的元素组织声称一个序列结果.2.Select 操作符用于根据输入序列中的元素创建相应的输出序列中的元素,输出序列中的元素类型可以与输入序列中 ...
- Java面向对象编程思想
面向对象三个特征:封装.继承.多态封装: 语法:属性私有化(private).提供相对应的get/set 的方法进行访问(public). 在set/get的方法中对属性的数据 做相对应的业务逻 ...
- http协议与https协议的前世今生
一.Http与Https的区别: HTTP 的URL 以http:// 开头,而HTTPS 的URL 以https:// 开头 HTTP 是不安全的,而 HTTPS 是安全的 HTTP 标准端口是80 ...
- 小白的首个maven web项目Step1软件安装二(Tomcat及相关配置)
安装tomcat9.0,依照此教程非常详细:https://blog.csdn.net/cyz1151148946/article/details/76691976/ 教程最后测试tomcat的时候有 ...