
高可用hadoop的hdfs启动的时候namenode启动不了
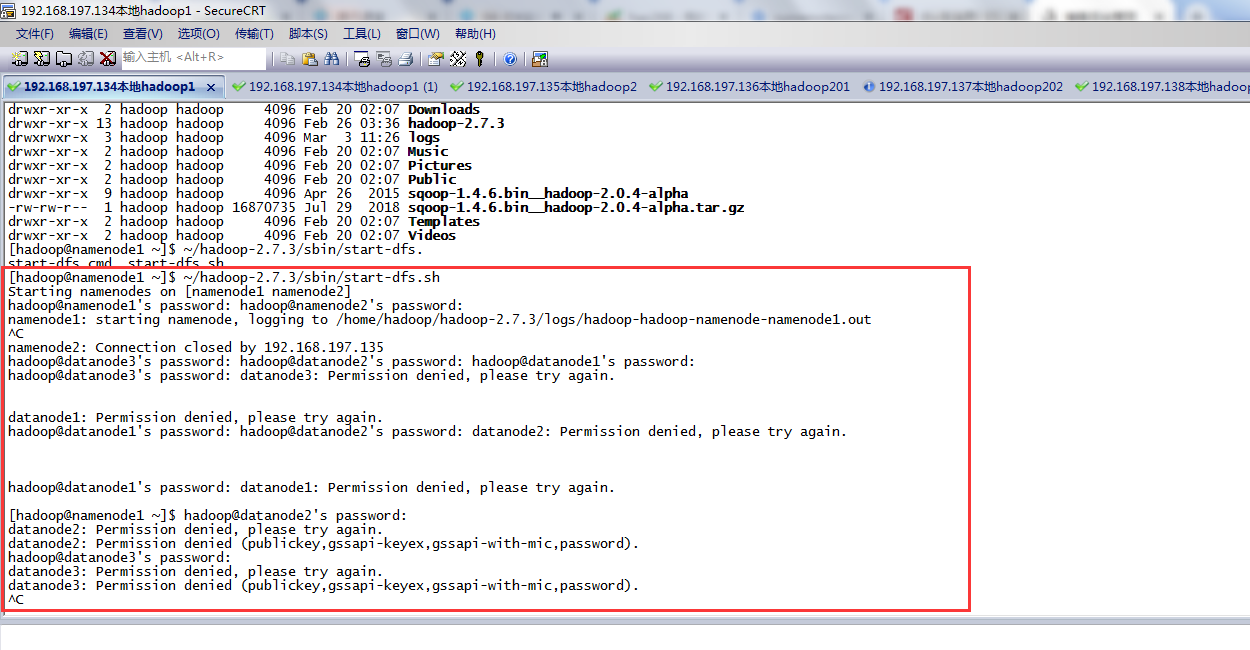
启动的时候,一直要求输入namenode密码:
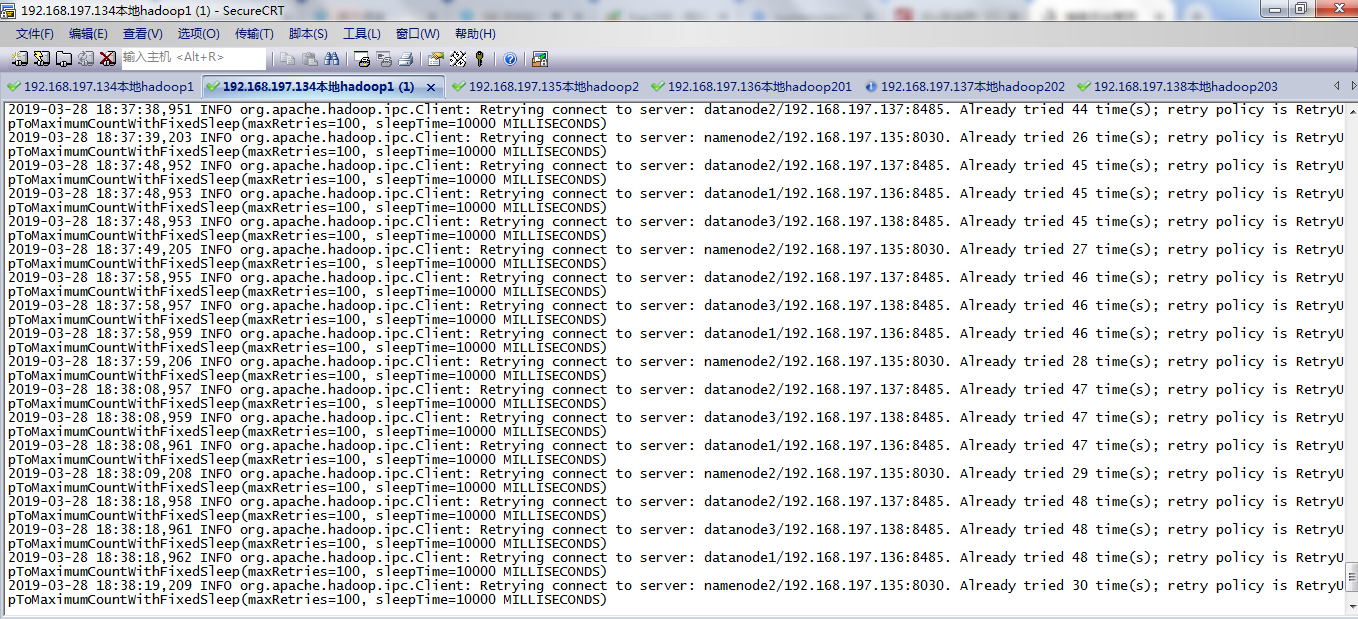
查看namenode的日志如下:
2019-03-28 18:38:08,961 INFO org.apache.hadoop.ipc.Client: Retrying connect to server: datanode1/192.168.197.136:8485. Already tried 47 time(s); retry policy is RetryUpToMaximumCountWithFixedSleep(maxRetries=100, sleepTime=10000 MILLISECONDS)
2019-03-28 18:38:09,208 INFO org.apache.hadoop.ipc.Client: Retrying connect to server: namenode2/192.168.197.135:8030. Already tried 29 time(s); retry policy is RetryUpToMaximumCountWithFixedSleep(maxRetries=100, sleepTime=10000 MILLISECONDS)
2019-03-28 18:38:18,958 INFO org.apache.hadoop.ipc.Client: Retrying connect to server: datanode2/192.168.197.137:8485. Already tried 48 time(s); retry policy is RetryUpToMaximumCountWithFixedSleep(maxRetries=100, sleepTime=10000 MILLISECONDS)
2019-03-28 18:38:18,961 INFO org.apache.hadoop.ipc.Client: Retrying connect to server: datanode3/192.168.197.138:8485. Already tried 48 time(s); retry policy is RetryUpToMaximumCountWithFixedSleep(maxRetries=100, sleepTime=10000 MILLISECONDS)
怀疑是其他服务器,namenode2/192.168.197.135,datanode1/192.168.197.136,datanode2/192.168.197.137,datanode3/192.168.197.138
上面没有authorized_keys文件中namenode1/192.1682.197.134的公钥不对。
在namenode1/192.1682.197.134中重新执行ssh-keygen -t rsa,生成公钥和私钥,发现私钥真的和其他服务器上存储的namenode1/192.1682.197.134的公钥不匹配。
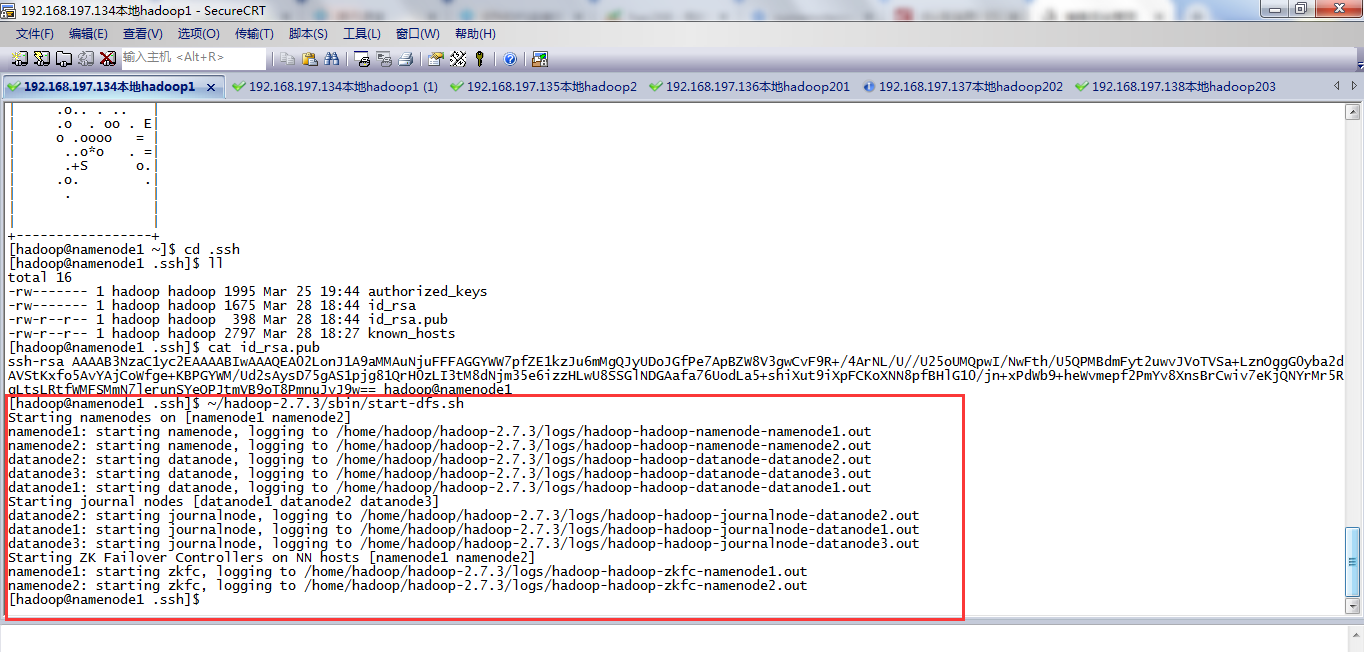
更改其他服务器上authorized_keys中namenode1/192.1682.197.134的公钥后,重启hdfs正常启动。
高可用hadoop的hdfs启动的时候namenode启动不了的更多相关文章
- 高可用Hadoop平台-Flume NG实战图解篇
1.概述 今天补充一篇关于Flume的博客,前面在讲解高可用的Hadoop平台的时候遗漏了这篇,本篇博客为大家讲述以下内容: Flume NG简述 单点Flume NG搭建.运行 高可用Flume N ...
- 基于zookeeper的高可用Hadoop HA集群安装
(1)hadoop2.7.1源码编译 http://aperise.iteye.com/blog/2246856 (2)hadoop2.7.1安装准备 http://aperise.iteye.com ...
- 高可用Hadoop平台-Oozie工作流之Hadoop调度
1.概述 在<高可用Hadoop平台-Oozie工作流>一篇中,给大家分享了如何去单一的集成Oozie这样一个插件.今天为大家介绍如何去使用Oozie创建相关工作流运行与Hadoop上,已 ...
- 高可用Hadoop平台-Hue In Hadoop
1.概述 前面一篇博客<高可用Hadoop平台-Ganglia安装部署>,为大家介绍了Ganglia在Hadoop中的集成,今天为大家介绍另一款工具——Hue,该工具功能比较丰富,下面是今 ...
- 高可用Hadoop平台-集成Hive HAProxy
1.概述 这篇博客是接着<高可用Hadoop平台>系列讲,本篇博客是为后面用 Hive 来做数据统计做准备的,介绍如何在 Hadoop HA 平台下集成高可用的 Hive 工具,下面我打算 ...
- 高可用Hadoop平台-启航
1.概述 在上篇博客中,我们搭建了<配置高可用Hadoop平台>,接下来我们就可以驾着Hadoop这艘巨轮在大数据的海洋中遨游了.工欲善其事,必先利其器.是的,没错:我们开发需要有开发工具 ...
- 高可用Hadoop平台-实战尾声篇
1.概述 今天这篇博客就是<高可用Hadoop平台>的尾声篇了,从搭建安装到入门运行 Hadoop 版的 HelloWorld(WordCount 可以称的上是 Hadoop 版的 Hel ...
- 高可用Hadoop平台-实战
1.概述 今天继续<高可用的Hadoop平台>系列,今天开始进行小规模的实战下,前面的准备工作完成后,基本用于统计数据的平台都拥有了,关于导出统计结果的文章留到后面赘述.今天要和大家分享的 ...
- 高可用Hadoop平台-探索
1.概述 上篇<高可用Hadoop平台-启航>博客已经让我们初步了解了Hadoop平台:接下来,我们对Hadoop做进一步的探索,一步一步的揭开Hadoop的神秘面纱.下面,我们开始赘述今 ...
随机推荐
- Python知识点整理,基础4 - 集合操作
- day 06Hadoop
更换虚拟机以后操作的步奏1.到每一台机器上修改ip地址 ,然后修改hosts1.5 给每台机器配置免密码登录 2.修改hadoop 的配置文件,发送到每台机器上3.启动dfs start-dfs.sh ...
- WCF 学习总结5 -- 消息拦截实现用户名验证(转)
WCF建立在基于消息的通信这一概念基础上.通过方法调用(Method Call)形式体现的服务访问需要转化成具体的消息,并通过相应的编码(Encoding)才能通过传输通道发送到服务端:服务操作执行的 ...
- replicatedhq-ship 基于Kustomize 项目的快速kubernetes 应用部署工具
replicatedhq-ship 是对Kustomize 项目的扩展,我们可以用它来快速的进行三方应用的管理部署, 可以和helm,kubernetes 清单文件,knative 集成,我们可以方便 ...
- drone 1.0 新的构建徽章特性
drone 1.0 昨天新发布的功能,支持了一个方便的查看构建状态的功能徽章 如下: 环境准备 docker-compose 文件 version: '3' services: drone-serve ...
- PADS Logic Ref Des Start Value
PADS Logic Ref Des Start Value 曾经以为 Mentor 把 PADS Logic 放弃了,没想到还加了一个非常实用的功能. 这个的好处是让元件号可以设置起始编号,方便每一 ...
- async await 的 实质 本质
async await 的 实质 就是 用 “状态机” 来 取代 函数层层调用 . async await 的 本质 是 语法糖, 和 提高性能 什么的 没什么关系 . 为了避免理解歧义, 我把 ...
- MatConvNet中关于vl_simplenn_display的一些分析
一.关于各层data size的分析 layer1: floor((224-7)/2)+1=109 这里7是filter大小,2是stride layer4: floor((109+0+1-3)/2 ...
- Android 单元测试覆盖率计算
在工程下面的build.gradle 增加配置 1.增加Plugin apply plugin: 'jacoco' 2. 增加jacoco版本 jacoco{ version "0.7.4. ...
- golang 原子操作函数
golang中的原子操作在sync/atomic package中. 下文以比较和交换操作函数为例,介绍其使用. CompareAndSwapInt32 比较和交换操作是原子性的. // Compar ...