
Caffe源码阅读(1) 全连接层
Caffe源码阅读(1) 全连接层
今天看全连接层的实现。
主要看的是https://github.com/BVLC/caffe/blob/master/src/caffe/layers/inner_product_layer.cpp
主要是三个方法,setup,forward,backward
- setup 初始化网络参数,包括了w和b
- forward 前向传播的实现
- backward 后向传播的实现
setup
主体的思路,作者的注释给的很清晰。
主要是要弄清楚一些变量对应的含义
1 |
M_ 表示的样本数 |
为了打字方便,以下省略下划线,缩写为M,K,N
forward
实现的功能就是 y=wx+b
1 |
x为输入,维度 MxK |
具体到代码实现,用的是这个函数caffe_cpu_gemm,具体的函数头为
1 |
void caffe_cpu_gemm<float>(const CBLAS_TRANSPOSE TransA, |
略长,整理它的功能其实很直观,即C←αA×B+βC
1 |
const CBLAS_TRANSPOSE TransA # A是否转置 |
从实际代码来算,全连接层的forward包括了两步:
1 |
# 这一步表示 y←wx,或者说是y←xw' |
backward
分成三步:
- 更新w
- 更新b
- 计算delta
用公式来说是下面三条: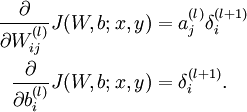
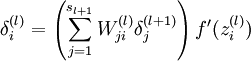
一步步来,先来第一步,更新w,对应代码是:
1 |
caffe_cpu_gemm<Dtype>(CblasTrans, CblasNoTrans, N_, K_, M_, (Dtype)1., |
对照公式,有
1 |
需要更新的w的梯度的维度是NxK |
然后是第二步,更新b,对应代码是:
1 |
caffe_cpu_gemv<Dtype>(CblasTrans, M_, N_, (Dtype)1., top_diff, |
这里用到了caffe_cpu_gemv,简单来说跟上面的caffe_cpu_gemm类似,不过前者是计算矩阵和向量之间的乘法的(从英文命名可以分辨,v for vector, m for matrix)。函数头:
1 |
void caffe_cpu_gemv<float>(const CBLAS_TRANSPOSE TransA, const int M, |
绕回到具体的代码实现。。如何更新b?根据公式b的梯度直接就是delta
1 |
# 所以对应的代码其实就是将top_diff转置后就可以了(忽略乘上bias_multiplier这步) |
第三步是计算delta,对应公式
这里面可以忽略掉最后一项f’,因为在caffe实现中,这是由Relu layer来实现的,这里只需要实现括号里面的累加就好了,这个累加其实可以等价于矩阵乘法
1 |
caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, M_, K_, N_, (Dtype)1., |
附录
又及,这里具体计算矩阵相乘用的是blas的功能,描述页面我参考的是:https://developer.apple.com/library/mac/documentation/Accelerate/Reference/BLAS_Ref/Reference/reference.html#//apple_ref/c/func/cblas_sgemm
Caffe源码阅读(1) 全连接层的更多相关文章
- caffe源码阅读
参考网址:https://www.cnblogs.com/louyihang-loves-baiyan/p/5149628.html 1.caffe代码层次熟悉blob,layer,net,solve ...
- caffe源码阅读(1)_整体框架和简介(摘录)
原文链接:https://www.zhihu.com/question/27982282 1.Caffe代码层次.回答里面有人说熟悉Blob,Layer,Net,Solver这样的几大类,我比较赞同. ...
- caffe源码阅读(1)-数据流Blob
Blob是Caffe中层之间数据流通的单位,各个layer之间的数据通过Blob传递.在看Blob源码之前,先看一下CPU和GPU内存之间的数据同步类SyncedMemory:使用GPU运算时,数据要 ...
- caffe源码阅读(3)-Datalayer
DataLayer是把数据从文件导入到网络的层,从网络定义prototxt文件可以看一下数据层定义 layer { name: "data" type: "Data&qu ...
- caffe源码阅读(2)-Layer
神经网络是由层组成的,深度神经网络就是层数多了.layer对应神经网络的层.数据以Blob的形式,在不同的layer之间流动.caffe定义的神经网络已protobuf形式定义.例如: layer { ...
- caffe源码阅读(一)convert_imageset.cpp注释
PS:本系列为本人初步学习caffe所记,由于理解尚浅,其中多有不足之处和错误之处,有待改正. 一.实现方法 首先,将文件名与它对应的标签用 std::pair 存储起来,其中first存储文件名,s ...
- caffe 源码阅读
bvlc:Berkeley Vision and Learning Center. 1. 目录结构 models(四个文件夹均有四个文件构成,deploy.prototxt, readme.md, s ...
- caffe源码 全连接层
图示全连接层 如上图所示,该全链接层输入n * 4,输出为n * 2,n为batch 该层有两个参数W和B,W为系数,B为偏置项 该层的函数为F(x) = W*x + B,则W为4 * 2的矩阵,B ...
- 源码阅读经验谈-slim,darknet,labelimg,caffe(1)
本文首先谈自己的源码阅读体验,然后给几个案例解读,选的例子都是比较简单.重在说明我琢磨的点线面源码阅读方法.我不是专业架构师,是从一个深度学习算法工程师的角度来谈的,不专业的地方请大家轻拍. 经常看别 ...
随机推荐
- BZOJ1419Red is good——概率DP
题目描述 桌面上有R张红牌和B张黑牌,随机打乱顺序后放在桌面上,开始一张一张地翻牌,翻到红牌得到1美元,黑牌则付 出1美元.可以随时停止翻牌,在最优策略下平均能得到多少钱. 输入 一行输入两个数R,B ...
- 利用Python攻破12306的最后一道防线
各位同学大家好,我是强子,好久没跟大家带来最新的技术文章了,最近有好几个同学问我12306自动抢票能否实现,我就趁这两天有时间用Python做了个12306自动抢票的项目,在这里我来带着大家一起来看看 ...
- 自学Linux Shell6.1-环境变量概念
点击返回 自学Linux命令行与Shell脚本之路 6.1-环境变量概念 环境变量 在Linux中,很多程序和脚本都通过环境变量来获取系统信息.存储临时数据和配置信息: bash shell使用环境变 ...
- cf609E Minimum Spanning Tree For Each Edge (kruskal+倍增Lca)
先kruskal求出一个最小生成树,然后对于每条非树边(a,b),从树上找a到b路径上最大的边,来把它替换掉,就是包含这条边的最小生成树 #include<bits/stdc++.h> # ...
- bzoj2599/luogu4149 [IOI2011]Race (点分治)
点分治.WA了一万年. 重点就是统计答案的方法 做法一(洛谷AC bzojWA 自测WA): 做点x时记到x距离为k的边数最小值为dis[k],然后对每一对有值的dis[i]和dis[K-i],给an ...
- Learn Python The Hard Way, 2nd Edition
看完了这本书,你决定继续做编程.也许它能成为你的一个职业,也许它能成为你的一项爱好.但你需要一些指导,确保自己不会走错了道路,或帮助你从这个新业余爱好中得到最大的乐趣. 我做了很久的编程.久的你都想象 ...
- HDU 3416 Marriage Match IV (最短路径,网络流,最大流)
HDU 3416 Marriage Match IV (最短路径,网络流,最大流) Description Do not sincere non-interference. Like that sho ...
- 【CF1042D】Petya and Array
题目大意:给定一个 N 个数组成的序列,给定一个 T,求有多少个区间满足\(\sum_{i=l}^ra[i]<T\). 题解:区间和问题可以用前缀和优化,即:求有多少个区间满足\(sum[r]- ...
- 提高磁盘访问性能 - NtfsDisableLastAccessUpdate
这个技巧可以提高磁盘访问性能,不过仅适用于NTFS文件系统. 我们知道,当在磁盘管理应用程序中列出目录结构时──效果类似“资源管理器”.“文件管理 器”(Windows NT 3.xx/4.0下的称 ...
- poj3660(Cow Contest)解题报告
Solution: 传递闭包 //if a beats b and b beats c , then a beats c //to cow i, if all the result of conten ...