
关于sql中in 和 exists 的效率问题
在用in的地方可以使用freemark标签代替,例如:
将
<#if assistantList??&& (assistantList?size > 0)>
AND (c.uid = ${uid} OR c.course_id IN (<#list assistantList as item> ${item} <#if item_has_next>,</#if></#list>))
<#else>
AND c.uid = ${uid}
</#if>
改为
<#if assistantList??&& (assistantList?size > 0)>
AND (c.uid = ${uid} OR (<#list assistantList as item>c.course_id = ${item}<#if item_has_next> OR </#if></#list>))
<#else>
AND c.uid = ${uid}
</#if>
对于in 和 exists的区别: 如果子查询得出的结果集记录较少,主查询中的表较大且又有索引时应该用in, 反之如果外层的主查询记录较少,子查询中的表大,又有索引时使用exists。其实我们区分in和exists主要是造成了驱动顺序的改变(这是性能变化的关键),如果是exists,那么以外层表为驱动表,先被访问,如果是IN,那么先执行子查询,所以我们会以驱动表的快速返回为目标,那么就会考虑到索引及结果集的关系了 ,另外IN时不对NULL进行处理。
在网上看到很多关于sql中使用in效率低的问题,于是自己做了测试来验证是否是众人说的那样。
群众:
对于in 和 exists的区别: 如果子查询得出的结果集记录较少,主查询中的表较大且又有索引时应该用in, 反之如果外层的主查询记录较少,子查询中的表大,又有索引时使用exists。其实我们区分in和exists主要是造成了驱动顺序的改变(这是性能变化的关键),如果是exists,那么以外层表为驱动表,先被访问,如果是IN,那么先执行子查询,所以我们会以驱动表的快速返回为目标,那么就会考虑到索引及结果集的关系了 ,另外IN时不对NULL进行处理。

这里我找到两张表,一个是用户信息表[INDIVIDUAL] 47万条数据,一个状态类型表[STATUS] 88条数据,对应上面所述的一多一少
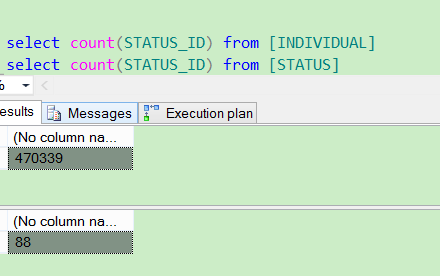
然后进行两种查询 (not exists 和 not in一组)(exists 和 in一组)
select * from STATUS s where not exists(select 1 from INDIVIDUAL i where i.STATUS_ID=s.STATUS_ID)

select * from STATUS s where s.STATUS_ID not in(select i.STATUS_ID from INDIVIDUAL i )
select * from STATUS s where  exists(select 1 from INDIVIDUAL i where i.STATUS_ID=s.STATUS_ID)

select * from STATUS s where s.STATUS_ID  in(select i.STATUS_ID from INDIVIDUAL i )
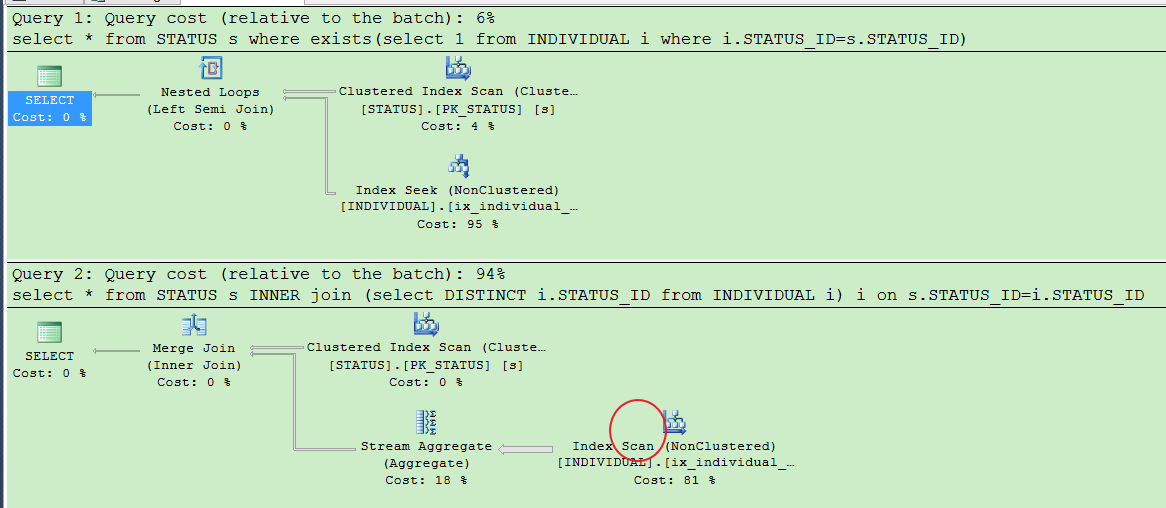
查看执行计划后发现,结果貌似是一样的,令人意外,可能大家认为in 比较慢的原因就是 IN先执行子查询 ,但是事实并不是这样的。


但是如果你使用join,就会发现真的对用户表全盘扫描了.....
关于sql中in 和 exists 的效率问题的更多相关文章
- 关于sql中in 和 exists 的效率问题,in真的效率低吗
原文: http://www.cnblogs.com/AdamLee/p/5054674.html 在网上看到很多关于sql中使用in效率低的问题,于是自己做了测试来验证是否是众人说的那样. 群众: ...
- SQL中如何使用EXISTS替代IN
原创作品,可以转载,但是请标注出处地址http://www.cnblogs.com/V1haoge/p/6385312.html 我们在程序中一般在做SQL优化的时候讲究使用EXISTS带替代IN的做 ...
- 问题:PLS-00204: 函数或伪列 'EXISTS' 只能在 SQL 语句中使用;结果:PL/SQL中不能用exists函数?
怎么写了一个语句带出这样的结果. 语句: if exists (select * from sysdatabases where name='omni') then 结果: ERROR 位于第 4 行 ...
- sql中in和exists效率问题 转自百度知道
in和existsin 是把外表和内表作hash 连接,而exists是对外表作loop循环,每次loop循环再对内表进行查询. 如果两个表中一个较小,一个是大表,则子查询表大的用exists,子查询 ...
- sql中in和exists的区别效率问题 转
in 和exists in是把外表和内表作hash 连接,而exists 是对外表作loop 循环,每次loop 循环再对内表进行查询. 一直以来认为exists 比in 效率高的说法是不准确的.如果 ...
- sql中in和exists的原理及使用场景。
在我们的工作中可能会遇到这样的情形: 我们需要查询a表里面的数据,但是要以b表作为约束. 举个例子,比如我们需要查询订单表中的数据,但是要以用户表为约束,也就是查询出来的订单的user_id要在用户表 ...
- SQL中IN和EXISTS用法的区别
结论 1. in()适合B表比A表数据小的情况 2. exists()适合B表比A表数据大的情况 当A表数据与B表数据一样大时,in与exists效率差不多,可任选一个使用. select * fro ...
- sql中in和exists的区别
in 和exists in是把外表和内表作hash 连接,而exists 是对外表作loop 循环,每次loop 循环再对内表进行查询. 一直以来认为exists 比in 效率高的说法是不准确的.如果 ...
- SQL中IN与EXISTS的区别
1.IN子句中的子查询只能返回一个字段,不允许返回多个字段,而EXISTS可以返回多个字段 2.IN返回的是某字段的值,而EXISTS返回的则是True或False,EXISTS子句存在符合条件的结果 ...
随机推荐
- linux安装svn客户端rabbitvcs
我们都知道,自从svn出道以来,很多人都预言,cvs将会被其取代.就如同他们预言maven要取代ant一样.可见,svn的流行.在Windows中,最常用到的开源免费的svn客户端就是Tortoise ...
- C#将List<>转换为Json,将DataSet转成List<T>
转换 参考:https://blog.csdn.net/u011176794/article/details/52670339 参考:https://blog.csdn.net/my98800/ar ...
- python拼接变量、字符串的3种方法
第一种,加号(“+”): print 'py'+'thon' # output python str = 'py' print str+'thon' # output python 第二种 ,空格: ...
- oracle查询数据字典的sql
使用的sql语句如下: select t1.username 用户, t2.TABLE_NAME 表名称, t3.comments 表业务含义, t2.COLUMN_NAME 字段名称, t4.com ...
- html5-table布局
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8&qu ...
- cookie中存取中文
- Java基础语法(二 )
五.运算符 *算术运算符 *赋值运算符 *关系运算符 *逻辑运算符 *位运算符 *三目运算符 算术运算符 *+,-,*,/都是比较简单的操作 *+的几种作用: 加法 正数 字符串连接符 *除法的时候要 ...
- linux 查看python安装路径,版本号
一.想要查看ubuntu中安装的python路径 方法一:whereis python 方法二:which python 二.想要查看ubuntu中安装的python版本号 python ...
- Java技术整理1---反射机制及动态代理详解
1.反射是指在程序运行过程中动态获取类的相关信息,包括类是通过哪个加载器进行加载,类的方法和成员变量.构造方法等. 如下示例可以通过三种方法根据类的实例来获取该类的相关信息 public static ...
- golang学习笔记6 beego项目路由设置
golang学习笔记5 beego项目路由设置 前面我们已经创建了 beego 项目,而且我们也看到它已经运行起来了,那么是如何运行起来的呢?让我们从入口文件先分析起来吧: package main ...