
Hadoop3.1.1源码Client详解 : Packet入队后消息系统运作之DataStreamer(Packet发送) : 主干
该系列总览: Hadoop3.1.1架构体系——设计原理阐述与Client源码图文详解 : 总览
在上一章(Hadoop3.1.1源码Client详解 : 写入准备-RPC调用与流的建立)
我们提到,在输出流DFSOutputStream创建后,DataStreamer也随之创建,并且被启动
下文主要是围绕DataStreamer进行讲解
DataStreamer是一个守护线程类,继承关系如下。
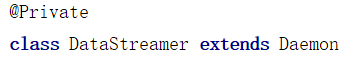
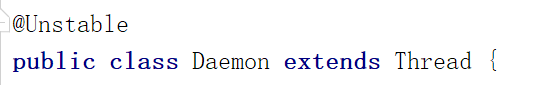
观察DataStreamer的run方法,没有意外的,我们可以发现他和普通的做法一样,用一个死循环维持线程执行,直到客户端关闭
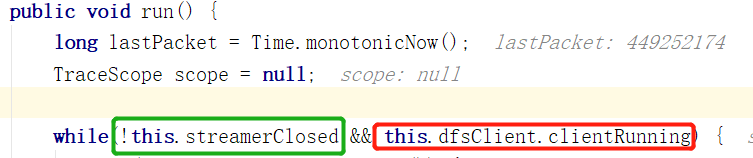
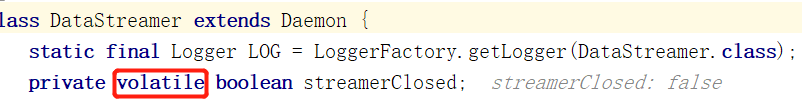
并且通过一个streamerClosed的布尔变量作为开关,控制守护线程的开启与关闭。
这个变量被volatile修饰,根据Happens-Before原则推测,其他线程通过打开或关闭这个开关,来控制DataStreamer的运作。
DataStreamer,从名字上已经能猜到,是一个控制数据传输的类
DataStreamer简要的生命周期与主要职责:
1.在DFSOutputStream被创建的时候同时被创建,并且作为一个守护线程,被主线程开启
2.DataStreamer维护一个数据队列dataQueue,并且等待主线程往这个队列放入数据包(Packet),当有数据包的时候开始工作
关于数据包是怎么来的,相关博文 : Hadoop3.1.1源码Client详解 : 入队前数据写入
3.当文件被close的时候,DataStreamer的streamerClosed开关被打开,DataStreamer使命完成
流程图:
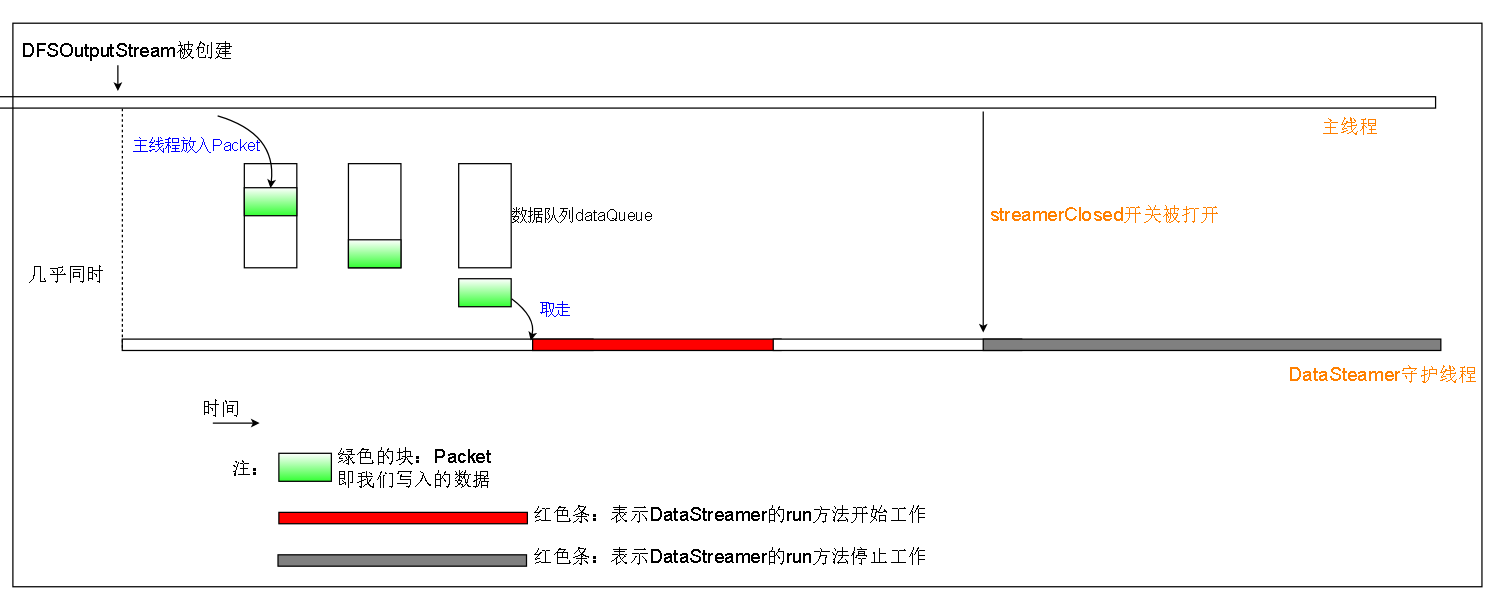
重点:分析DataStreamer的工作流程
首先我们要知道DataStreamer是一个有工作状态的守护线程,并且状态存储在stage这个成员变量中。
这个成员变量的类型是枚举BlockConstructionStage,关于这个枚举各个值的含义如下:
关于流水线(PipeLine)以及恢复(Recovery),详见:
Hadoop架构: 流水线(PipeLine)
Hadoop架构: 关于Recovery (Lease Recovery , Block Recovery, PipeLine Recovery)
以下分析的是DataStreamer的run方法
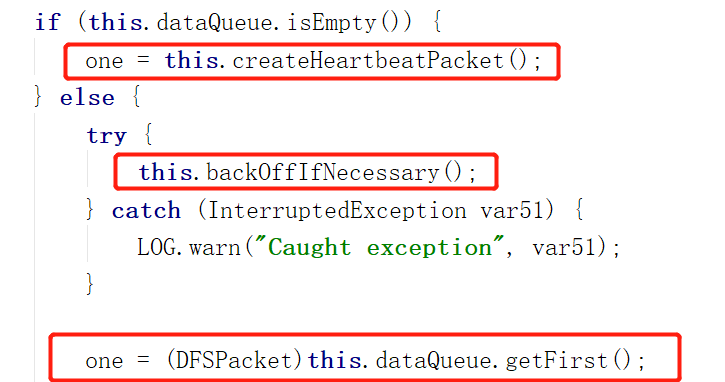
以下2张图取自DataStreamer的run方法中,DataStreamer是一个守护线程(下文有介绍),他负责在他的run方法中启动一个循环,一直监听数据队列的动静
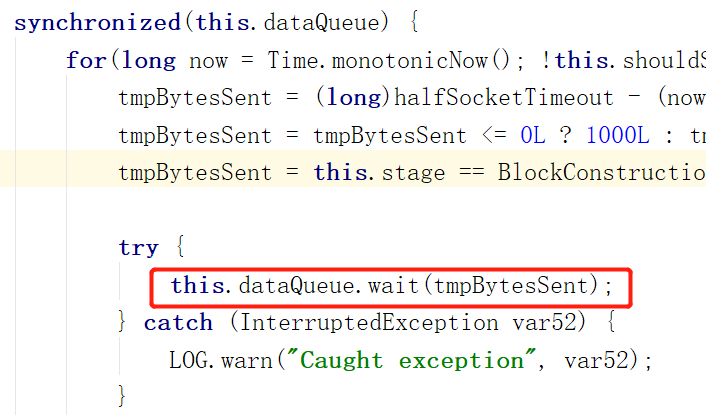
第一张图:
在run方法的while循环中锁住了dataQueue,并且内部有一个for循环,来判断是否让当前线程睡眠一段时间(tmpBytesSent)
进入for循环的条件是 (以下所有条件都要成立)
.DataStreamer不停止工作
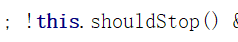
2.消息队列为空,表示暂时没有数据可传输

3.DataSteamer不处于数据传输阶段,或者数据包发送较快(未证实是否符合第二个条件意思)
如果不处于发送数据阶段,可能要发送心跳包,而后面的时间可能是用来限制心跳发送频率的。
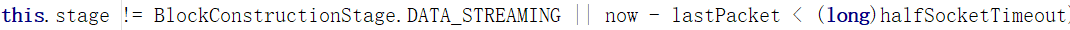
或者
.
doSleep变量为真,而这个变量取决于下图这个方法
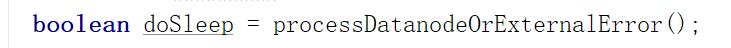
关于这个方法请见:
Hadoop3.1.1源码Client详解 : Packet入队后消息系统运作之DataStreamer(Packet发送) : 处理异常
第二张图:
第二张图告诉我们,DataStreamer首先会检查数据队列是否为空,如果是,那么发送给DataNode的将是一个心跳包,来告诉DataNode,客户端还在线(活着),
在队列不空的情况下,会检查客户端的请求是否太过频繁,导致DataNode来不及处理,如果是,则会歇一会(当前线程sleep)。
以上情况都不是的话,才是从数据队列真正获取数据包
获取数据包后做什么呢?
主要是建立起数据传输的流水线,也就是setUp Pipeline
分两种情况建立(红框)
.当前的数据需要写入新的Block。( 客户端会向NameNode申请新的Block )
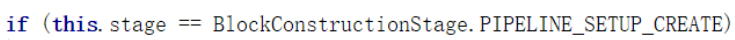
.当前数据需要写入旧有的Block(Append : 追加) 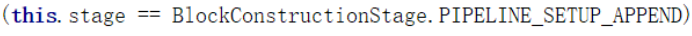
分需求架设流水线:

这里提前说一下 this.stage 这个成员变量,这个成员变量的类型是枚举
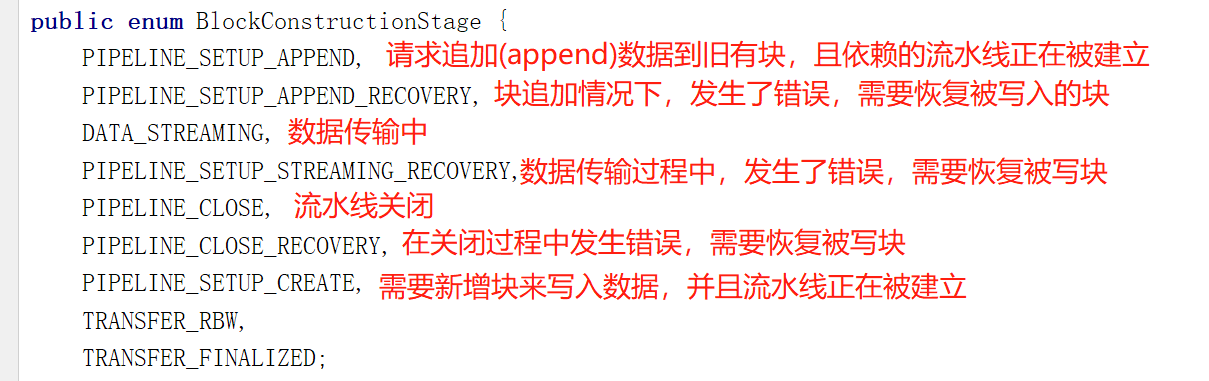
状态切换简述:当我们调用的是create方法,要新建文件的时候,stage默认是PIPELINE_SETUP_CREATE
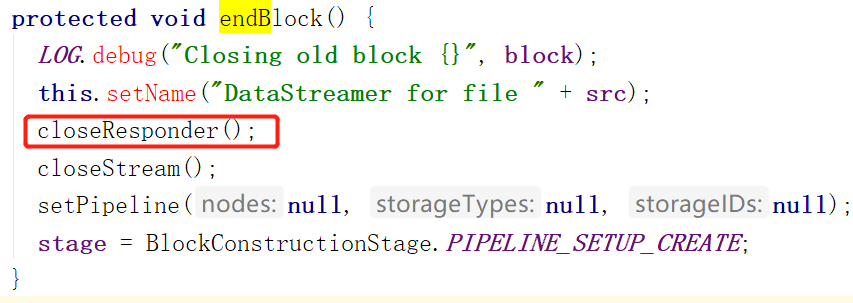
当一个块写完之后,需要添加新的块,会在上一个块end掉的时候(调用endBlock),把stage设置成PIPELINE_SETUP_CREATE,这样一来下次流水线也是被建立来创建新的块,达到添加块的目的。

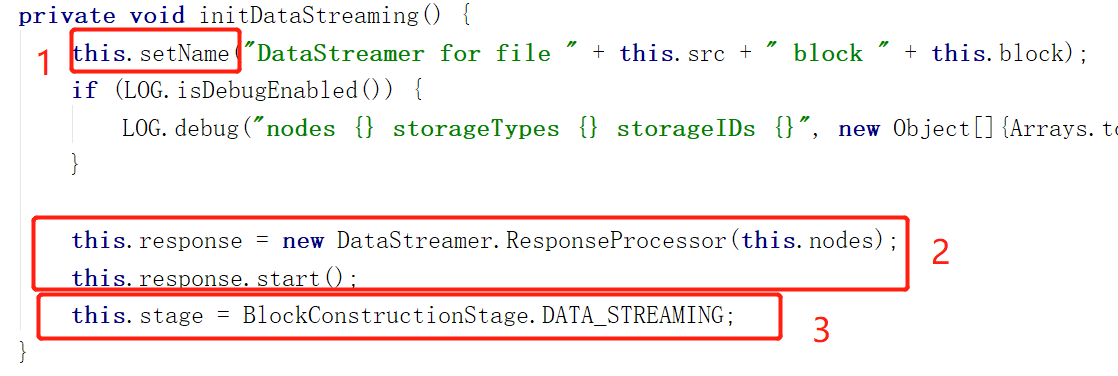
最后蓝色框告诉我们,两中情况除了流水线的建立不同,其他过程并没有什么区别。建立完流水线后共有的操作是调用initDataStreaming函数,这个为数据传输提供环境
.设置一下当前DataStream的名字(名字由当前正在传输的文件 + 当前正在传输的块组成)
.创建一个ResponseProcessor,并且开启他,这个线程负责接收DataNode发送回来的ACK(每当我们发出一个数据Packet,DataNode都需要发送ACK回复我们表示他收到了,类似TCP连接)
. 将当前DataStreamer状态设置成 DATA_STREAMING,表示正在传输数据
ResponseProcessor可以和DataStreamer线程并行工作,也就是一个负责发,一个负责收,可以同时工作。
我们来看一下ResponseProcessor是怎么处理DataNode发回来的ACK的
首先ResponseProcessor的run方法中维持着一个循环,用来接收ACK。只要ResponseProcessor不被关闭,客户端正在运行,就会一直接收ACK。
什么时候关闭呢?当调用endBlock方法的时候。也就是说每个Block在DataStreamer这对应一个ResponseProcessor来接收ACK,如果一个Block写完了,会调用endBlock把当前的ResponseProcessor
关闭并销毁。当再创建一个块,需要传输数据的时候,会再创建一个ResponseProcessor。

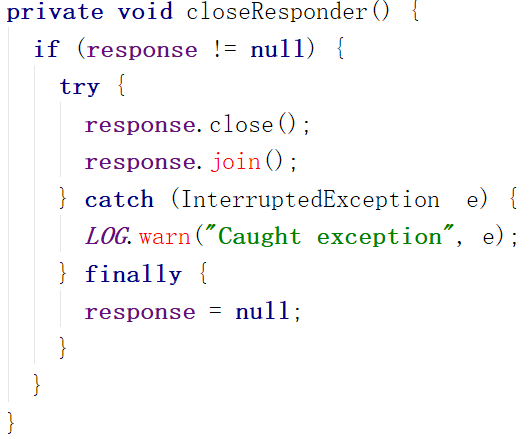
ResponseProcessor具体的工作原理,请见:Hadoop3.1.1源码Client详解 : Packet入队后消息系统运作之ResponseProcessor(ACK接收)
似乎架设流水线被忘记了。我们一 一道来
请见:
Hadoop3.1.1源码Client详解 : Packet入队后消息系统运作之DataStreamer(Packet发送) : 流水线架设 : 创建块
Hadoop3.1.1源码Client详解 : Packet入队后消息系统运作之DataStreamer(Packet发送) : 流水线架设 : 流水线恢复/append
我们接着讲DataStreamer的run方法
紧接着initDataStreaming之后:如果当前要写入流水线的Packet是最后一个包,也就是用来通知流水线上DataNode当前Block已经写完了的包。(称为lastPacket)
那么此处会等待所有lastPacket之前的Packet被确认。然后把流水线状态设置为关闭,但是此时还没有把lastPacket写到流水线上。在把lastPacket写到流水线上到客户端确认lastPacket被DataNode收到
的过程中,流水线可能失败,那么就会发生流水线关闭阶段失败的恢复。详细请见 Hadoop架构: 关于Recovery (Lease Recovery , Block Recovery, PipeLine Recovery) 的文末

接着是把Packet进行移动

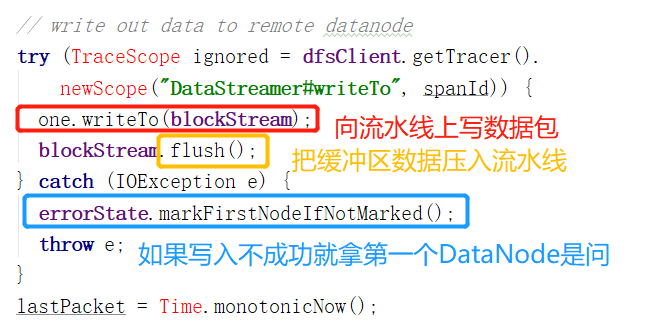
终于要把Packet写入流水线了。
如果Packet不能成功写入流水线,就会调用markFirstNodeIfNotMarked函数
markFirstNodeIfNotMarked的作用是如果流水线上没有DataNode被认为是不正常工作的。那么将会把第一个DataNode当成是不能工作的DataNode
收尾工作

DataStream从架构流水线到传输Packet的流程讲解完毕。
Hadoop3.1.1源码Client详解 : Packet入队后消息系统运作之DataStreamer(Packet发送) : 主干的更多相关文章
- Hadoop3.1.1源码Client详解 : Packet入队后消息系统运作之ResponseProcessor(ACK接收)
该系列总览: Hadoop3.1.1架构体系——设计原理阐述与Client源码图文详解 : 总览 紧接着上一篇文章: Hadoop3.1.1源码Client详解 : Packet入队后消息系统运作之D ...
- Hadoop3.1.1源码Client详解 : 入队前数据写入
该系列总览: Hadoop3.1.1架构体系——设计原理阐述与Client源码图文详解 : 总览 紧接着上一篇: Hadoop3.1.1源码Client详解 : 写入准备-RPC调用与流的建立 先给出 ...
- Hadoop3.1.1源码Client详解 : 写入准备-RPC调用与流的建立
该系列总览: Hadoop3.1.1架构体系——设计原理阐述与Client源码图文详解 : 总览 关于RPC(Remote Procedure Call),如果没有概念,可以参考一下RMI(Remot ...
- Hadoop3.1.1架构体系——设计原理阐述与Client源码图文详解 : 总览
一.设计原理 1.Hadoop架构: 流水线(PipeLine) 2.Hadoop架构: HDFS中数据块的状态及其切换过程,GS与BGS 3.Hadoop架构: 关于Recovery (Lease ...
- NopCommerce源码架构详解--初识高性能的开源商城系统cms
很多人都说通过阅读.学习大神们高质量的代码是提高自己技术能力最快的方式之一.我觉得通过阅读NopCommerce的源码,可以从中学习很多企业系统.软件开发的规范和一些新的技术.技巧,可以快速地提高我们 ...
- NopCommerce源码架构详解
NopCommerce源码架构详解--初识高性能的开源商城系统cms 很多人都说通过阅读.学习大神们高质量的代码是提高自己技术能力最快的方式之一.我觉得通过阅读NopCommerce的源码,可以从 ...
- Nop--NopCommerce源码架构详解专题目录
最近在研究外国优秀的ASP.NET mvc电子商务网站系统NopCommerce源码架构.这个系统无论是代码组织结构.思想及分层都值得我们学习.对于没有一定开发经验的人要完全搞懂这个源码还是有一定的难 ...
- vue项目打包后使用reverse-sourcemap反编译到源码(详解版)
首先得说一下,vue项目中productionSourceMap这个属性.该属性对应的值为true|false. 当productionSourceMap: true,时: 1.打包后能看到xxx ...
- linux 基础入门(8) 软件安装 rpm、yum与源码安装详解
8.软件 RPM包安装 8.1rpm安装 rpm[选项]软件包名称 主选项 -i 安装 -e卸载 -U升级 -q查找 辅助选项 -ⅴ显示过程 -h --hash 查询 -a-all查询所有安装的包 - ...
随机推荐
- LINUX使用SSH远程终端时,如何将运行时间长的程序在后台挂起,下次SSH登陆时继续使用同一个SHELL?
我在某个平台上购买了一个云服务器,LINUX操作系统无图形化界面,硬盘空间较小.虽然在平台上可以通过其自带网页版VNC界面登陆SHELL进而操控云主机,但是每次需要操控都得打开网页登陆进平台,然后再进 ...
- 《 Java 编程思想》CH07 复用类
复用代码是 Java 众多引人注目的功能之一. Java 可以通过创建类来复用代码,要在使用类的时候不破坏现有代码,有两种方式: 组合:在新的类中使用现有类的对象. 继承:按照现有类的类型来创建新类, ...
- mybatis-plus - insert
一. insert 首先看一下 insert.java 的代码: /** * <p> * 根据 ID 删除 * </p> * * @author hubin * @since ...
- mysql对表中数据根据某一字段去重
要删除重复的记录,就要先查出重复的记录,这个很容易做到 注意:这是查出所有重复记录的第一条记录,需要保留,因此需要添加查询条件,查出所有的重复记录 ) ) 然后 delete from cqssc w ...
- SVN merge(合并) 时看不到以前的已经合并过的记录的标识
今天遇到这么一个事情,merge的时候以前merge过的提交记录,咩有已合并过的标识了,就是下面这样的尾巴分叉向下的箭头 通常出现这样的情况,都是工程路径不对,检查了一下,没有问题,这些meng B ...
- IntelliJ IDEA构建多Module项目
打开IDEA 创建完成项目后,我们创建子模块 可以看到common子模块创建成功,子模块的名字大家可以根据自己的实际需求来修改 下面我们再创建子模块 给子模块起个名字 现在已经创建好多模块的项目了,下 ...
- C# 元组和值元组
C# 7.0已经出来一段时间了,大家都知道新特性里面有个对元组的优化:ValueTuple.这里利用详尽的例子详解Tuple VS ValueTuple(元组类VS值元组),10分钟让你更了解Valu ...
- NlogN复杂度寻找数组中两个数字和等于给定值
算法导论:22页2.3-7 描述一个运行时间为O(nlogn)的算法,找出n个元素的S数组中是否存在两个元素相加等于给定x值 AC解: a=[1,3,6,7,9,15,29] def find2sum ...
- 在UTF-8页面中引入编码为GBK的JavaScript文件乱码问题了
原文地址:http://js8.in/2009/12/11/%E5%AF%B9%E5%BC%95%E7%94%A8%E5%A4%96%E9%83%A8javascript%E9%A1%B5%E9%9D ...
- 第三十七篇 入门机器学习——Numpy基础
No.1. 查看numpy版本 No.2. 为了方便使用numpy,在导入时顺便起个别名 No.3. numpy.array的基本操作:创建.查询.修改 No.4. 用dtype查看当前元素的数据类型 ...