
Spark教程——(4)Spark-shell调用SQLContext(HiveContext)
启动Spark-shell:
[root@node1 ~]# spark-shell
Setting default log level to "WARN".
To adjust logging level use sc.setLogLevel(newLevel).
Welcome to
      ____              __
     / __/__  ___ _____/ /__
    _\ \/ _ \/ _ `/ __/  '_/
   /___/ .__/\_,_/_/ /_/\_\   version 1.6.0
      /_/

Using Scala version 2.10.5 (Java HotSpot(TM) 64-Bit Server VM, Java 1.8.0_131)
Type in expressions to have them evaluated.
Type :help for more information.
Spark context available as sc (master = yarn-client, app id = application_1554951897984_0111).
SQL context available as sqlContext.

scala> sc
res0: org.apache.spark.SparkContext = org.apache.spark.SparkContext@272485a6

scala> sqlContext
res1: org.apache.spark.sql.SQLContext = org.apache.spark.sql.hive.HiveContext@11c95035
上下文已经包含 sc 和 sqlContext:
Spark context available as sc (master = yarn-client, app id = application_1554951897984_0111).
SQL context available as sqlContext.
本地创建people07041119.json
{"name":"zhangsan","job number":"101","age":33,"gender":"male","deptno":1,"sal":18000}
{"name":"lisi","job number":"102","age":30,"gender":"male","deptno":2,"sal":20000}
{"name":"wangwu","job number":"103","age":35,"gender":"female","deptno":3,"sal":50000}
{"name":"zhaoliu","job number":"104","age":31,"gender":"male","deptno":1,"sal":28000}
{"name":"tianqi","job number":"105","age":36,"gender":"female","deptno":3,"sal":90000}
本地创建dept.json
{"name":"development","deptno":1}
{"name":"personnel","deptno":2}
{"name":"testing","deptno":3}
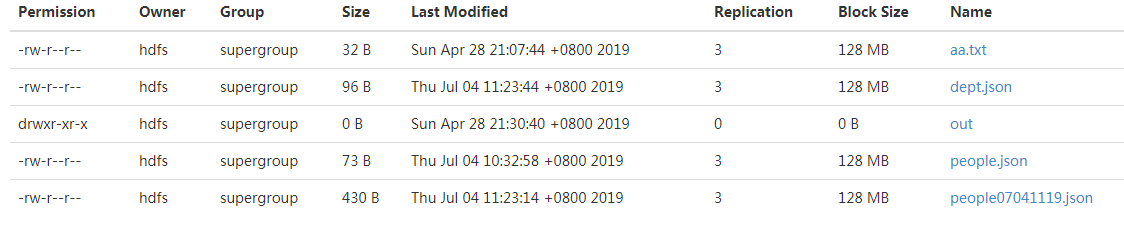
将本地文件上传到HDFS上:
bash-4.2$ hadoop dfs -put /home/**/data/people07041119.json /user/**
bash-4.2$ hadoop dfs -put /home/**/data/dept.json /user/**
结果如下:
执行Scala脚本,加载文件:
scala> val people=sqlContext.jsonFile("/user/**/people07041119.json")
warning: there were  deprecation warning(s); re-run with -deprecation for details
people: org.apache.spark.sql.DataFrame = [age: bigint, deptno: bigint, gender: string, job number: string, name: string, sal: bigint]

scala> val dept=sqlContext.jsonFile("/user/**/dept.json")
warning: there were  deprecation warning(s); re-run with -deprecation for details
people: org.apache.spark.sql.DataFrame = [deptno: bigint, name: string]
执行Scala脚本,查看文件内容:
scala> people.show
+---+------+------+----------+--------+-----+
|age|deptno|gender|job number|    name|  sal|
+---+------+------+----------+--------+-----+
| |     |  male|       |zhangsan||
| |     |  male|       |    lisi||
| |     |female|       |  wangwu||
| |     |  male|       | zhaoliu||
| |     |female|       |  tianqi||
+---+------+------+----------+--------+-----+
显示前三条记录:
scala> people.show()
+---+------+------+----------+--------+-----+
|age|deptno|gender|job number|    name|  sal|
+---+------+------+----------+--------+-----+
| |     |  male|       |zhangsan||
| |     |  male|       |    lisi||
| |     |female|       |  wangwu||
+---+------+------+----------+--------+-----+
only showing top  rows
查看列信息:
scala>  people.columns
res5: Array[String] = Array(age, deptno, gender, job number, name, sal)
添加过滤条件:
scala>  people.filter("gender='male'").count
res6: Long =
参考:
https://blog.csdn.net/xiaolong_4_2/article/details/80886371
Spark教程——(4)Spark-shell调用SQLContext(HiveContext)的更多相关文章
- spark教程(二)-shell操作
spark 支持 shell 操作 shell 主要用于调试,所以简单介绍用法即可 支持多种语言的 shell 包括 scala shell.python shell.R shell.SQL shel ...
- spark教程(八)-SparkSession
spark 有三大引擎,spark core.sparkSQL.sparkStreaming, spark core 的关键抽象是 SparkContext.RDD: SparkSQL 的关键抽象是 ...
- spark教程(11)-sparkSQL 数据抽象
数据抽象 sparkSQL 的数据抽象是 DataFrame,df 相当于表格,它的每一行是一条信息,形成了一个 Row Row 它是 sparkSQL 的一个抽象,用于表示一行数据,从表现形式上看, ...
- spark教程(四)-SparkContext 和 RDD 算子
SparkContext SparkContext 是在 spark 库中定义的一个类,作为 spark 库的入口点: 它表示连接到 spark,在进行 spark 操作之前必须先创建一个 Spark ...
- Spark教程——(11)Spark程序local模式执行、cluster模式执行以及Oozie/Hue执行的设置方式
本地执行Spark SQL程序: package com.fc //import common.util.{phoenixConnectMode, timeUtil} import org.apach ...
- spark教程
某大神总结的spark教程, 地址 http://litaotao.github.io/introduction-to-spark?s=inner
- spark教程(七)-文件读取案例
sparkSession 读取 csv 1. 利用 sparkSession 作为 spark 切入点 2. 读取 单个 csv 和 多个 csv from pyspark.sql import Sp ...
- spark教程(一)-集群搭建
spark 简介 建议先阅读我的博客 大数据基础架构 spark 一个通用的计算引擎,专门为大规模数据处理而设计,与 mapreduce 类似,不同的是,mapreduce 把中间结果 写入 hdfs ...
- Spark教程——(10)Spark SQL读取Phoenix数据本地执行计算
添加配置文件 phoenixConnectMode.scala : package statistics.benefits import org.apache.hadoop.conf.Configur ...
- 一、spark入门之spark shell:wordcount
1.安装完spark,进入spark中bin目录: bin/spark-shell scala> val textFile = sc.textFile("/Users/admin/ ...
随机推荐
- VMware15下载、安装、激活
1.VMware15下载 链接:https://pan.baidu.com/s/1bI8LReRY-5k81O3rrNgg-A 提取码:6c03 2.VMware15安装 3.VMware15激活
- JIT对锁的优化- 锁消除和锁粗化案例分析
锁消除和锁粗化案例分析 锁消除 直接上代码 /** * 描述: 锁粒度演示 * @author karl * @create 2020-02-11 14:38 */ public class MySy ...
- 翻页插件 jquery
//css <style> * { padding:; margin:; list-style: none; } .wrapper { width: 100%; cursor: point ...
- Docker安装部署ELK教程(Elasticsearch+Kibana+Logstash+Filebeat)
Elasticsearch 是个开源分布式搜索引擎,它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等. Logstash 是一个完全开 ...
- mxgraph初体验
最近公司让学习了mxgraph,简单总结一下 (1)mxGraph学习路径 1)API:http://jgraph.github.io/mxgraph/docs/js-api/files/index- ...
- intellij idea 整合springboot和mybatis
参考: http://blog.csdn.net/winter_chen001/article/details/77249029
- 【PAT甲级】1066 Root of AVL Tree (25 分)(AVL树建树模板)
题意: 输入一个正整数N(<=20),接着输入N个结点的值,依次插入一颗AVL树,输出最终根结点的值. AAAAAccepted code: #define HAVE_STRUCT_TIMESP ...
- PAT T1019 Separate the Animals
暴力搜索加剪枝,二进制保存状态,set去重~ #include<bits/stdc++.h> using namespace std; ; string s[maxn]; struct n ...
- postman 使用post方式提交参数值
参考:https://www.cnblogs.com/haoxuanchen2014/p/7771459.html
- 发送邮件#Python
import yagmailusername='11@qq.com' #发件人邮箱qq='zhezlqiggd' #授权码,QQ邮箱可在设置账户获得mail_server='smtp.qq.com' ...