
2019-05-19 Python之第一个爬虫和测试
一.使用request和get访问某个网页20次并且打印返回状态,内容
扩展:常见状态码含义 200 - 服务器成功返回网页,404 - 请求的网页不存在,403(禁止)服务器拒绝请求,404(未找到)服务器找不到请求的网页,503 - 服务器超时,3xx (重定向)
(1)request库简介:处理HTTP请求的第三方库,建立在urllib3库的基础上
(2)常用函数 get(url[,timeout = n ]), post
delete,head,options,put等等
(3)status_code返回状态。 text返回字符串形式。encoding返回编码方式。content返回二进制形式。注:response.text是解过码的字符串(比如html代码)。当requests发送请求到一个网页时,requests库会推测目标网页的编码,并对其解码,转为字符串(str)。这种方法比较容易出现乱码。
(4)实例代码
import requests

r = requests.get('https://www.sogou.com/', timeout = 4) #使用get方式请求搜狗网站

print("状态码 = {}".format( r.status_code))#输出状态码

print("text内容 = {}".format(r.text))

print("编码方式 = {}".format(r.encoding))

print("二进制形式 = {}".format(r.content))
(5)输出结果:
状态码 = 200
。。。。。。。。。。。。。。。。省略
编码方式 = UTF-8
二进制形式 = b'<!DOCTYPE。。。。。。。。。。。。省略
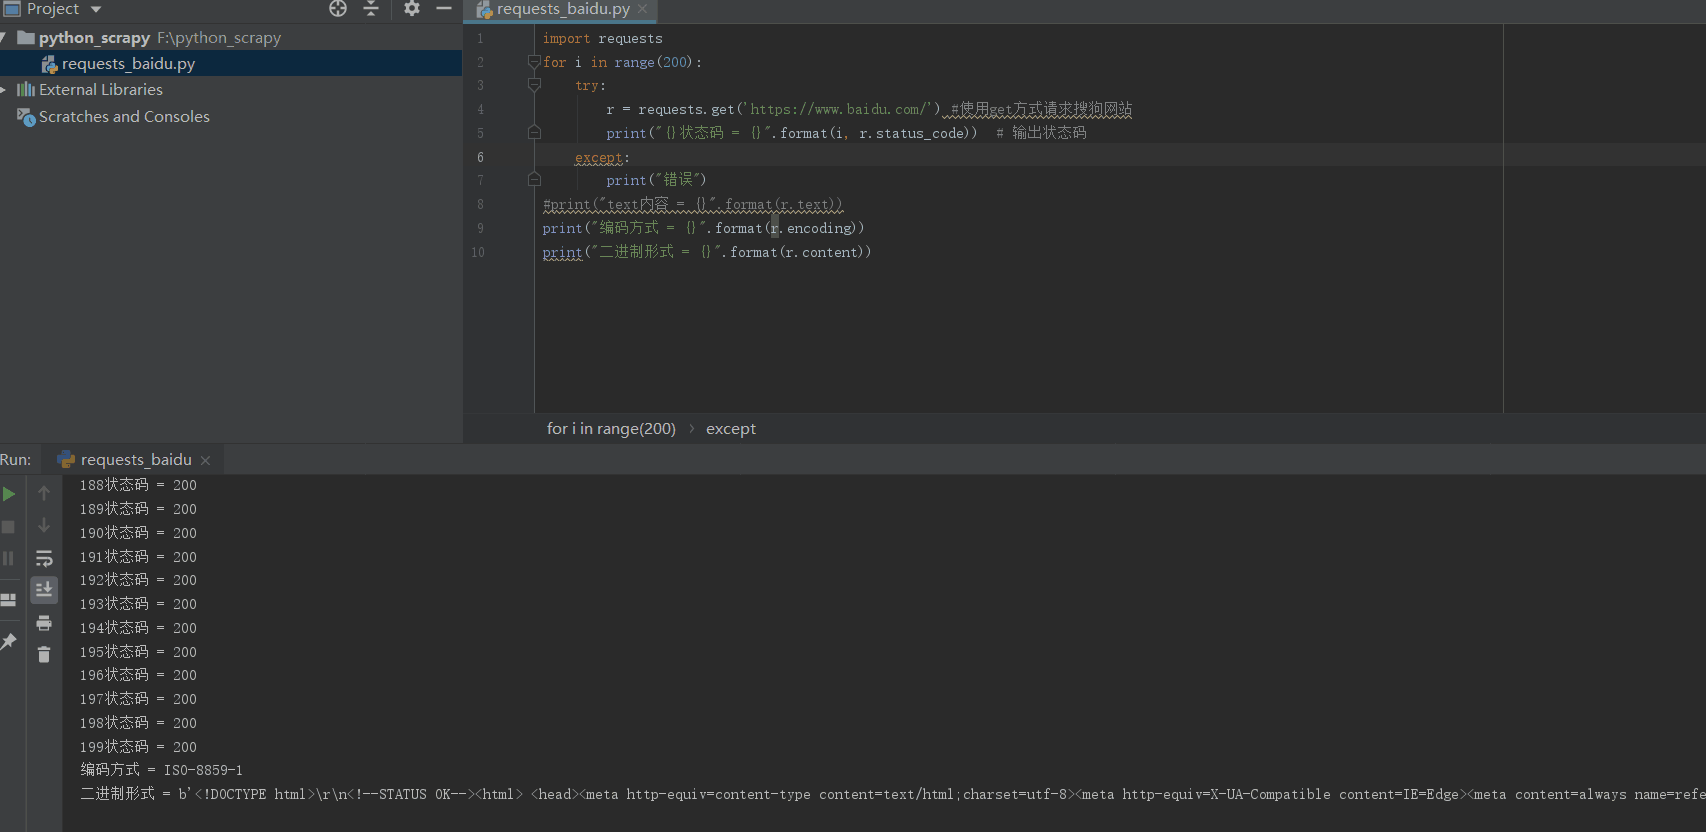
(6)测试连续访问20次的结果
import requests

for i in range(200):

    r = requests.get('https://www.baidu.com/') #使用get方式请求搜狗网站

    print("状态码 = {}".format(r.status_code))  # 输出状态码

#print("text内容 = {}".format(r.text))

print("编码方式 = {}".format(r.encoding))

print("二进制形式 = {}".format(r.content))
二.使用beautifulsoup4解析HTML页面格式,提取有用信息
(1)beautifulsoup4库的简介:解析和处理HTML和XML
(2)常用函数head获取<head>内容,title,body,p第一个<p>内容,strings所有程序在web上的字符串,即标签的内容,stripped_strings所有呈现在web上的非空字符串
(3)示例
三.爬取中国大学排名
from bs4 import BeautifulSoup

import requests

import pandas as pd

allUniv =  []

def getHTMLText(url):

    try:

        r = requests.get(url, timeout=10)

        r.raise_for_status()

        r.encoding = 'utf-8'

        return r.text

    except:

        return ""

def filUnivList(soup):

    data = soup.find_all('tr')

    for tr in data:

        ltd = tr.find_all('td')

        if len(ltd) == 0:

            continue

        singleUniv = []

        for td in ltd:

            singleUniv.append(td.string)

        allUniv.append(singleUniv)

        write_csv(allUniv)

def write_csv(list):

    name = ['排名', '学校名称', '省份', '总分', '生源质量(新生高考成绩得分)', '培养结果(毕业生就业率)', '社会声誉(社会捐赠收入·千元)', '科研规模(论文数量·篇)',\

            '科研质量(论文质量·FWCI)', '顶尖成果(高被引论文·篇)', '顶尖人才(高被引学者·人)', '科技服务(企业科研经费·千元)', '成果转化(技术转让收入·千元)', '学生国际化(留学生比例)']

    name2 = ['a', 'b', 'c']

    test = pd.DataFrame(columns=name, data=list)

    test.to_csv('e:/testcsv.csv', encoding='gbk')

def main():

    url = 'http://www.zuihaodaxue.cn/zuihaodaxuepaiming2019.html'

    html = getHTMLText(url)

    soup = BeautifulSoup(html, "html.parser")

    filUnivList(soup)

    print("完成")

main()
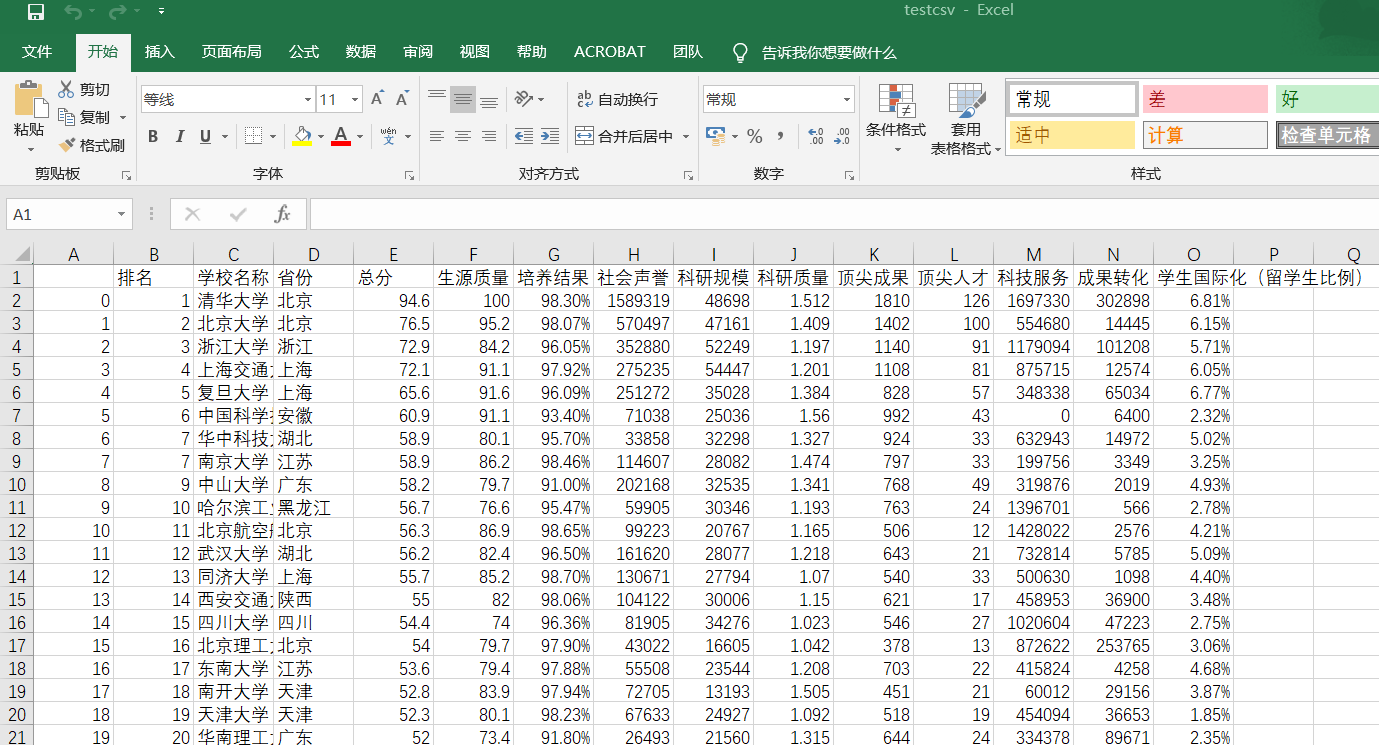
效果图:
2019-05-19 Python之第一个爬虫和测试的更多相关文章
- 孤荷凌寒自学python第八十天开始写Python的第一个爬虫10
孤荷凌寒自学python第八十天开始写Python的第一个爬虫10 (完整学习过程屏幕记录视频地址在文末) 原计划今天应当可以解决读取所有页的目录并转而取出所有新闻的功能,不过由于学习时间不够,只是进 ...
- 孤荷凌寒自学python第七十九天开始写Python的第一个爬虫9并使用pydocx模块将结果写入word文档
孤荷凌寒自学python第七十九天开始写Python的第一个爬虫9 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 到今天终于完成了对docx模块针对 ...
- 孤荷凌寒自学python第七十五天开始写Python的第一个爬虫5
孤荷凌寒自学python第七十五天开始写Python的第一个爬虫5 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 直接上代码.详细过程见文末屏幕录像 ...
- 孤荷凌寒自学python第七十四天开始写Python的第一个爬虫4
孤荷凌寒自学python第七十四天开始写Python的第一个爬虫4 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 直接上代码.详细过程见文末屏幕录像 ...
- 孤荷凌寒自学python第七十三天开始写Python的第一个爬虫3
孤荷凌寒自学python第七十三天开始写Python的第一个爬虫3 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 直接上代码.详细过程见文末屏幕录像 ...
- 孤荷凌寒自学python第七十二天开始写Python的第一个爬虫2
孤荷凌寒自学python第七十二天开始写Python的第一个爬虫2 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 直接上代码.详细过程见文末屏幕录像 ...
- 孤荷凌寒自学python第七十一天开始写Python的第一个爬虫
孤荷凌寒自学python第七十一天开始写Python的第一个爬虫 (完整学习过程屏幕记录视频地址在文末) 在了解了requests模块和BeautifulSoup模块后,今天开始真正写一个自己的爬虫代 ...
- 孤荷凌寒自学python第七十八天开始写Python的第一个爬虫8
孤荷凌寒自学python第七十八天开始写Python的第一个爬虫8 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 到今天止基本完成了对docx模块针 ...
- 孤荷凌寒自学python第七十七天开始写Python的第一个爬虫7
孤荷凌寒自学python第七十七天开始写Python的第一个爬虫7 (完整学习过程屏幕记录视频地址在文末) 今天在上一天的基础上继续完成对我的第一个代码程序的书写. 今天的学习仍然是在纯粹对docx模 ...
随机推荐
- 写了个python脚本,循环执行某一个目录下的jmeter脚本————解决的问题,每次回归时,都得一个个拉取
import os import time #需要你改的就这3个参数 #path是放你jmx脚本的文件夹路径 path="D:\\桌面\\每次都是从共享上考最新的\\" #jtl_ ...
- 跟面试官侃半小时MySQL事务隔离性,从基本概念深入到实现
提到MySQL的事务,我相信对MySQL有了解的同学都能聊上几句,无论是面试求职,还是日常开发,MySQL的事务都跟我们息息相关. 而事务的ACID(即原子性Atomicity.一致性Consiste ...
- Ubuntu和Windows双系统修复
一. 感受 新买了电脑从头安装win10和ubuntu双系统,踩了各种坑,终于是成功了. 大致流程是用老毛桃安装了window10系统,装在了固态硬盘上.随后用软碟通将Ubuntu系统写入U盘(先用老 ...
- vue 3
目录 复习 Vue项目需要自建服务器:node npm:包管理器 - 为node拓展功能的 vue cli环境:脚手架 - 命令行快速创建项目 创建Vue项目 启动项目 项目目录 组件 在根组件中渲染 ...
- mysql数据库表格之间的关系
外键 昨日内容回顾: 字段类型 约束条件 创建表的完整语法 create table 表名( 字段名 字段类型[(宽度) 约束条件], 字段名 字段类型[(宽度) 约束条件], 字段名 字段类型[(宽 ...
- Visdom 介绍 | 二
用于创建,组织和共享实时丰富数据可视化的灵活工具.支持Python. 概述 概念 设置 用法 API 注意事项 贡献 API 要快速了解visdom的功能,请查看example目录,或阅读以下详细信息 ...
- Linux虚拟机-CentOS7常用命令
1.查找虚拟机的ip地址:$ ifconfig ~inet 192.168.68.136
- [bzoj1029]建筑抢修<贪心>
题目链接:http://www.lydsy.com/JudgeOnline/problem.php?id=1029 解析:这也算bzoj中比较简单的一道题,其实想通了就是非常的简单. 这题用贪心的方式 ...
- 谈谈flex布局实现水平垂直居中
我们在这要谈的是用flex布局来实现水平和垂直居中.随着移动互联网的发展,对于网页布局来说要求越来越高,而传统的布局方案对于实现特殊布局非常不方便,比如垂直居中.所以09年,W3C 提出了一种新的方案 ...
- js对象中in和hasOwnProperty()区别
记录学习中容易混淆的一些方法. prop in object prop一个字符串类型或者 symbol 类型的属性名或者数组索引(非symbol类型将会强制转为字符串). objectName检查它( ...