
python操作kafka实践
1、先看最简单的场景,生产者生产消息,消费者接收消息,下面是生产者的简单代码。

--------------------------------------------------------------------------------

#!/usr/bin/env python

# -*- coding: utf-8 -*-

import json

from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers='xxxx:x')

msg_dict = {

    "sleep_time": 10,

    "db_config": {

        "database": "test_1",

        "host": "xxxx",

        "user": "root",

        "password": "root"

    },

    "table": "msg",

    "msg": "Hello World"

}

msg = json.dumps(msg_dict)

producer.send('test_rhj', msg, partition=0)

producer.close()

--------------------------------------------------------------------------------

下面是消费者的简单代码:

from kafka import KafkaConsumer

consumer = KafkaConsumer('test_rhj', bootstrap_servers=['xxxx:x'])

for msg in consumer:

    recv = "%s:%d:%d: key=%s value=%s" % (msg.topic, msg.partition, msg.offset, msg.key, msg.value)

    print recv

--------------------------------------------------------------------------------

下面是结果:

2、如果想要完成负载均衡,就需要知道kafka的分区机制,同一个主题,可以为其分区,在生产者不指定分区的情况,kafka会将多个消息分发到不同的分区,消费者订阅时候如果不指定服务组,
会收到所有分区的消息,如果指定了服务组,则同一服务组的消费者会消费不同的分区,如果2个分区两个消费者的消费者组消费,则,每个消费者消费一个分区,如果有三个消费者的服务组,
则会出现一个消费者消费不到数据;如果想要消费同一分区,则需要用不同的服务组。以此为原理,我们对消费者做如下修改:
———————————————————————————————————

from kafka import KafkaConsumer

consumer = KafkaConsumer('test_rhj', group_id='', bootstrap_servers=['10.43.35.25:4531'])

for msg in consumer:

    recv = "%s:%d:%d: key=%s value=%s" % (msg.topic, msg.partition, msg.offset, msg.key, msg.value)

    print recv

------------------------------------------------------------------------------------

然后我们开两个消费者进行消费,生产者分别往0分区和1分区发消息结果如下,可以看到,一个消费者只能消费0分区,另一个只能消费1分区:


3、kafka提供了偏移量的概念,允许消费者根据偏移量消费之前遗漏的内容,这基于kafka名义上的全量存储,可以保留大量的历史数据,历史保存时间是可配置的,一般是7天,如果偏移量定位到了已删除的位置那也会有问题,但是这种情况可能很小;每个保存的数据文件都是以偏移量命名的,当前要查的偏移量减去文件名就是数据在该文件的相对位置。要指定偏移量消费数据,需要指定该消费者要消费的分区,否则代码会找不到分区而无法消费,代码如下:
from kafka import KafkaConsumer

from kafka.structs import TopicPartition

consumer = KafkaConsumer(group_id='', bootstrap_servers=['10.43.35.25:4531'])

consumer.assign([TopicPartition(topic='test_rhj', partition=0), TopicPartition(topic='test_rhj', partition=1)])

print consumer.partitions_for_topic("test_rhj")  # 获取test主题的分区信息

print consumer.assignment()

print consumer.beginning_offsets(consumer.assignment())

consumer.seek(TopicPartition(topic='test_rhj', partition=0), 0)

for msg in consumer:

    recv = "%s:%d:%d: key=%s value=%s" % (msg.topic, msg.partition, msg.offset, msg.key, msg.value)

    print recv

-----------------------------------------------------------------------------------

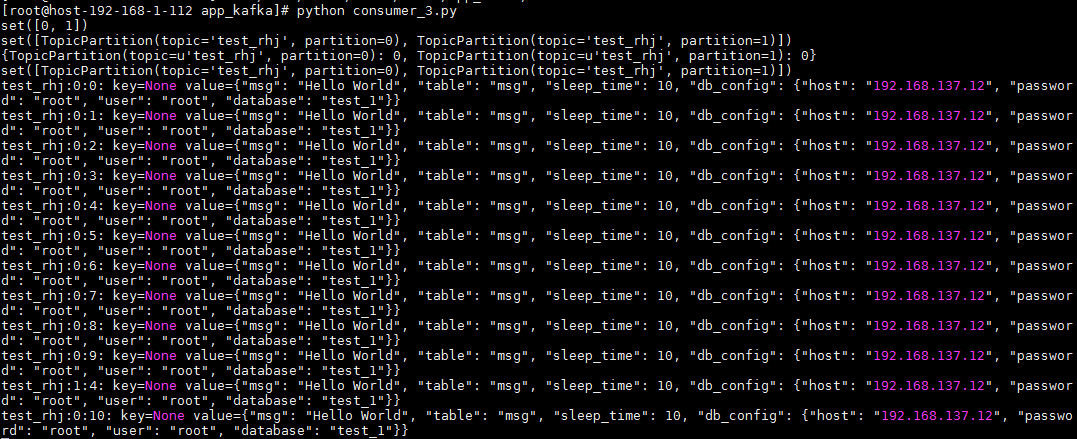
因为指定的便宜量为0,所以从一开始插入的数据都可以查到,而且因为指定了分区,指定的分区结果都可以消费,结果如下:
4、有时候,我们并不需要实时获取数据,因为这样可能会造成性能瓶颈,我们只需要定时去获取队列里的数据然后批量处理就可以,这种情况,我们可以选择主动拉取数据
from kafka import KafkaConsumer

import time

consumer = KafkaConsumer(group_id='', bootstrap_servers=['10.43.35.25:4531'])

consumer.subscribe(topics=('test_rhj',))

index = 0

while True:

    msg = consumer.poll(timeout_ms=5)  # 从kafka获取消息

    print msg

    time.sleep(2)

    index += 1

    print '--------poll index is %s----------' % index

-----------------------------------------------------------------------------------

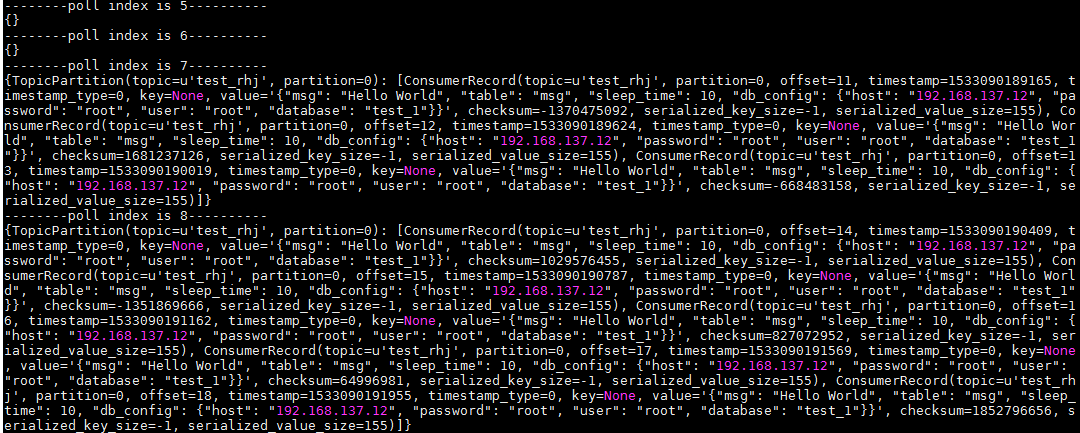
结果如下,可以看到,每次拉取到的都是前面生产的数据,可能是多条的列表,也可能没有数据,如果没有数据,则拉取到的为空:
python操作kafka实践的更多相关文章
- kfka学习笔记一:使用Python操作Kafka
1.准备工作 使用python操作kafka目前比较常用的库是kafka-python库,但是在安装这个库的时候需要依赖setuptools库和six库,下面就要分别来下载这几个库 https://p ...
- 使用python操作kafka
使用python操作kafka目前比较常用的库是kafka-python库 安装kafka-python pip3 install kafka-python 生产者 producer_test.py ...
- kafka实战教程(python操作kafka),kafka配置文件详解
kafka实战教程(python操作kafka),kafka配置文件详解 应用往Kafka写数据的原因有很多:用户行为分析.日志存储.异步通信等.多样化的使用场景带来了多样化的需求:消息是否能丢失?是 ...
- python操作kafka
python操作kafka 一.什么是kafka kafka特性: (1) 通过磁盘数据结构提供消息的持久化,这种结构对于即使数以TB的消息存储也能够保持长时间的稳定性能. (2) 高吞吐量 :即使是 ...
- Python操作rabbitmq 实践笔记
发布/订阅 系统 1.基本用法 生产者 import pika import sys username = 'wt' #指定远程rabbitmq的用户名密码 pwd = ' user_pwd = p ...
- python操作kafka(confluent_kafka 生产)
#!/usr/bin/python # -*- coding:utf-8 -*- from confluent_kafka import Producer import json import tim ...
- kafka--通过python操作topic
修改 topic 的分区数 shiyanlou:bin/ $ ./kafka-topics.sh --zookeeper localhost:2181 --alter --topic mySendTo ...
- paip.复制文件 文件操作 api的设计uapi java python php 最佳实践
paip.复制文件 文件操作 api的设计uapi java python php 最佳实践 =====uapi copy() =====java的无,要自己写... ====php copy ...
- Redis的Python实践,以及四中常用应用场景详解——学习董伟明老师的《Python Web开发实践》
首先,简单介绍:Redis是一个基于内存的键值对存储系统,常用作数据库.缓存和消息代理. 支持:字符串,字典,列表,集合,有序集合,位图(bitmaps),地理位置,HyperLogLog等多种数据结 ...
随机推荐
- python urllib2 实现大文件下载
使用urllib2下载并分块copy: # from urllib2 import urlopen # Python 2 from urllib.request import urlopen # Py ...
- Highest Frequency Letters
Given a list of strings, output the most frequent characters that are in the same group as the lette ...
- FileSystemResource 找不到文件
环境 Spring 3.2.5.RELEASE 原因 使用 FileSystemResource 加载文件的过程中,发现一个奇怪的现象,路径完全正确,但是找不到文件的情况.可能的原因是文件的路径上有压 ...
- TCP流量控制和拥塞避免
TCP的流量控制 所谓的流量控制就是让发送方的发送速率不要太快,让接收方来得及接受.利用滑动窗口机制可以很方便的在TCP连接上实现对发送方的流量控制.TCP的窗口单位是字节,不是报文段,发送 ...
- linux常用终端命令(一)终端命令格式(二)文件和目录常用命令
一.linux终端命令格式 1.终端命令格式 command [-options] [parameter] 说明: command :命令名,相应功能的英文单词或单词的缩写 [-options] ...
- CentOS7-部署kubernetes
1 环境准备 节点 主机名 IP OS Master k8s-master 192.168.57.1 centos 7 Node1 k8s-nod ...
- X86逆向2:提取按钮通杀特征码
本章我们将学习特征码的提取与定位,特征码是软件中一段固定的具有标志性的代码片段,特征码的用途非常广泛,最常见的就是杀毒软件的查杀了,查杀就是根据特征码定位技术实现的,再比如木马的免杀也是修改了特征码的 ...
- Nmap 常用命令语法
Nmap是一个网络连接端扫描软件,用来扫描网上电脑开放的网络连接端,确定哪些服务运行在哪些连接端,并且推断计算机运行哪个操作系统,正如大多数被用于网络安全的工具,Nmap也是不少黑客及骇客爱用的工具, ...
- Codeforces 1244D. Paint the Tree
传送门 首先如果某个点的度数大于 $2$ 那么显然无解 然后考虑点的度数小于等于 $2$ 的情况 发现其实是一条链 一旦确定了链开头的两个点,后面的点的颜色都可以通过之前的点推出 所以直接枚举即可 # ...
- MySQL的简介、启动及其DDL
MySQL的各项配置: 默认会启用TCP/IP网络: 默认客户端/服务器端口:3306: 将数据库的BIN目录写入Windows的的path环境变量: 默认不允许root用户在其他机器上远程登录: M ...