
Centos7.0配置Hadoop2.7.0伪分布式
一、ssh免密登录
1.命令ssh-keygen、
overwrite输入y一路回车
2.将生成的密钥发送到本机
ssh-copy-id localhost中间会询问是否继续输入“yes”
3.测试免密登录是否成功
ssh localhost
二、Java配置
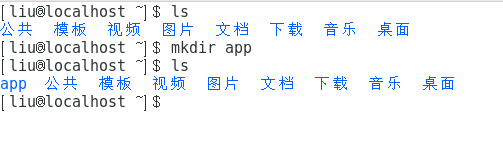
新建一个文件夹存放java和hadoop这里我在~目录下新建了一个app文件夹下面。
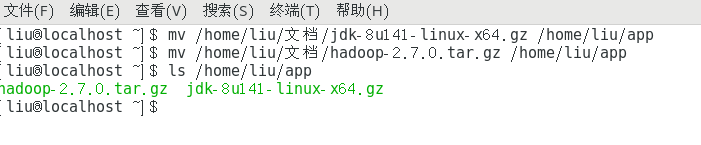
命令行移动文件到新建的app文件夹下。
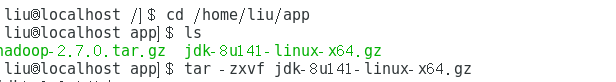
解压jdk压缩包。
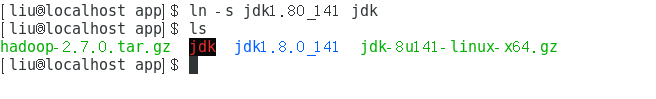
创建软连接或重命名已解压文件夹。
配置jdk环境变量。切换到root用户(输入su命令 切换root用户接着输入root用户密码),然后通过
vi /etc/profile
编辑、etc/profile文件配置环境变量。
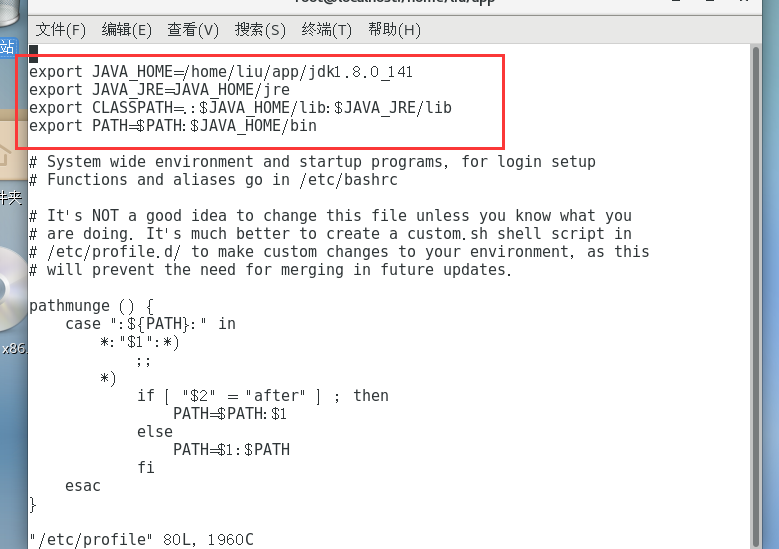
编辑好后Esc键接着“:”在输入wq保存并且退出编辑。
使/etc/profile生效,并检测是否配置成功。
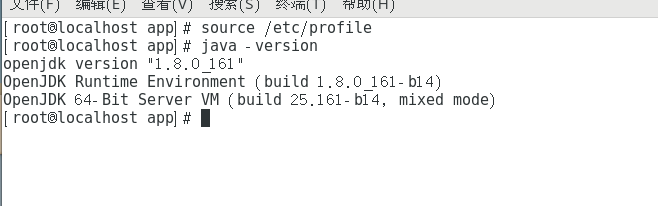
配置成功。
三、Hadoop配置
由root用户切换为普通用户,我这里用户名是liu所以使用命令 su liu。
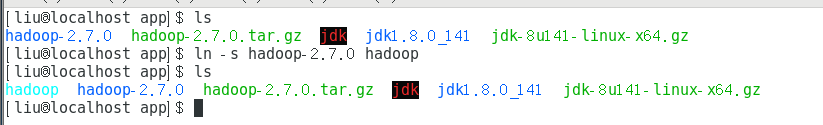
解压Hadoop然后创建软连接或者重命名。
验证单击模式Hadoop是否安装成功,hadoop/bin/hadoop version
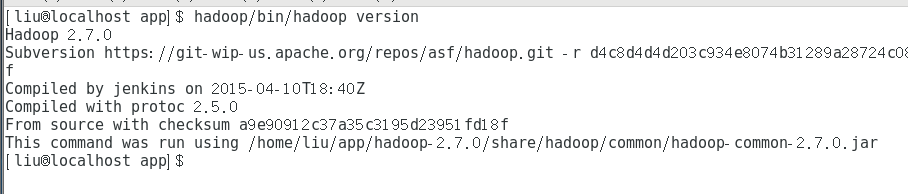
此时可以看到Hadoop版本2.7.0,安装成功。可以在hadoop目录下新建一个test.txt输入一下内容。
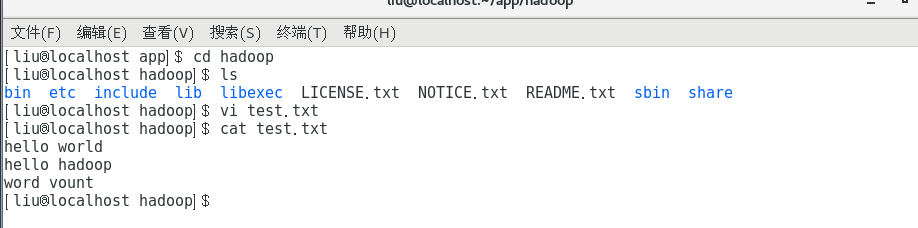
测试运行Hadoop自带的WordCount程序,统计单词个数。

查看结果文件夹output
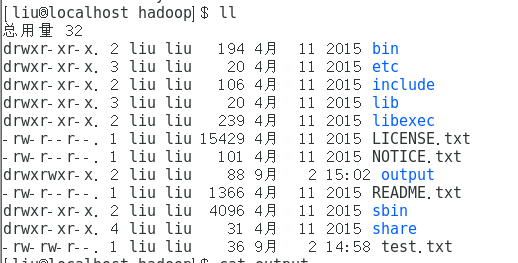
查看内容

四、Hadoop伪分布式配置
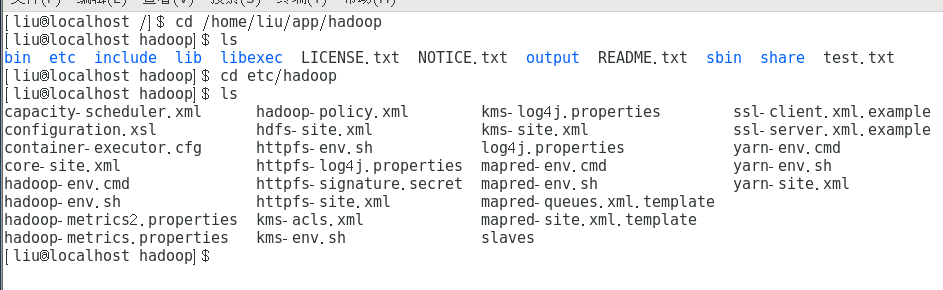
进入hadoop目录下的/etc/hadoop文件
<configuration>

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://localhost:9000</value>

    </property>

    <property>

        <name>hadoop.tmp.dir</name>

        <value>file:/data/tmp</value>

    </property>

    <property>

        <name>hadoop.proxyuser.hadoop.hosts</name>

        <value>*</value>

    </property>

    <property>

        <name>hadoop.proxyuser.hadoop.groups</name>

        <value>*</value>

    </property>

</configuration>
修改core-site.xml文件
<configuration>

    <property>

        <name>dfs.namenode.name.dir</name>

        <value>/data/dfs/name</value>

        <final>true</final>

    </property>

    <property>

        <name>dfs.datanode.data.dir</name>

        <value>/data/dfs/data</value>

        <final>true</final>

    </property>

    <property>

        <name>dfs.replication</name>

        <value>1</value>

    </property>

    <property>

        <name>dfs.permissions</name>

        <value>false</value>

    </property>

</configuration>
修改hdfs-site.xml文件
export JAVA_HOME=/home/liu/app/jdk1.8.0_141
修改hadoop-env.sh
<configuration>

    <property>

        <name>mapreduce.frameword.name</name>

        <value>yarn</value>

    </property>

</configuration>
修改mapred-site.xml.template
<configuration>

<!-- Site specific YARN configuration properties -->

    <property>

        <name>yarn.nodemanager.aux-servies</name>

        <value>mapreduce_shuffle</value>

    </property>

</configuration>
修改yarn-site.xml
配置hadoop环境在 ~/.bashrc文件下
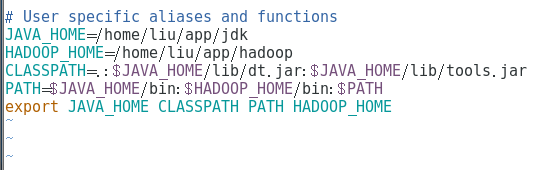
保存退出后记得source ~/.bashrc是修改生效。
然后在~下创建配置文件中的目录,
mkdir -p data/p

mkdir -p /data/dfs/name

mkdir -p /data/dfs/data
第一次需要格式化namenode,进入hadoop目录下。
cd /home/liu/app/hadoop
格式化。
bin/hdfs namenode -format
启动hadoop
sbin/start-all.sh
启动完毕后输入jps查看。
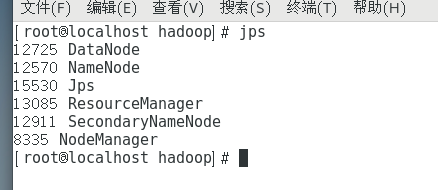
最重要的是NameNode和DataNode。这样就配置并且启动成功了。
需要注意的是如果jps后并没有则说明配置错误,请检查配置文件,若配置完环境变量后检测是否成功,提示失败并给出路径,很有可能是环境变量配置路径错误。
若第一次启动hadoop失败,后边重新启动的时候,请删除~下新建的data文件重新格式化NameNode。
Centos7.0配置Hadoop2.7.0伪分布式的更多相关文章
- Ubuntu14.04 安装配置Hadoop2.6.0
目前关于Hadoop的安装配置教程书上.官方教程.博客都有很多,但由于对Linux环境的不熟悉以及各种教程或多或少有这样那样的坑,很容易导致折腾许久都安装不成功(本人就是受害人之一).经过几天不断尝试 ...
- 在Linux(Centos7)系统上对进行Hadoop分布式配置以及运行Hadoop伪分布式实例
在Linux(Centos7)系统上对进行Hadoop分布式配置以及运行Hadoop伪分布式实例 ...
- Dockerfile完成Hadoop2.6的伪分布式搭建
在 <Docker中搭建Hadoop-2.6单机伪分布式集群>中在容器中操作来搭建伪分布式的Hadoop集群,这一节中将主要通过Dokcerfile 来完成这项工作. 1 获取一个简单的D ...
- hadoop2.6.0实践:002 检查伪分布式环境搭建
1.检查网络配置[root@hadoop-master ~]# cat /etc/sysconfig/networkNETWORKING=yesHOSTNAME=hadoop-masterGATEWA ...
- hadoop2.6.0实践:004 启动伪分布式hadoop的进程
[hadoop@LexiaofeiMaster hadoop-2.6.0]$ start-dfs.shStarting namenodes on [localhost]localhost: start ...
- 分布式配置hadoop2.5.0 2.6.x
1. sudo vim /etc/hostname 在master的机器上,改成 master 在slave上写 slave01,02,03...... 配置好后重启. 2. sudo vi ...
- 2-10 就业课(2.0)-oozie:10、伪分布式环境转换为HA集群环境
hadoop 的基础环境增强 HA模式 HA是为了保证我们的业务 系统 7 *24 的连续的高可用提出来的一种解决办法,现在hadoop当中的主节点,namenode以及resourceManager ...
- Hadoop - 操作练习之单机配置 - Hadoop2.8.0/Ubuntu16.04
系统版本 anliven@Ubuntu1604:~$ uname -a Linux Ubuntu1604 4.8.0-36-generic #36~16.04.1-Ubuntu SMP Sun Feb ...
- 在CentOS7下搭建Hadoop2.9.0集群
系统环境:CentOS 7 JDK版本:jdk-8u191-linux-x64 MYSQL版本:5.7.26 Hadoop版本:2.9.0 Hive版本:2.3.4 Host Name Ip User ...
随机推荐
- codeforces#1251E2. Voting (Hard Version)(贪心)
题目链接: http://codeforces.com/contest/1251/problem/E2 题意: 主角需要获得n个人的投票 有两种方式让某个人投票 1,已经投票的人数大于m 2,花p枚硬 ...
- Tkinter 之ListBox列表标签
一.参数说明 参数 作用 background (bg) 设置背景颜色 borderwidth (bd) 指定 Listbox 的边框宽度,通常是 2 像素 cursor 指定当鼠标在 Listbo ...
- JAVA基础知识|Serializable
一.序列化和反序列化 序列化:把对象转换为字节序列的过程称为对象的序列化. 反序列化:把字节序列恢复为对象的过程称为对象的反序列化. 将内存中对象的信息保存下来,可以有很多种方式实现这一功能.其中ja ...
- LuaJIT 之 FFI
1. FFI 教程 原文: FFI Tutorial 相关链接:OpenResty 最佳实践之 FFI 加载 FFI 库 FFI 库时默认编译进 LuaJIT 中的,但是不会默认加载或初始化.因此,当 ...
- case设计及验证:入口+页面+展示
测试个性CB问题, 功能整体结构为:入口+页面+展示 总结: 1. 产品文档为主,其次是服务端接口返回.数据结构及字段值确认.结合实际场景检查是否有遗漏或不合理. 2. 以字段为维度,每个字段的检查点 ...
- 安装openssh-server报Depends: openssh-client (= 1:6.6p1-2ubuntu2.8)错误
SFTP称作“安全的FTP”,它使用ssh文件传输协议.所以我们需要安装openssh-server ubuntu自带的有openssh-client,所以可以通过 ssh username@host ...
- Flutter移动电商实战 --(41)详细页_数据接口的调试
建立数据模型层,我们的业务逻辑分开,然后进行后台数据的调试 生成model类 json数据: { "code": "0", "message" ...
- redis json 降低性能 使用 hash
使用hashtable和hash-max-zipmap-entries内存优化和效率http://www.flyfifi.cn/blog/detail/71/
- Android简单实现滚动悬停效果
import android.content.Context; import android.support.design.widget.TabLayout; import android.suppo ...
- struts2之Action与JSP相互数据传递
package com.loaderman.crm.action; import com.loaderman.crm.entity.User; import com.loaderman.crm.ser ...